
В этом проекте я намеревался использовать наборы данных списка недвижимости AirBnB для Сиэтла в 2016 году, чтобы ответить на 3 вопроса и создать 1 прогностическую модель машинного обучения, которая могла бы быть полезной для их бизнеса:
- Вопрос 1: Какова средняя общая заполняемость всех объектов недвижимости в Сиэтле в течение года?
- Вопрос 2: платно ли быть суперхозяином? Как заполняемость, цены и отзывы SuperHost по сравнению с обычными хозяевами?
- Вопрос 3: В каких районах самый высокий уровень заполняемости?
- Прогноз: создайте модель машинного обучения для прогнозирования среднегодовой заполняемости для данного объекта недвижимости.
Ниже я объясню свои выводы для этого проекта.
Посетите репозиторий Github, чтобы увидеть данные, код и записные книжки, используемые в проекте.
3 вопроса, на которые нужно ответить
Анализ этих вопросов призван стать отправной точкой для более глубокого изучения каждой темы, чтобы мы могли получить дополнительную информацию, которую мы можем применить, чтобы помочь в управлении бизнесом.
Вопрос 1: Какова общая заполняемость Сиэтла в течение года?
Есть ли периодические сдвиги в общей загруженности AirBnB в Сиэтле в течение года, и если да, то как это выглядит? Это может помочь компании решить, когда и как проводить различные виды рекламных акций, а также работать с хостами, чтобы помочь им максимально эффективно использовать эти временные рамки.

Тенденции здесь довольно легко понять. Есть три различных периода, когда мы видим резкое нарастание оговорок, за которым следует их выравнивание. Мы внимательно рассмотрим каждый регион.
Новый год
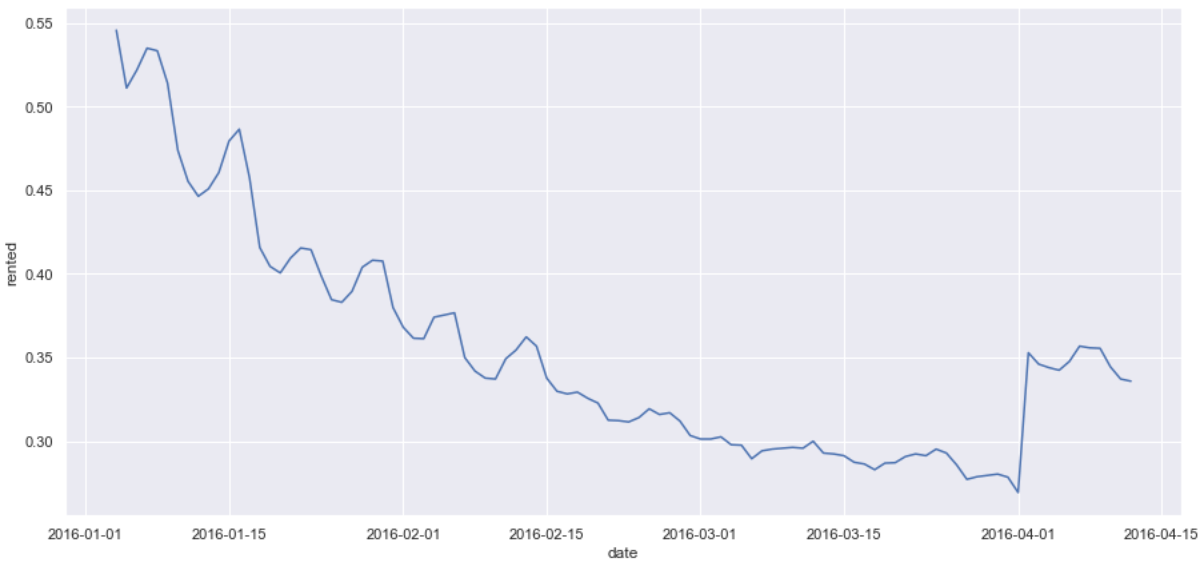
Новый год, вероятно, будет временем наибольшего всплеска загруженности AirBnB в Сиэтле, поскольку в остальное время года заполняемость никогда не приближается к этому уровню.
Весенние каникулы

При более внимательном рассмотрении временных рамок с марта по апрель мы видим всплеск в начале апреля, который, по-видимому, соответствует временным рамкам весенних каникул, что имеет смысл.
Летние каникулы

Мы снова видим всплеск посещаемости в период с июня по июль, что соответствует отсутствию учебы в школе и летним каникулам.
Праздники

Последняя тенденция несколько интересна. Резкий всплеск в конце года соответствует Новому году, но перед этим всплеском, сразу после Рождества, наблюдается довольно резкое падение.
Вопрос 2: платно ли быть суперхозяином? Как заполняемость, цены и отзывы SuperHost по сравнению с обычными хозяевами?
Superhost - это специальное название, которое автоматически присваивается объявлениям, в которых хост имеет высокие оценки во многих областях и имеет установленную положительную тенденцию в AirBnB в целом.
Я исследовал, существует ли корреляция между статусом Superhost и другими показателями, такими как заполняемость и стоимость аренды, чтобы лучше понять, эффективна ли программа Superhost для AirBnB. Наши результаты потенциально могут помочь в внесении изменений и улучшений в программу.
Как соотносятся показатели заполняемости между обычными хозяевами и суперхозяевами?
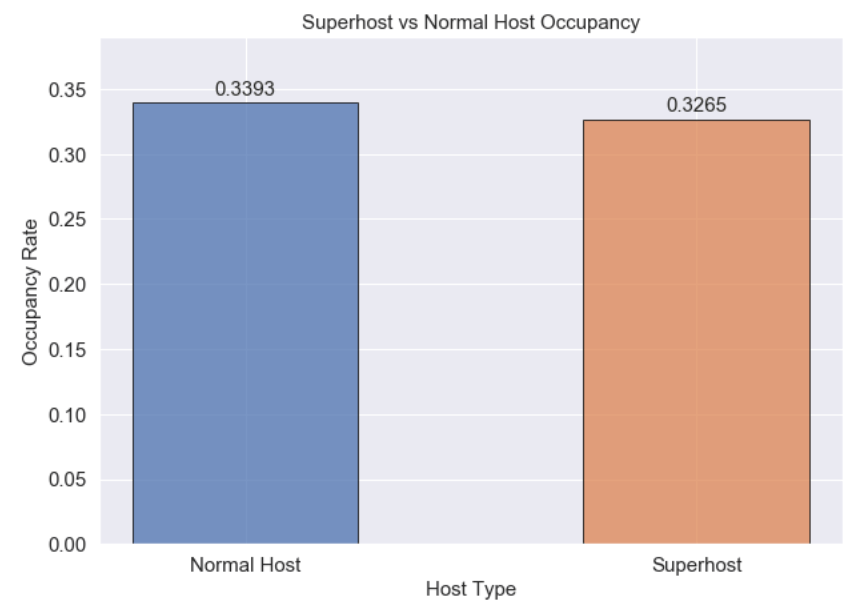
Интересно, что на самом деле, похоже, нет большой разницы между обычными хозяевами и суперхозяевами с точки зрения их способности поддерживать занятость.
Уровень загруженности для обычных хостов немного выше, но только примерно на 1,3%. Это несколько нелогично, так как можно было ожидать, что суперхозяева будут пользоваться большим спросом.
Это может поставить под сомнение эффективность программы Superhost, но это только одно средство оценки. Другие могут выявить преимущества Суперхозяев.
Как сравнивается средняя стоимость аренды между типами хостов?
Учитывая, что заполняемость примерно одинакова для обоих типов хостов, возможно, средняя цена аренды у них разная, и это область, в которой суперхозяева получают преимущество.

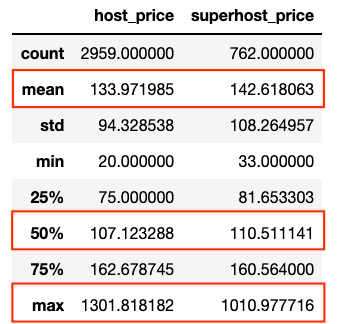
Здесь мы видим явное преимущество суперхозяев. Хотя арендная ставка суперхозяина немного ниже, чем у обычных хостов (-1,3%), средние цены на их объявления примерно на 8,2% выше.
Одно это может оправдать ваши усилия. Однако стоит также посмотреть на разброс цен. Могут быть действительно высокие выбросы цен, которые увеличивают среднюю цену.
Чем отличается распределение цен на листинги двух хостов?

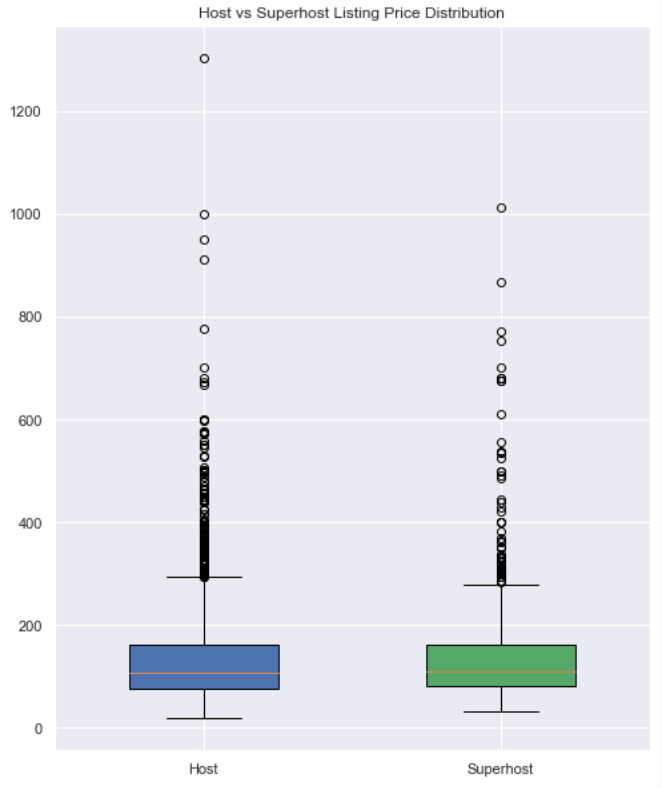
Этот график показывает форму концентрации цен на хосты и суперхозяева. Эти спреды выглядят очень похоже.
Показатели загруженности суперхозяев и хостов очень близки друг к другу, примерно в пределах 1%, при этом заполняемость обычных хостов немного выше.
Однако, как мы видели ранее, средняя цена листинга Superhost заметно выше, чем у обычного хоста, примерно на 8%.
В целом, не похоже, что необычно высокие цены на недвижимость Superhost объясняют общую более высокую цену. Похоже, что в среднем суперхозяева действительно зарабатывают больше на листинг, чем обычные хозяева.
Однако я бы порекомендовал глубже изучить эту тенденцию, чтобы увидеть, действительно ли название суперхозяина имеет значение или какой-то другой фактор.
Вопрос 3: В каких районах самый высокий уровень заполняемости?
Есть ли существенные различия в заполняемости по районам? Если мы обнаружим различия, мы сможем глубже понять, почему это так, и, возможно, извлечь полезные данные о том, что делает район более или менее привлекательным. Эту информацию можно передать хозяевам, чтобы они могли более эффективно привлекать гостей.
Вот показатели заполняемости для каждого из 81 района:
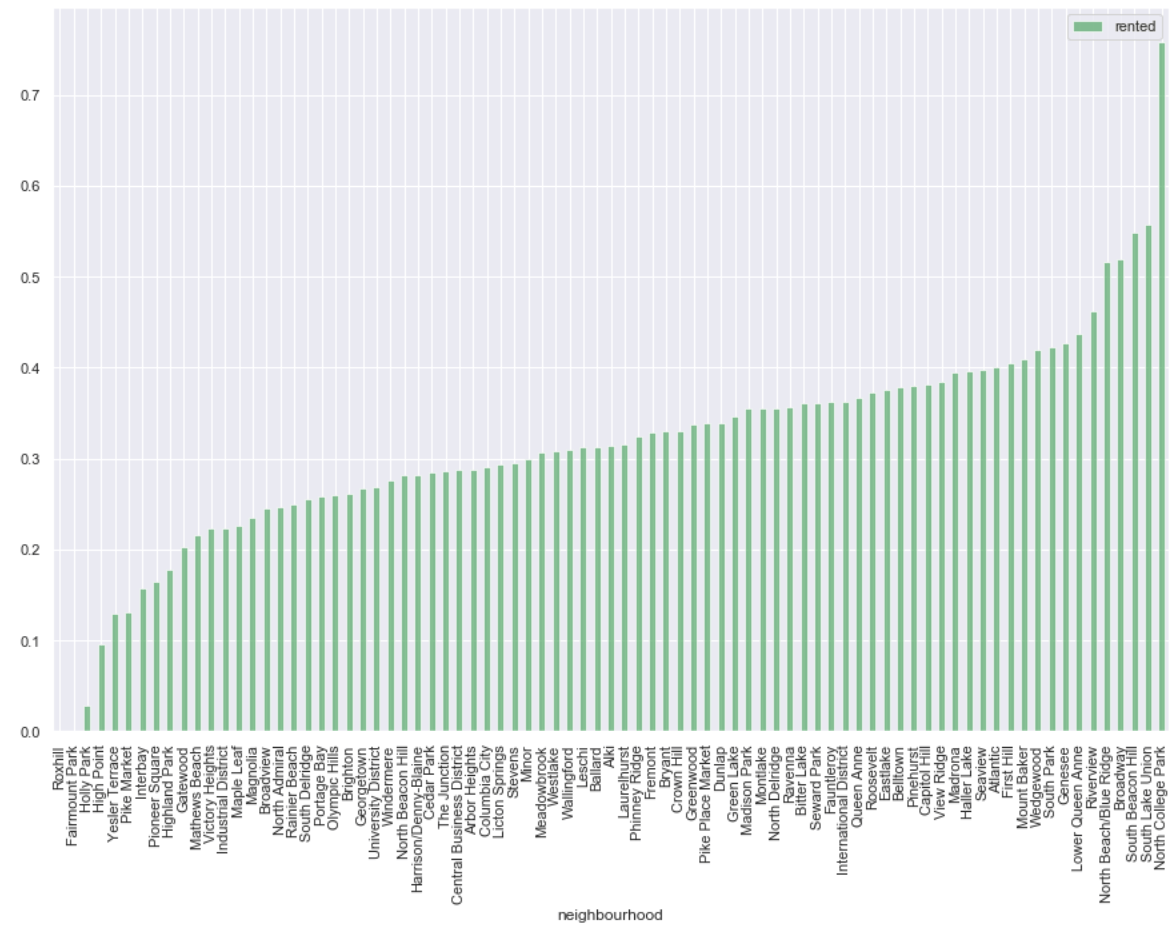
Хотя большинство из них сгруппированы в диапазоне 20–40%, есть явные примеры гораздо более высокой и гораздо более низкой загруженности.
Районы с самой высокой загруженностью
Не существует стандартного способа определения «максимальной загруженности», поэтому мы посмотрим на диаграмму выше, чтобы увидеть, где наблюдается явный всплеск для лучших исполнителей. Похоже, это резкий скачок к более чем 50% -ной заполняемости, то есть в пятерке лучших районов. Это также соответствует примерно 95-му процентилю занятости.

Цена и вместимость
Ценообразование может быть фактором заполняемости, поэтому было бы неплохо увидеть, какова взаимосвязь между заполняемостью и средней ценой объявления.

Этот график четко указывает на отсутствие связи между заполняемостью и ценой на листинге. Линия тренда почти плоская, а точки выглядят разбросанными случайным образом. Если бы была взаимосвязь, мы бы увидели более резкую восходящую диагональную линию, указывающую, что цена и заполняемость увеличиваются вместе, или нисходящую диагональную линию, указывающую, что одна из них увеличивается, а другая уменьшается.
Поскольку наиболее очевидный дифференциатор, цена, не кажется фактором заполняемости в конкретном районе, несомненно, действуют и другие факторы. Этот первоначальный анализ является хорошей отправной точкой для дальнейшего изучения других факторов, которые могут влиять на загруженность каждого района.
Моделирование
Целью моделирования машинного обучения было создание модели, которая может наилучшим образом предсказать среднегодовую заполняемость конкретного объявления для списков AirBnB в Сиэтле. Возможность эффективно прогнозировать заполняемость позволит нам изучить факторы, которые больше всего влияют на заполняемость, чтобы помочь хозяевам улучшить свои списки.
Поскольку целью является непрерывная числовая переменная, это проблема регрессии, поэтому я использовал несколько алгоритмов регрессии для ее решения. Я использовал 4 разных типа алгоритмов, чтобы попробовать чтобы найти лучшую прогностическую модель.
Показатели оценки
Я использовал среднеквадратичную ошибку (MSE), чтобы оценить, насколько хорошо работает модель. Этот показатель говорит нам, насколько далек от прогноза для конкретного листинга, и чем дальше он находится, тем больше будет число. В частности, это среднее значение квадратов разностей между прогнозируемой и фактической загруженностью. Чем больше MSE, тем слабее модель.
Кроме того, я также отслеживал время пригодности. Более длительное время подгонки означает, что для запуска модели требуется больше времени на обработку, и это может быть важным фактором при запуске модели в производство. В некоторых случаях модель с лучшими прогнозами может быть слишком ресурсоемкой или трудоемкой для эффективного использования.
Базовая модель
Установление базовой линии важно для того, чтобы эффективно оценить, насколько лучше работают обученные модели. Если она не может значительно превзойти простой базовый уровень, это не очень хорошая модель.
В этом случае я использовал прогноз по умолчанию для среднего значения всех уровней занятости в качестве базового. Это означает, что модель всегда будет предсказывать среднее значение всех уровней занятости для каждого прогноза, независимо от других факторов.
- Среднеквадратичная ошибка: 0,1178
- Fit Time: нет
Базовое значение MSE составляет 0,1178, но само по себе это невозможно интерпретировать. Нам нужно сравнить это с другими MSE, чтобы увидеть, лучше это или хуже.
Подходящее время здесь отсутствует, поскольку на самом деле никакой обработки с прогнозированием базового уровня не происходит.
Алгоритмы моделирования
Я использовал 4 различных алгоритма моделирования, чтобы попытаться найти тот, который лучше всего подходит для этого прогноза. Вот результаты подсчета очков:

Модель случайного леса имела лучший MSE из всех созданных мною моделей: 0,0992. Это 15,62% улучшение по сравнению с исходным уровнем.
Однако он также самый медленный. Это время подгонки не является большой проблемой для этого проекта, но оно может быть связано с гораздо большим набором данных и моделью, когда вы попытаетесь запустить их в производство.
Тест с лучшей моделью
Обычно наблюдается резкое падение производительности при переходе от обучения к тестированию, но к счастью, здесь этого не произошло.
- Fit Time: 7,8555
- Среднеквадратичная ошибка: 0,0994
Это удивительно отличная производительность при тестировании с MSE 0,0994 по сравнению с 0,0992. Это потеря производительности всего на 0,2%, что довольно впечатляюще, если учесть, насколько обычно может упасть производительность.
Эта MSE на 0,0994 лучше, чем базовая 0,1178, но не так сильно. Однако даже такие небольшие отличия могут быть значительными для бизнеса при запуске в производство. Я по-прежнему думаю, что есть широкие возможности для улучшения как MSE, так и времени подгонки, хотя с другими моделями и их оптимизацией.
Однако следует отметить, что случайные леса также имели худшее время соответствия, которое занимало в несколько раз больше времени, чем другие алгоритмы, о чем следует помнить.
Важность функций
Случайные леса также позволяют нам увидеть относительную важность каждой переменной, используемой для прогнозирования, что часто является тем, что нас больше всего интересует в проекте. Здесь показано, какие переменные больше всего влияют на прогнозирование годовой заполняемости.
20 основных функций

Неудивительно, что цена является наиболее важным фактором с точки зрения заполняемости, поэтому конкурентоспособное ценообразование, вероятно, приведет к лучшим результатам, хотя нам нужно будет изучить фактическую связь с ценообразованием.
Длина описаний в объявлении, по-видимому, также является важным фактором в заполняемости. Вероятно, чем длиннее ваше описание, тем выше вероятность того, что ваш объект будет сдан в аренду.
Скорость ответа хозяина, количество объявлений хозяина, а также количество кроватей, спален и ванных комнат являются дополнительными важными факторами.
Выводы по моделированию
- В конце концов, случайные леса показали лучшую производительность модели из всех опробованных методов моделирования. Он также генерирует полезные результаты, такие как важность функции, которые могут быть очень важным компонентом проекта.
- В итоге мы получили окончательную среднеквадратичную ошибку в тесте 0,0994, что на ~ 15,62% лучше, чем базовый уровень и только на 0,2% хуже, чем при проверке. , что означает, что модель, вероятно, можно надежно использовать с новыми данными. Это именно то, что мы хотим от модели.
- Хотя случайные леса действительно генерировали лучшую модель с точки зрения предсказательной силы, она была худшей с точки зрения времени предсказания. Прогнозирование занимает в несколько раз больше времени, чем другие модели. Это не является серьезной проблемой для данного проекта, но всегда необходимо учитывать.
- Хотя я исследовал ряд алгоритмов и углубился в некоторые из них, есть еще много других, которые можно использовать, и мы могли бы гораздо глубже изучить методы их оптимизации, уточнения и комбинирования, чтобы получить еще лучшую производительность.
Ресурсы
- Репозиторий GitHub - репозиторий GitHub, содержащий весь код, записные книжки и данные.
- Запись в блоге @ torinrettig.net - более подробный пост с дополнительной информацией по обработке данных и другим аспектам проекта.





