
MLPerf - это широкое сообщество, специализирующееся на тестировании машинного обучения (ML), с участием более 70 организаций (и их количество растет). Бенчмаркинг означает оценку производительности (качества, скорости, энергоэффективности и т. д.) компьютерных систем с использованием типичных рабочих нагрузок (задач, наборов данных, модели). В отличие от большинства других тестов для машинного обучения, MLPerf включает в себя как обучение, так и вывод (развертывание) практического использования машинного обучения.
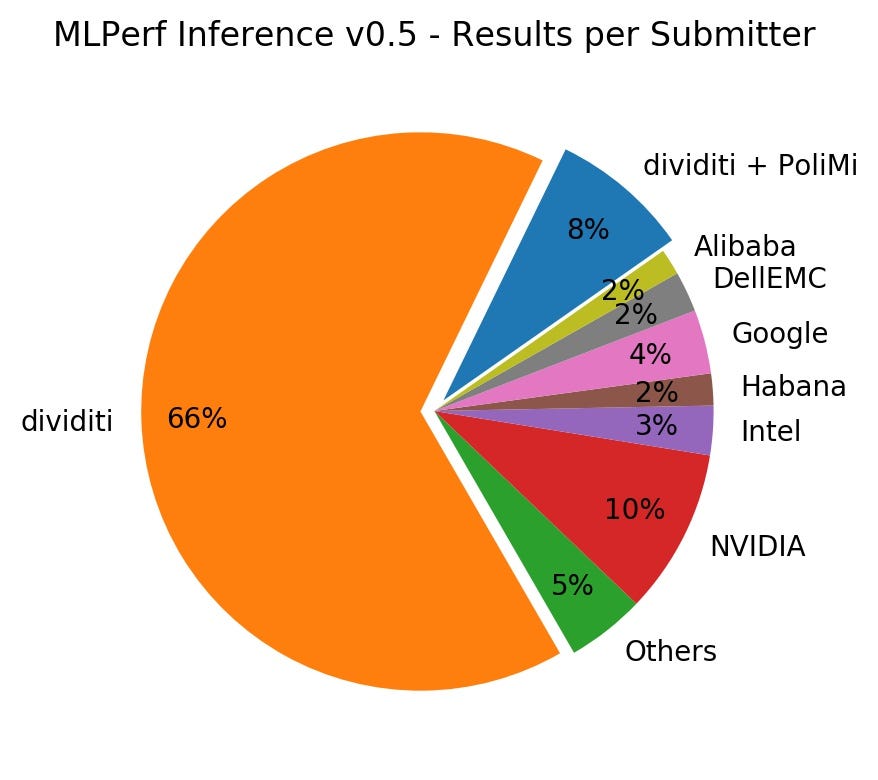
Второй раунд MLPerf Training (v0.6, результаты объявлены 10 июля 2019 года) получил заявки от Intel, NVIDIA, Google, Alibaba и Fujitsu. Первый раунд MLPerf Inference (v0.5, результаты объявлены 6 ноября 2019 г.) получил заявки от 14 организаций, в том числе от вышеуказанных компаний, Habana Labs (приобретена Intel в декабре 2019 года) и дивидити.
Таким образом, MLPerf быстро становится отраслевым эталоном для систем машинного обучения и идеальным форумом для анонса новых продуктов с результатами сравнительного анализа, которым аналитики, инвесторы и покупатели будут доверять .
Как один из основных участников MLPerf Inference, я часто отвечаю на вопросы новичков. Хотя доступен отличный технический документ, объясняющий обоснование и методологию набора тестов, вопросы, которые я получаю от потенциальных отправителей (разработчиков оборудования, поставщиков облачных услуг и т. Д.) И пользователей (покупателей, инвесторов и т. Д.), Являются более сложными. практический характер. В этом посте я начинаю отвечать на некоторые часто задаваемые вопросы.
Далее в вопросах «я» означает вас, читателя, а «мы» означает «вашу организацию»; в ответах «я» означает меня, автора, а «мы» означает «сообщество MLPerf» (но только когда я считаю, что могу говорить от имени сообщества в целом).
Почему мы должны рассмотреть возможность участия в MLPerf?
Одно слово - доверие.
Поскольку становится доступным множество вариантов ускорения машинного обучения в облаке и на периферии, взыскательные покупатели больше не удовлетворены тем, что при принятии решений о покупке полагаются исключительно на предложения продавцов и маркетинговые материалы. Вместо этого покупатели требуют от поставщиков предоставления большого количества деталей, таких как точные рабочие нагрузки и используемые варианты оптимизации, компромиссы производительности и точности, энергопотребление, зрелость инструментальной цепочки и т. Д. (Например, см. Мотивирующую презентацию General Motors на Embedded Vision Summit 2017.)
MLPerf направлен на обеспечение значимых и справедливых сравнений между системами путем согласования общей строгой методологии. В частности, все отправленные Выводы должны соответствовать строгим правилам, касающимся разрешенных преобразований модели, предварительной и последующей обработки данных и так далее. Важно отметить, что все представления Inference должны использовать так называемый LoadGen API для создания трассировок выполнения рабочих нагрузок (моделей машинного обучения) в тестируемых системах (программное обеспечение + оборудование) в одном или нескольких сценариях использования. »(Однопоточный, многопоточный, серверный, офлайн).
Теперь самое важное для создания доверия. Все материалы, представленные MLPerf, проверяются другими авторами, которые потенциально могут включать ваших прямых конкурентов. Таким образом, если ваша заявка будет рассмотрена рецензентами, ваш результат будет признан наиболее заслуживающим доверия. Это золото!
Например, три стартапа по производству оборудования, представленные на MLPerf Inference v0.5, уже воспользовались плодами с трудом заработанного доверия:
- Furiosa получила вложение в серию А в размере 7 миллионов долларов.
- Хайло получил инвестиции серии B в размере 60 миллионов долларов.
- Наконец, Habana Labs была куплена Intel за 2 миллиарда долларов.
MLPerf только для поставщиков оборудования?
Как резюмировал Linley Newsletter, материалы MLPerf Inference v0.5 поступали от поставщиков облачных услуг, поставщиков серверов, поставщиков микросхем и компаний, оказывающих профессиональные услуги. Таким образом, ответ был бы в основном да.
Однако нет предела тому, что справедливый сравнительный анализ может помочь продемонстрировать: профессиональные услуги (например, сравнительный анализ как продукт), интеллектуальную собственность (например, современные методы), навыки (например, дизайн модели и оптимизация, переподготовка), инструменты (например, компиляторы графиков) и так далее.
Хорошо, как нам запустить MLPerf?
MLPerf - это не тест, который можно просто загрузить и запустить, по крайней мере, не сегодня. (Рабочая группа MLPerf Mobile делает большие успехи в разработке Android-приложения для удобного тестирования смартфонов и планшетов, но пейзаж логического вывода машинного обучения явно намного шире, чем мобильный.)
Итак, чтобы ответить на этот вопрос, мы должны сначала рассмотреть, как работает процесс определения эталонного теста MLPerf. Рабочие группы MLPerf (Обучение или Вывод) согласовывают набор репрезентативных задач таких как классификация изображений и обнаружение объектов, а также одну или несколько типичных рабочих нагрузок (моделей) для каждой задачи. Затем один или несколько человек добровольно создают эталонную реализацию каждой рабочей нагрузки. Это помогает кристаллизовать требования к модели (например, в идеале должен быть только один источник предварительно обученных весов для вывода), набору данных проверки, метрикам производительности и точности и так далее.
Однако эталонная реализация не должна быть самой быстрой. Фактически, отправитель должен переносить рабочую нагрузку на свое целевое оборудование. Как правило, им необходимо создать новую реализацию, сочетающую MLPerf LoadGen API для выдачи запросов вывода и аппаратно-зависимый API для обработки запросов. Они по-прежнему должны имитировать предобработку и постобработку эталонной реализации, чтобы их представление соответствовало требованиям.
В основе ускоренного вывода, конечно же, лежит API-интерфейс для конкретного оборудования. Например, для MLPerf Inference v0.5 NVIDIA создала новые реализации рабочих нагрузок с помощью TensorRT, Intel - с помощью OpenVINO, dividiti - с помощью ArmNN. Согласно правилам, ускоренные реализации должны распространяться по лицензии с открытым исходным кодом, позволяющей проводить бенчмаркинг.
Конечно, создание новых реализаций, совместимых с MLPerf, требует значительных усилий со стороны отправителей, но это необходимо для достижения доверия. Хорошая новость заключается в том, что усилия должны окупаться за несколько раундов подачи заявок. Это также может вдохновить на более широкий бенчмаркинг, проводимый сообществом для других платформ, рабочих нагрузок, наборов данных и так далее.
MLPerf Inference касается только рабочих нагрузок компьютерного зрения?
Нисколько! Это правда, что из 5 рабочих нагрузок, использованных в раунде v0.5, 4 были для задач Компьютерное зрение классификации изображений и обнаружения объектов. Однако для раунда v0.7 вводятся новые задачи, такие как Обработка естественного языка, Распознавание речи и Рекомендации. Резко увеличена и сложность логического вывода: с 25 миллионов параметров в ResNet50 до 25 миллиардов параметров в DLRM.
Что, если любимая рабочая нагрузка моего клиента не является частью MLPerf Inference?
Если вы потенциальный отправитель, возможно, вы уже выполнили сравнительный анализ для своего клиента, используя его любимую рабочую нагрузку. Даже если эта рабочая нагрузка не является частью MLPerf Inference, вы можете повторно использовать усилия, которые вы приложили для оптимизации этой рабочей нагрузки, и продемонстрировать свое решение при двух условиях:
- Рабочая нагрузка по-прежнему должна выполнять одну из задач, определенных в MLPerf Inference. Например, вы можете использовать другую модель Обнаружение объектов.
- Вы должны подать заявку в Открытый отдел MLPerf Inference. Хотя в открытом дивизионе некоторые правила смягчаются (например, можно выбрать произвольную модель или переобучить модель из закрытого подразделения), ваша заявка должна по-прежнему использовать LoadGen API и соответствовать формату отправки.
Что, если моя любимая рабочая нагрузка не является частью MLPerf Inference?
Если у вас есть любимая рабочая нагрузка (на самом деле, возможно, единственная рабочая нагрузка, которая вам действительно небезразлична!), Вы также можете использовать строгую методологию MLPerf для оценки своих потенциальных поставщиков. Теоретически вам просто нужно подтолкнуть их к получению результатов, соответствующих MLPerf, и наблюдать за развитием конкуренции. На практике они могут не сдвинуться с места, особенно если они ограничены в ресурсах или если ваш запрос не считается достаточно высоким приоритетом. В этом случае вы все равно можете оценить их самостоятельно или обратиться за помощью к надежному третьему лицу.
Другие заслуживающие внимания случаи выхода за рамки формальной структуры MLPerf включают закрытый конкурентный анализ (например, для обоснования внутренних расходов на НИОКР) или публичный маркетинг (например, для поддержки выпуска вашего продукта вне цикла с помощью MLPerf раундов подачи). В последнем случае обязательно соблюдайте Условия использования MLPerf. Опять же, подумайте о том, как повысить достоверность ваших утверждений в стиле MLPerf- с полной прозрачностью и объективностью.
В этом посте я попытался развеять ауру таинственности, окружающую MLPerf Inference, для потенциальных авторов и пользователей этого теста. Но так как я едва коснулся поверхности, пожалуйста, не стесняйтесь обращаться к мне с дополнительными вопросами, и я постараюсь ответить на них в будущих публикациях.
Один из вопросов, который возникает постоянно, - это вопрос об усилиях и затратах на тщательный сравнительный анализ. Проводя параллели с разработкой программного обеспечения, это действительно может стоить в несколько раз дороже, чем специальные подходы. Автоматизация рабочего процесса станет ключом к тому, чтобы сделать строгий бенчмаркинг машинного обучения (для различного оборудования, программного обеспечения, рабочих нагрузок, наборов данных и т. Д.) Доступным для всех, не ставя под угрозу надежность и доверие.





