
"Искусственный интеллект"
Эта модель может создавать поэзию из изображений
mGAN от Microsoft проливают свет на то, как нейронные сети могут имитировать высочайшие проявления человеческого искусства.

Недавно я запустил образовательный информационный бюллетень, посвященный ИИ, у которого уже более 100 000 подписчиков. TheSequence — это информационный бюллетень, ориентированный на машинное обучение, без BS (то есть без шумихи, без новостей и т. д.), чтение которого занимает 5 минут. Цель состоит в том, чтобы держать вас в курсе проектов машинного обучения, научных работ и концепций. Пожалуйста, попробуйте, подписавшись ниже:
Креативность долгое время считалась одним из когнитивных навыков человека, который будет невероятно сложно воспроизвести искусственному интеллекту. В спектре творчества поэзия считается одним из самых чистых и менее понятных видов творческого мышления. Создание поэзии основано на сочетании многих различных когнитивных навыков, таких как абстрактное мышление, символизм, эмоции, исключительное языковое манипулирование и многие другие области, которые почти не изучены нейронаукой. Как мы определяем поэтический язык и что вдохновляет поэзию? Если мы едва сможем ответить на эти вопросы, представьте, насколько сложно было бы воссоздать поэзию в системах ИИ. Что ж, на прошлой неделе группа исследователей из Microsoft опубликовала исследовательскую работу, в которой предлагается очень творческий метод глубокого обучения для создания поэтического языка из изображений.
Проблемы нейросетевой поэзии
Генерация естественного языка из изображений — это область, которая привлекла большое внимание в сообществе глубокого обучения. Однако по сравнению с субтитрами и перефразированием изображений создание поэтического языка из изображения является очень сложной задачей. В основном это связано с разрывом между конкретным образом и поэтическими символами, которые могут способствовать созданию стихов. Для нейросети с субтитрами человек на изображении — это просто человек, но с поэтической точки зрения он может представлять множество символов: «надежда», «человечность», «будущее»….
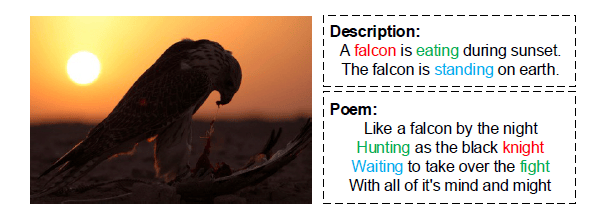
С точки зрения глубокого обучения процесс создания поэзии из изображения сопряжен с тремя основными проблемами:
а) Кросс-модальность. Эта проблема возникает из-за разрыва между извлечением тем из изображений и использованием этих тем в качестве поэтических символов. Интуитивно понятный способ создания стихотворения из изображений состоит в том, чтобы сначала извлечь ключевые слова или подписи из изображений, а затем рассматривать их как исходные элементы для создания стихотворения, как это делает генерирование стихотворения из тем. Однако ключевые слова или подписи будут упускать много информации в изображениях, не говоря уже о поэтических подсказках, которые важны для создания стихотворения.
б) Субъективность: по сравнению с подписями к изображениям и абзацами изображений создание стихотворения из изображений является более субъективной задачей, что означает, что изображение может относиться к нескольким стихотворениям с разных сторон, описание фактов на изображениях и приводит к подобным предложениям.
c) Поэмный стиль. Существуют сотни поэтических стилей, которые сочетают в себе различные паттерны, такие как ритм, размер или структура стиха. В результате задача оценки качества стихотворения остается весьма субъективной.
Внутри модели образ-поэзия
Чтобы решить вышеупомянутые проблемы, команда Microsoft Research использовала методы обучения с несколькими противниками с помощью градиента политик. Мульти-состязательные нейронные сети (mGAN) расширяют основные принципы состязательных сетей (GAN) на множественные дискриминаторы. Модель глубокого обучения Microsoft состоит из двух основных частей:
1) Глубоко связанная модель визуально-поэтического встраивания для изучения поэтических репрезентаций на основе изображений.
2) Многосостязательная процедура обучения, оптимизированная градиентом политики. Генератор на основе RNN служит агентом, а две дискриминационные сети обеспечивают вознаграждение за градиент политики.
Объединив эти два элемента, Microsoft создала архитектуру нейронной сети, которая очень умным образом сочетает сверточные, рекуррентные и состязательные нейронные сети.
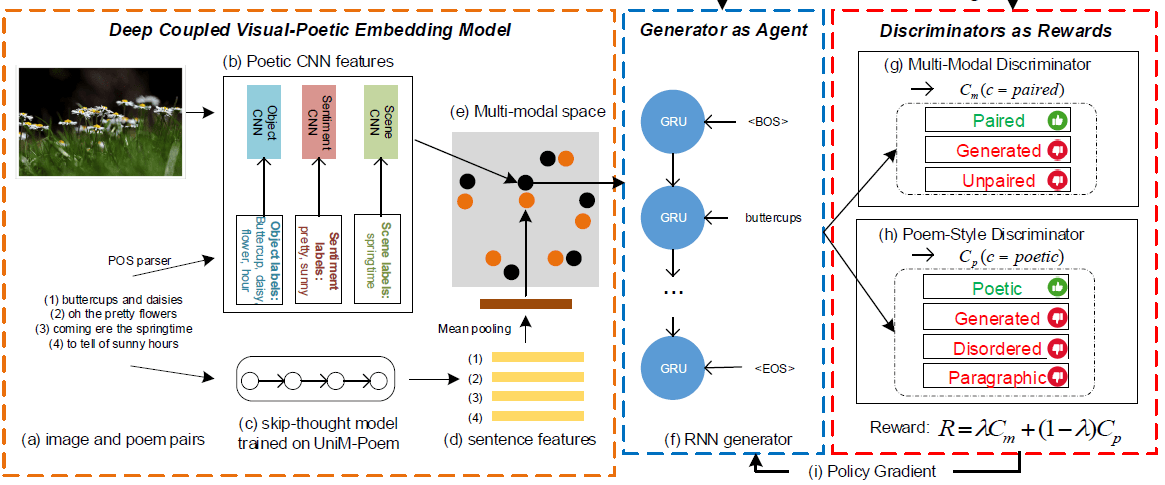
В модели, показанной на предыдущем рисунке, глубоко связанное визуально-поэтическое встраивание обучается с помощью аннотированных пар изображение-стихотворение. Модель использует CNN, чтобы научиться сопоставлять особенности изображения с поэтическими символами. Следующий слой в модели представляет собой предложение на основе RNN, сгенерированное двумя дискриминаторами (мультимодальным и в стиле стихотворения), которые производят различные вознаграждения в зависимости от качества сгенерированного предложения.
Давайте рассмотрим некоторые компоненты архитектуры более подробно.
Глубокая пара визуально-поэтического встраивания
Цель модели глубокого парного визуально-поэтического встраивания (DCVPE) состоит в том, чтобы изучить пространство встраивания, в которое можно спроецировать точки различных модальностей, изображений и предложений. Для этого DCVPE использует три разных CNN для объектов, сцен и настроений, что помогает сократить разрыв между темами изображения и поэзией. Полученные вложения используются для обучения следующего компонента архитектуры нейронной сети: генератора стихотворений.
Генератор стихов
Генеративная модель включает в себя CNN для кодировщика изображений и RNN для декодера стихотворения. По-видимому, причина использования RNN вместо CNN для языков заключается в том, что он может лучше кодировать зависящую от структуры семантику длинных предложений, которые широко наблюдаются в стихах. Коэффициенты генератора на выходе и вознаграждение, генерируемые двумя разными дискриминаторами, используются для улучшения качества поэзии.
Дискриминаторы
Любое стихотворение, созданное слоем генератора, должно удовлетворять двум основным критериям:
1) Соответствие входному изображению.
2) Правильная поэтическая структура, включая такие факторы, как правильная длина, языковой стиль стихотворения и соответствие между предложениями.
Для оптимизации этих элементов модель Microsoft включает два разных дискриминатора:
а) Мультимодальный дискриминатор: Мультимодальный дискриминатор используется для направления сгенерированного стихотворения, связанного с соответствующим изображением. Он обучен классифицировать стихотворение на три класса: парные как положительные примеры, непарные и сгенерированные как отрицательные примеры.
b) Дискриминатор стиля стихотворения. Целью дискриминатора стиля стихотворения является приведение сгенерированного стихотворения в соответствие с поэзией, написанной человеком. Дискриминатор разделит стихотворение на четыре класса: сгенерированные стихи будут классифицированы на четыре класса: поэтические, неупорядоченные, абзацные и сгенерированные.
Поэт в машине
Использование многосостязательного обучения для создания поэзии оказалось очень умным подходом к решению этой проблемы. Команда Microsoft оценила свою модель создания поэзии с помощью различных наборов данных изображений и дала выдающиеся результаты. Давайте посмотрим на стихотворение, созданное из следующего изображения:
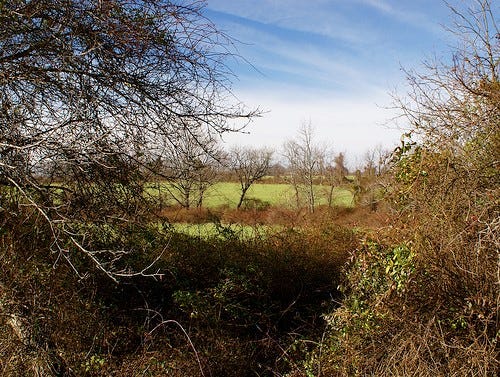
Солнце светит
Ветер дует
Голые деревья
Ты танцуешь
Сгенерированное стихотворение имеет все составляющие человеческой поэзии. Он двусмысленный, метафоричный и в нем есть какая-то красота. Поэзия вознаграждается как одна из самых чистых форм человеческого творчества, но, читая это стихотворение, созданное искусственным интеллектом, мы можем надеяться, что однажды машины сравняются с нашими поэтическими способностями.





