Добро пожаловать в третий базовый алгоритм классификации контролируемого обучения. Деревья решений. Как и предыдущие главы (Глава 1: Наивный Байесов и Глава 2: Классификатор SVM), эта глава также разделена на две части: теория и упражнение по программированию.
В этой части мы обсудим теорию и работу за деревьями решений. Мы увидим некоторые математические аспекты алгоритма, то есть увеличение энтропии и информации. Во второй части мы модифицируем код классификации спама для классификатора дерева решений в библиотеке sklearn. Мы сравним точность по сравнению с наивным байесовским методом и SVM.

0. Мотивация
Предположим, у нас есть следующий график для двух классов, представленных черным кружком и синими квадратами. Можно ли провести единую разделительную линию? Возможно, нет.

Для разделения на классы нам понадобится более одной строки. Что-то похожее на следующее изображение:
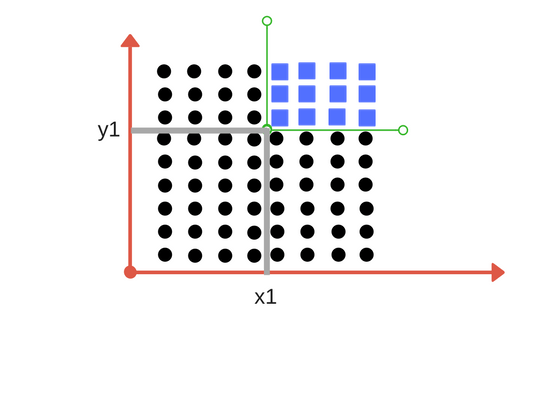
Здесь нам нужны две строки, одна разделяет их в соответствии с пороговым значением x, а другая - с пороговым значением y.
Как вы уже догадались, какое дерево решений пытается сделать.
Классификатор дерева решений, многократно делит рабочую область (график) на части, определяя линии. (неоднократно, потому что могут быть две удаленные области одного класса, разделенные другим, как показано на изображении ниже).

Итак, когда это закончится?
- Либо он разделен на чистые классы (содержащие только члены одного класса)
- Некоторые критерии атрибутов классификатора соблюдены.
Мы скоро увидим эти два момента.
В следующих разделах мы определяем несколько терминов, связанных с деревом решений, а затем выполняем эти вычисления на примере примера.
1. Примесь
В приведенном выше разделе у нас было четкое разделение классов. Но что, если бы у нас был следующий случай?
Нечистота - это когда у нас есть следы разделения одного класса на другой. Это может возникнуть по следующей причине
- У нас заканчиваются доступные функции, на которые можно разделить класс.
- Допускаем некоторый процент примесей (прекращаем дальнейшее деление) для более быстрой работы. (Всегда есть компромисс между точностью и производительностью).
Например, во втором случае мы можем остановить наше деление, когда у нас останется на x меньшее количество элементов. Это также известно как примесь джини.
2. Энтропия
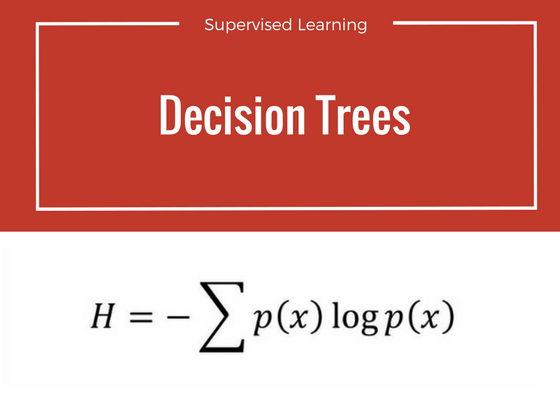
Энтропия - это степень случайности элементов или, другими словами, это мера примеси. Математически это может быть вычислено с помощью вероятностей элементов как:
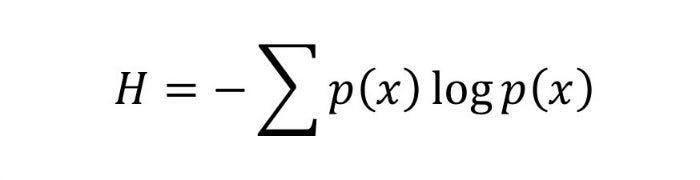
Это отрицательная сумма вероятности, умноженная на логарифм вероятности элемента x.
For example,
if we have items as number of dice face occurrence in a throw event as 1123,
the entropy is
   p(1) = 0.5
   p(2) = 0.25
   p(3) = 0.25
entropy = - (0.5 * log(0.5)) - (0.25 * log(0.25)) -(0.25 * log(0.25)
        = 0.45
3. Получение информации
Предположим, у нас есть несколько функций для разделения текущего рабочего набора. Какую характеристику выбрать для разделения? Возможно, тот, который дает нам меньше нечистоты.
Предположим, мы разделим классы на несколько ветвей следующим образом, прирост информации в любом узле определяется как
Information Gain (n) =
  Entropy(x) — ([weighted average] * entropy(children for feature))
Это требует небольшого пояснения!
Предположим, у нас есть следующий класс, с которым мы начнем работать
112234445
Предположим, мы разделим их на основе свойства: делится на 2
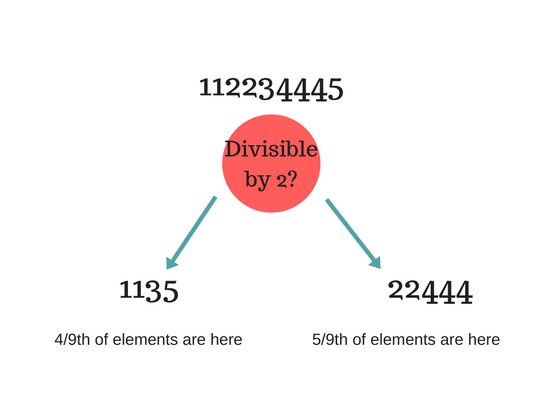
Entropy at root level : 0.66
Entropy of left child : 0.45 , weighted value = (4/9) * 0.45 = 0.2
Entropy of right child: 0.29 , weighted value = (5/9) * 0.29 = 0.16
Information Gain = 0.66 - [0.2 + 0.16] = 0.3
Проверьте, какую информацию мы получим, если примем решение в виде простого числа вместо деления на 2. Какое из них лучше для этого случая?
Дерево решений на каждом этапе выбирает то, которое дает лучший информационный сбор. Значение 0 означает, что функция вообще не разделяет рабочий набор.
Если вам это нравится, нажмите значок сердца (❤) и расскажите о себе.
Давайте решим пример
Теперь, когда вы знаете основы дерева решений, давайте рассмотрим пример и посмотрим, как оно работает.
Предположим, у нас есть следующие данные для игры в гольф в различных условиях.
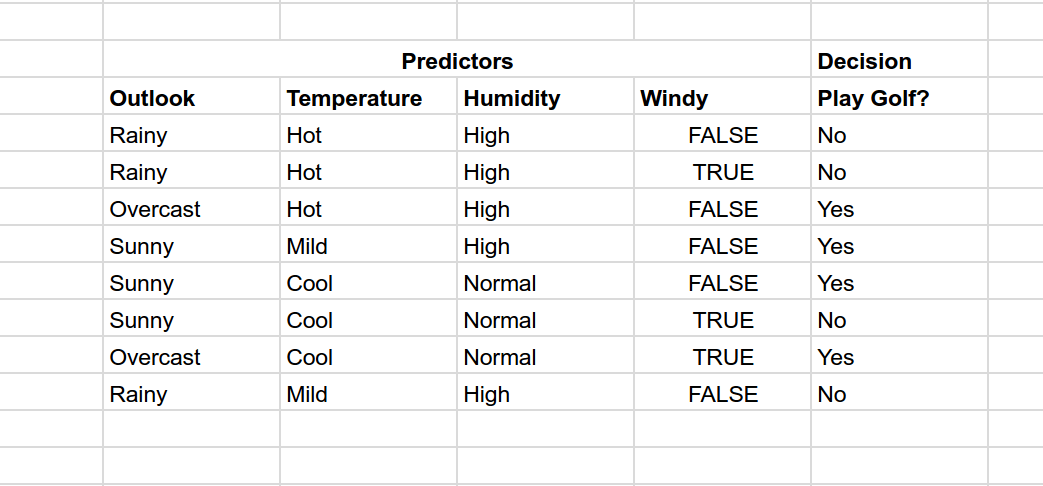
Теперь, если погодные условия заданы как:
Прогноз: дождь, Температура: прохладно, Влажность: высокая, ветрено: неверно
Может, поиграем в гольф?
We have outcomes at beginning as NNYYYNYN (Y = Yes and N = No) taken in given order. Entropy at this root node is 0.3
Now try to divide on various predictors outlook, temperature, humidity and Windy.
Calculate the information gain in each case. Which one has highest information gain?
For example, if we divide based on Outlook, we have divisions as
 Rainy      : NNN      (entropy = 0)
 Sunny      : YYN      (entropy = 0.041)
 Overcast   : YY       (entropy = 0)
So information gain = 0.3 - [0 + (3/8)*0.041 + 0]
                    = 0.28
Try out for other cases.
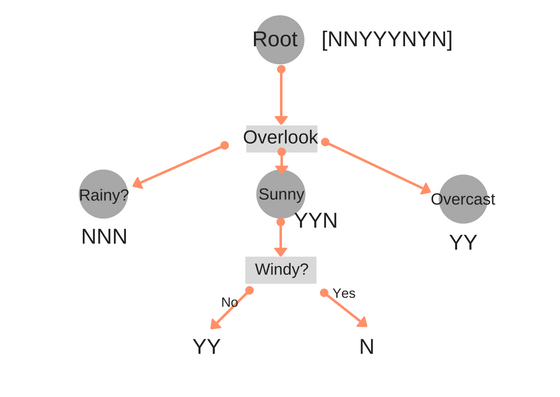
The information gain is max when divided based on Outlook.
Now the impurity for Rainy and Overcast is 0. We stop for them here.
Next we need to separate Sunny,
If we divide by Windy, we get max information gain.
Sunny
 YYN
  Windy? Yes : N
         No  : YY
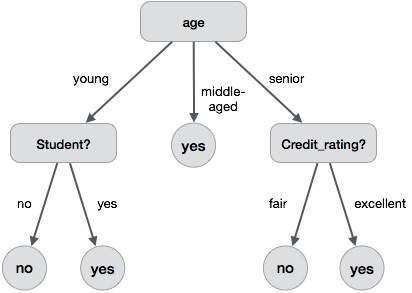
So decision tree look like something as shown in image below.
No the prediction data is
Outlook : Rainy, Temperature: Cool, Humidity: High, Windy: False
Flowing down from tree according to result, we first check Rainy?
So answer is No, we don't play golf.
Последние мысли
Эффективное деление, основанное на максимальном выигрыше информации, является ключом к классификатору дерева решений. Однако в реальном мире с миллионами данных разделение на чистый класс практически невозможно (это может занять больше времени на обучение), и поэтому мы останавливаемся в точках в узлах дерева при выполнении с определенными параметрами (например, процент примесей). Мы увидим это в упражнении по кодированию.
В Следующей части мы запрограммируем классификатор дерева решений на Python с использованием библиотеки sklearn. Мы настроим некоторые параметры, чтобы добиться большей точности, допуская некоторые примеси.
Я надеюсь, что этот раздел был полезен для понимания работы классификатора дерева решений. Прокомментируйте свои мысли, отзывы или предложения, если таковые имеются. Если вам понравился этот пост, поделитесь им с друзьями, подпишитесь на Машинное обучение 101, щелкните значок сердца (❤). Следуйте за мной в Facebook, twitter, LinkedIn. Мир!