
Как настроить базовый проект GraphQL с помощью graphql-express, что такое корневые типы и как лучше всего структурировать код в проектах GraphQL.
В этом посте я собираюсь объяснить, какие проблемы решает GraphQL, настраивая базовый проект GraphQL с помощью graphql-express, что такое корневые типы и как лучше всего структурировать код в проектах GraphQL.
Что и почему?
GraphQL - это язык запросов для API и среда выполнения для выполнения этих запросов с вашими существующими данными. - graphql.org
Ключевым моментом здесь является то, что GraphQL - это язык запросов для «API». Обратите внимание на слово «API». Важно знать, что GraphQL - НЕ язык запросов для баз данных. Это распространенное заблуждение, и по этому поводу ведутся многочисленные споры в Интернете и социальных сетях.
Итак, что вы подразумеваете под языком запросов для API?
Чтобы понять это, давайте сделаем шаг назад и разберемся, как клиент (веб-приложение / мобильное приложение) вызывает API-интерфейсы для получения информации с сервера. Для целей этого объяснения предположим, что эти API являются RESTful (наиболее распространенным шаблоном API).
Например, предположим, что мы создаем medium.com для удаленных сотрудников. Наш бэкэнд - это сервер NodeJS с базой данных Postgres, развернутой в каком-то облаке. Мы определяем API так, чтобы наше клиентское приложение ReactJS могло их использовать. Пока ничего особенного. Давайте подумаем, как могут выглядеть эти API,
POST /api/post -> Creates a post
PATCH /api/post -> Updates a post (edit, add claps etc.)
POST /api/user -> Creates a user
GET /api/users/:id -> Gets the user's metadata by id
GET /api/posts/:id -> Gets the post by id
Опять же, довольно просто, не так ли? Теперь давайте немного подумаем о разработке внешнего интерфейса для этого проекта и о том, с какими вариантами использования мы можем столкнуться.
Совет: публикуйте и повторно используйте компоненты React с Bit
Публикуйте повторно используемые компоненты React из любой кодовой базы в едином центре компонентов. Используйте Bit для документирования, систематизации и даже отслеживания обновлений и использования компонентов.
Делитесь компонентами со своей командой, чтобы максимально увеличить повторное использование кода, ускорить доставку и создавать масштабируемые приложения.

вариант использования №1: как пользователю medium.com мне нужна страница, на которой я могу увидеть все свои истории.
Для этого клиентская часть должна сделать следующее:
- GET / api / users /: id - ›Это вернет пользовательские метаданные для пользователя, которые, вероятно, выглядят примерно так:
{
  id: "someid",
  fname: "karthik",
  lname: "kalyan",
  posts: ["postid1", "postid2", "postid3"],
}
- Для каждого идентификатора сообщения в списке сообщений вызовите GET / api / post /: id и выполните последующую обработку возвращенных данных, чтобы создать список, который выглядит так:
[
 {
  id: postid1,
  summary: "intro to graphql",
  url: "mymedium.com/intro-to-graphql",
 },
 {
  id: postid2,
  summary: "intro to rest",
  url: "mymedium.com/intro-to-rest",
 },
 {
  id: postid3,
  summary: "intro to sql",
  url: "mymedium.com/intro-to-sql",
 },
]
Этот подход работает, и мы можем собрать информацию, необходимую для создания этой страницы. Но для этого мы сделали в общей сложности 4 вызова API (1 для получения метаданных пользователя и 3 вызова API для получения метаданных постов для 3 постов.), А также мы сбросили дополнительную информацию, которую мы получили на полу. с конечной точкой GET / api / post /: id, которая, вероятно, выглядела так:
{
  id: "postid1",
  content: "encoded/compressed content",
  claps: 50,
  summary: "intro to graphql",
  title: "GraphQL"
  comments: ["commentid1", commentid2"]
}
Нам просто нужно было краткое содержание сообщения от этого объекта для каждого из этих сообщений. Кроме того, для пользователя с 100 сообщениями клиенту необходимо совершить 100 вызовов, что дорого, а также объем информации, передаваемой между базой данных, сервером и клиентом, намного больше, чем нужно клиенту.
Один из способов оптимизировать это - ввести новую конечную точку, которая выглядит так:
ПОЛУЧИТЬ / api / posts / summary /: user_id
Как вы, наверное, уже догадались, эта конечная точка извлекает только ту информацию, которая необходима (с правильно построенными SQL-запросами) для отображения сводной страницы пользователя на серверной части, и возвращает только то, что нужно клиенту.
Благодаря грамотно сконструированным API-интерфейсам, которые соответствуют потребностям клиента с гипероптимизированными запросами к БД, мы можем создавать быстрые API-интерфейсы для этого проекта. Но программное обеспечение сложно, и не всегда все идет по плану. Мы все склонны к слепым пятнам, и дизайн API часто может пойти не так с такими амбициозными проектами. Независимо от того, насколько хорошо мы думаем о дизайне API, есть большая вероятность, что мы столкнемся с проблемами недостаточной или избыточной выборки (данных). Решение с REST в основном,
- Добавление новых конечных точек
- Перегрузка существующих конечных точек.
GraphQL существует для решения этой самой проблемы с REST API.
Как?
Теперь перейдем к вопросу о том, как реализовать решение GraphQL и какие варианты доступны для меня. Прежде чем мы посмотрим на список доступных вариантов / проектов, давайте рассмотрим создание простого решения GraphQL самостоятельно.
Для целей этого объяснения мы собираемся создать сервер ExpressJS, который использует GraphQL в качестве уровня API. Давайте начнем,
И так, что здесь происходит. Я намеренно начинаю с незнакомой страны и собираюсь попытаться проработать это в обратном направлении, чтобы вы получили полное представление об этом.
В строках 17–22 мы создаем экземпляр знакомого экспресс-приложения. Но, помимо этого, мы также добавляем промежуточное ПО под названием graphqlHTTP, которое имеет ряд свойств. Наша конечная точка в этом случае - http: // localhost: 4000 / graphql. Посмотрим, что происходит в браузере:
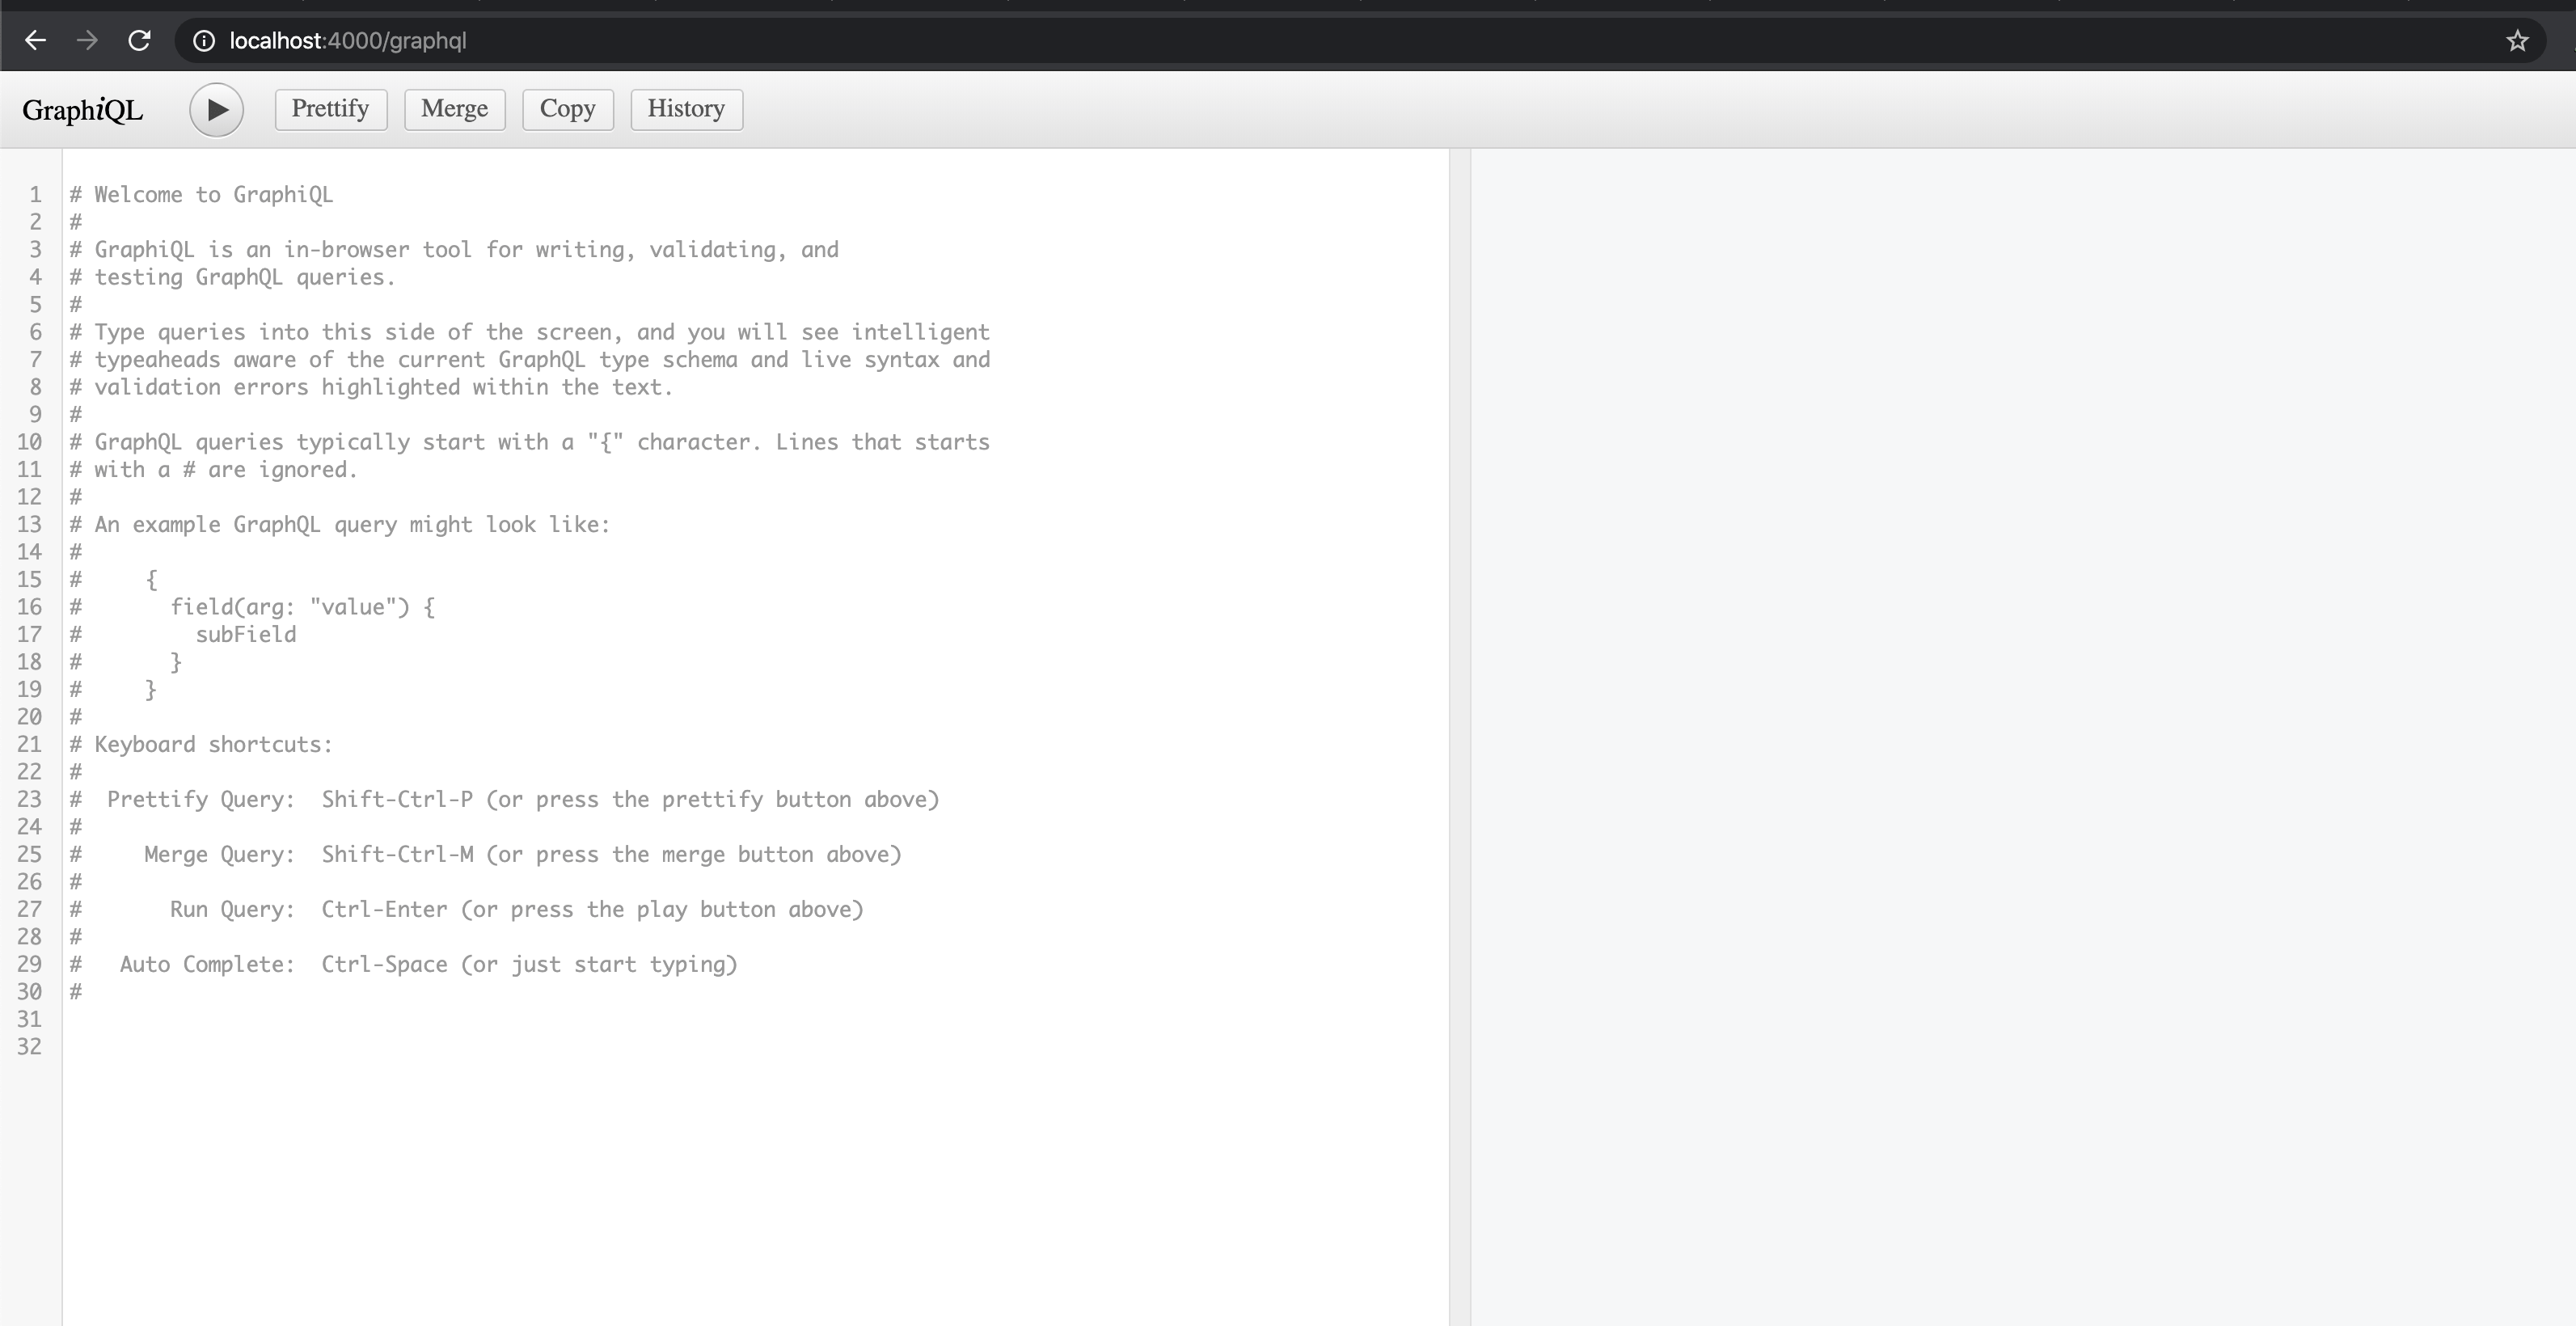
Мы получаем красивый интерфейс, который представляет собой не что иное, как веб-клиент для graphQL.
Прежде чем идти дальше, давайте немного рассмотрим промежуточное программное обеспечение graphqlHTTP и строки 6–17.
- Промежуточное ПО graphqlHTTP позволяет нам создавать HTTP-сервер GraphQL с любой веб-инфраструктурой HTTP, которая поддерживает промежуточное ПО в стиле подключения, включая собственно Connect, Express и Restify.
Теперь давайте посмотрим на свойства промежуточного программного обеспечения,
- graphiql: для свойства graphiql установлено значение true, что означает, что мы включили красивый интерфейс, когда перейдем к http: // localhost: 4000 / graphql:

- Как видите, когда мы пишем простой запрос {hello}, мы получаем обратно {«data»: {«hello»: «Hello!» }}. Запрос и данные совпадают точно один к одному. Другими словами, мы получили именно то, что просили. Если задуматься, это именно та проблема, которую решает GraphQL.
- Теперь, чтобы GraphQL знал, какие типы данных возможны в службе, в GraphQL есть концепция схем. Каждая служба GraphQL определяет набор типов, которые полностью описывают набор возможных данных, которые вы можете запросить в этой службе. Затем, когда поступают запросы, они проверяются и выполняются по этой схеме. Это то, что мы сделали в строке 5.
- Мы создали схему с помощью GraphQLSchema
- Внутри схемы у нас есть тип под названием «запрос», который создается с использованием GraphQLObjectType.
- Название типа «запрос» - «Запрос», и в нем есть поле с названием «привет».
- Поле «hello» представляет собой GraphQLString и имеет функцию преобразователя, которая возвращает «Hello!»
hello - это тип запроса, который является особым типом в GraphQL. Все типы запросов должны иметь функцию преобразователя, которая сообщает GraphQL, как разрешить этот запрос.
Типы запросов можно называть так:
{
  hello
}
or
query {
  hello
}
Теперь давайте подумаем о нашем примере с medium.com. Давайте продолжим и определим наши типы graphQL.
Для этого примера я определил две переменные: users и posts для хранения данных вместо использования реальной базы данных. В строках 26 и 35 я определил соответствующие типы схем для пользователей и сообщений. По сути, это оболочки вокруг фактической структуры с использованием API-интерфейсов graphQL.
Обратите внимание, как я явно объявил типы для каждого поля как GraphQLString или GraphQLList (в случае сообщений). Кроме того, поле сообщений в userType является GraphQLList для postType.
Как мы знаем, пользователи и сообщения - это отношение «один ко многим». И в идеале мы хотим, чтобы наш API возвращал объект пользователя на основе переданного id. Мы также хотели бы заполнить наши пользовательские данные фактическими сообщениями, связанными с пользователем, а не только идентификатором сообщения. Итак, нам нужны данные, которые выглядят так:
{
  "data": {
    "user": {
      "name": "karthik",
      "posts": [
        {
          "id": "post1",
          "summary": "Intro to graphql"
        }
      ]
    }
  }
}
Давайте продолжим и напишем queryType, который разрешает данные, похожие на приведенный выше блок кода.
Хорошо, что здесь происходит?
- Я определил тип запроса под названием UserQuery.
- Он имеет два поля: сообщение и пользователь.
- post принимает id в качестве аргумента для своего преобразователя и возвращает соответствующее сообщение из базы данных.
- user принимает id в качестве аргумента для своего преобразователя и разрешает не только пользователя, но и данные, связанные со всеми сообщениями, связанными с пользователем.
Давайте запустим запрос из браузера
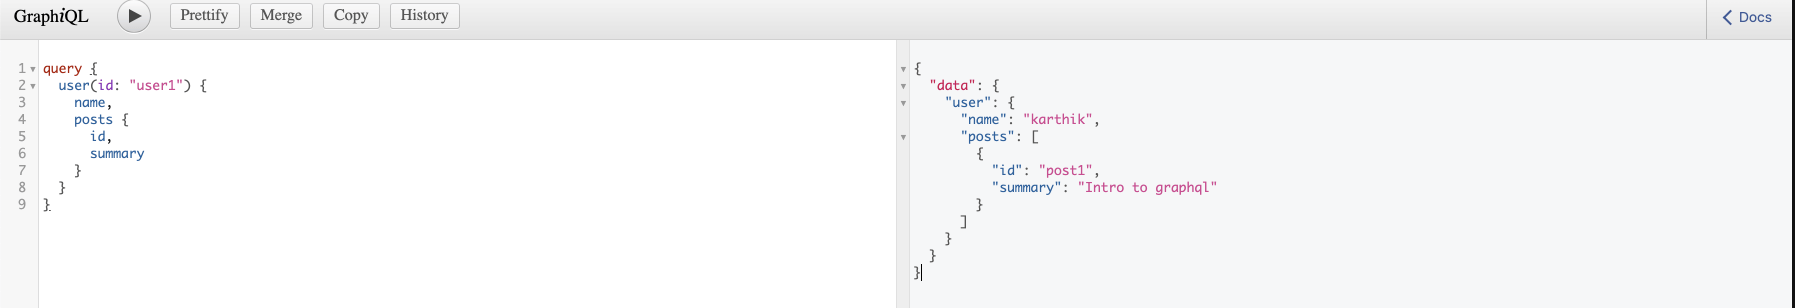
Как видите, мы запросили данные пользователя с идентификатором «user1» и запросили только имя и сообщения. Мы получили именно то, о чем просили. Давайте продолжим и добавим идентификатор пользователя,

И снова мы получили то, о чем просили. Давайте ненадолго остановимся и подумаем, как бы мы могли добиться того же без graphQL. В этом примере в базе данных postgreSQL есть две таблицы, которые выглядят так:
users
| id     | name    |
| user1  | karthik |
| user2  | john    |
posts
| id     | summary   | user_id |
| post1  | ...       | user1   |
| post2  | ...       | user2   |
Обратите внимание, как мы сопоставляем отношения "один ко многим" между пользователями и сообщениями, используя столбец user_id в таблице сообщений. У каждого пользователя может быть более одного сообщения. Но каждый пост создается только одним уникальным пользователем.
Как правило, чтобы получить объект пользователя по его идентификатору вместе со всеми связанными сообщениями, мы можем написать запрос SQL, который выглядит так:
SELECT users.id, users.name
FROM users
INNER JOIN posts
ON users.id = posts.user_id;
Или мы можем получить доступ к тем же данным, используя ORM sequelize, который является не чем иным, как оболочкой поверх низкоуровневых SQL-запросов.
Этот запрос заключен в вызов функции, которую мы можем вызвать как getUserInformation (id). В архитектуре REST у нас будет конечная точка, которая выглядит так:
GET /api/users/:id
Эта конечная точка будет внутренне вызывать функцию getUserInformation (id) на сервере, чтобы обработать данные и вернуть их клиенту.
Обратите внимание: список того, что мы делаем для достижения того же самого с REST,
- Напишите SQL-запрос или используйте ORM для вызовов API к БД.
- Завершите это с помощью функции или класса на сервере
- Создайте и предоставьте конечную точку, которая вызывает эту функцию
В REST мы повторяем указанные выше 3 шага почти для каждой конечной точки.
Это отличный подход, и он действительно хорошо работает. Но некоторые из недостатков этого подхода включают в себя:
- Существует большая вероятность того, что API-интерфейсы DB Wrapper в какой-то момент взорвутся с большой избыточностью, когда проект будет расти, а размер команды растет.
- API-интерфейсы DB Wrapper привязаны к схеме БД, что означает, что мы не можем с уверенностью сокращать или изменять таблицы БД.
- Количество конечных точек API также увеличится, если мы попытаемся ограничить объем работы для каждого API. С другой стороны, если мы перегружаем существующие конечные точки API, мы сталкиваемся с проблемой избыточной выборки и, следовательно, потери полосы пропускания и увеличения задержки.
Хотя приятно иметь возможность писать конкретные SQL-запросы для конкретных нужд,
С большой свободой приходит большая ответственность
"Ok! Итак, теперь у вас может возникнуть соблазн спросить, как GraphQL общается с БД? Есть ли у него механизм для перевода запросов GraphQL в запросы SQL (для MySQL или PostGreSQL)? Если да, не перекладываю ли я слишком много ответственности на новую технологию, не зная точно, как это повлияет на мою производительность? »
Все эти вопросы очень важны. Ответ да, и нет. Позвольте мне уточнить.
Преобразует ли GraphQL запросы GraphQL в запросы SQL?
Короткий ответ: это зависит от обстоятельств! Это полностью зависит от принятого вами решения GraphQL. Например, в случае с medium.com для удаленных сотрудников мы написали преобразователи для пользователя и сообщения. Если вы внимательно заметили, преобразователи берут на себя тяжелую работу по чтению информации из базы данных, нарезке и нарезке ее и отправке обратно на сервер GraphQL. Итак, в этом случае у вас есть два варианта:
- Напишите SQL-запросы, завершите их функцией и вызовите этот API из преобразователя.
- Используйте ORL, например sequelize, и вызовите API sequelize внутри преобразователя.
Как видите, это ничем не отличается от того, что мы делаем с REST. Это дает вам контроль и свободу общения с БД, а также накладывает на нее стек GraphQL поверх, чтобы воспользоваться ее преимуществами.
Но если вы рассмотрите другие варианты, например,
Эти решения представляют собой механизмы GraphQL, у которых есть компилятор, который автоматически изучает схему вашей базы данных и генерирует эффективные запросы для выборки данных.
Опять же, это зависит от потребностей и требований проекта, и только вы можете определить, что лучше всего подходит для вас.
До сих пор мы видели, как читать с помощью GraphQL. Но есть 4 операции, связанные с любой базой данных.
C R U D - ›Создание, чтение, обновление и удаление
Перейдем к созданию, обновлению и удалению. Введите Мутации.
Напомню еще раз, что Запрос - это особый тип graphQL. Точно так же Мутация - это еще один специальный тип graphQL.
Давайте продолжим и создадим мутацию, которая позволит нам создать пользователя и создать для него сообщение.
Как видите, он следует шаблону, очень похожему на queryType. Мы определили новую переменную mutationType, которая имеет два поля: createPost и createUser.
Опять же, преобразователь создается вручную с помощью бизнес-логики, которая включает в себя:
- Создание нового уникального идентификатора для сообщения
- Создание нового объекта сообщения и добавление его в сообщения
- Связывание идентификатора вновь созданного сообщения с пользователем с помощью аргумента user_id.
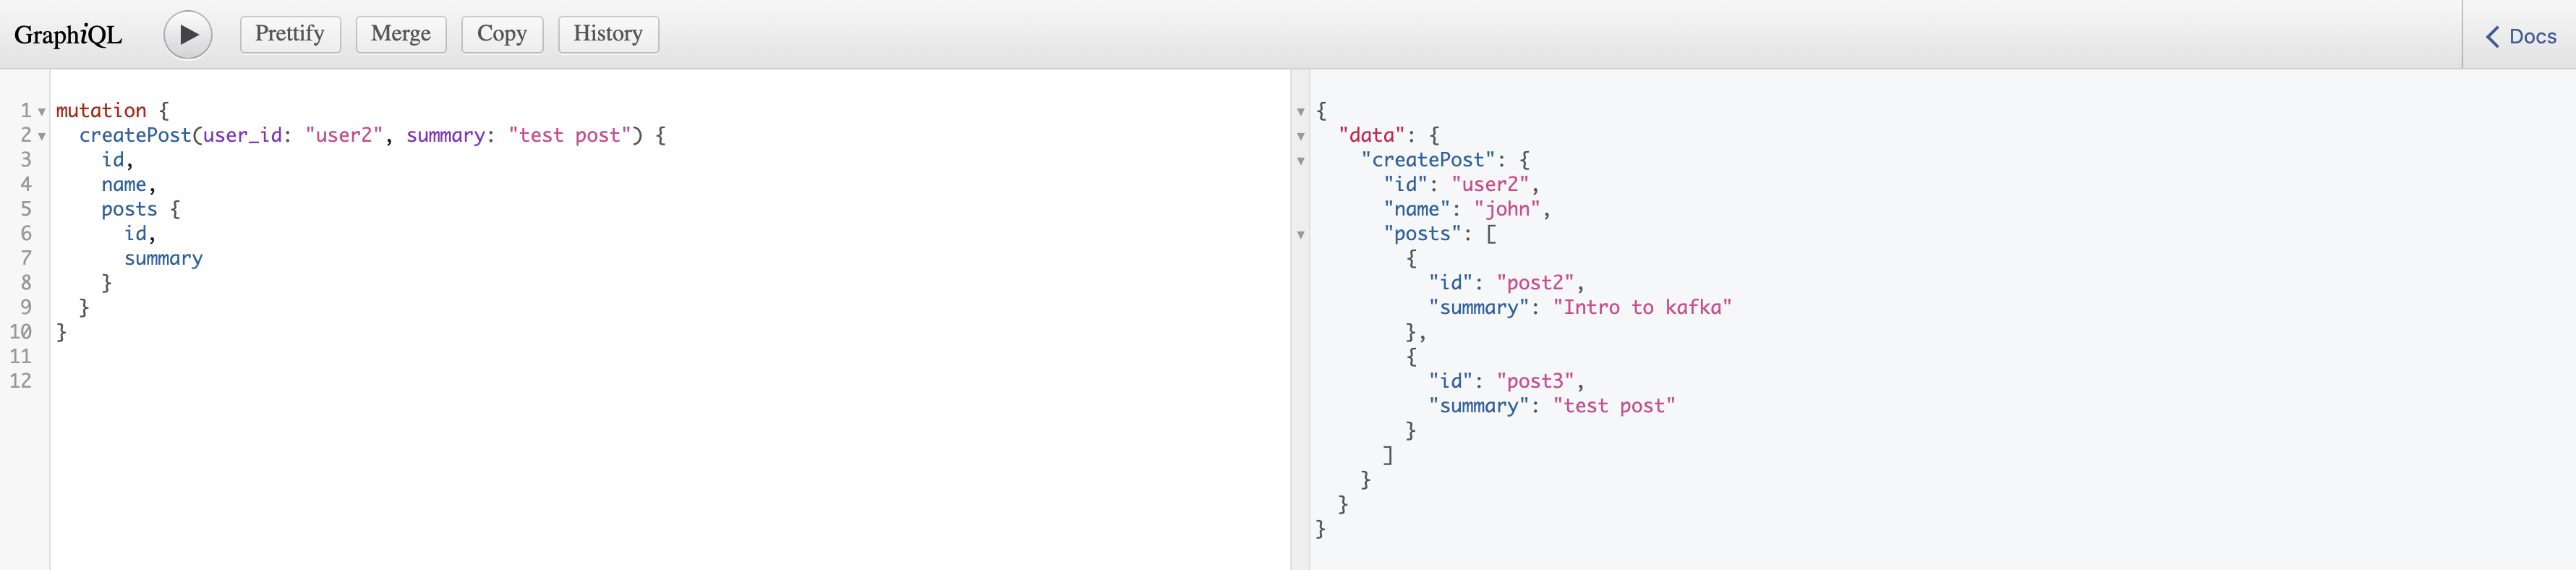
Как видите, мы можем создать новый пост и связать его с пользователем. И согласно нашей логике в строке 6, где мы сообщаем нашей мутации, createPost возвращать userType, мы получаем соответствующий объект пользователя с актуальной информацией о сообщениях после того, как создадим новый пост.
Важно отметить, что Мутация включает в себя создание, обновление и удаление, поскольку мы контролируем, что делает операция внутри функции преобразователя.
До сих пор мы видели два основных корневых типа GraphQL, Mutation и Query. Я показал, как создавать типы GraphQL, используя GraphQLObjectType и другие типы GraphQL. А также, как создать схему с помощью GraphQLSchema.
Но этот код очень тесно связан с определениями типов, преобразователями и схемой, определенными вместе. Есть еще один элегантный подход к структурированию проектов GraphQL.
Структурирование кода
Чтобы схема оставалась отдельной и гибкой, мы можем создать новый тип файла с именем schema.graphql, который выглядит следующим образом:
Этот файл определяет типы: Запрос, Сообщение и Пользователь.
Теперь давайте перенесем и наши преобразователи в отдельный файл.
Как видите, преобразователь запросов, который мы написали изначально, был изменен и преобразован в преобразователь, который мы видим в строке 25. Также обратите внимание, мы определили преобразователь для каждого поля типа User. А распознаватель user просто возвращает аргумент ‘id’ до своих дочерних типов - id, name и posts. Дочерние типы могут получить доступ к идентификатору, переданному от родителей через аргумент root, и тем самым разрешить его отдельно.
Таким образом мы можем разрешить каждое поле отдельно. Такое структурирование преобразователей делает код более чистым, отлаживаемым и имеет четкое разделение проблем.
Теперь давайте посмотрим, как мы можем импортировать распознаватели и определения типов из resolvers.js и schema.graphql в файл записи нашего приложения, index.js
Мы используем пакет graphql-tools (который является частью apollo-graphql), который предоставляет нам API makeExecutableSchema. Этот API принимает в качестве аргументов typeDefs и преобразователи и создает схему, которую можно напрямую передать промежуточному программному обеспечению graphqlHTTP.
Конечный результат этой реструктуризации кода дает нам точно такие же функциональные возможности с гораздо более гибкой, многократно используемой и масштабируемой базой кода.
Параметры
GraphQL был реализован в различных проектах, которые обслуживают разные стеки. Некоторые из популярных включают:
- Аполлон: https://www.apollographql.com/
- GraphQL - Yoga: https://github.com/prisma-labs/graphql-yoga
Заключение
Надеюсь, вам понравилось читать и изучать основы GraphQL и создавать проект GraphQL с нуля. Не стесняйтесь оставлять комментарии / отзывы, если у вас есть вопросы. Спасибо за ваше время!





