
Идеальный алгоритм в машинном обучении имеет низкое смещение. Он наиболее точно определяет взаимосвязь между переменными. Ожидается, что он будет давать согласованные результаты, когда он сталкивается с разными наборами данных, и он должен иметь низкую изменчивость.
Мы должны понимать, что приемлемая модель не соответствует ни больше, ни меньше данных. Мы ожидаем, что модель должна хорошо работать на обучающих данных. Кроме того, модель должна быть обобщена для наборов данных, которые она еще не видела. Существуют разные способы решения проблемы переоснащения, мы можем предотвратить переобучение, упорядочив модель.
Что такое регуляризация и как она помогает нам уменьшить переоснащение? Регуляризация означает методы, которые используются для пересмотра моделей машинного обучения, чтобы минимизировать скорректированную функцию потерь и контролировать переоснащение или недообучение.
Регрессии Ridge, Lasso и ElasticNet являются важными методами регуляризации для уменьшения сложности модели и предотвращения переобучения.
- Регуляризация лассо (L1regularization)=›Добавляет сумму абсолютных значений коэффициентов к функции стоимости.
- Регуляризация хребта (регуляризация L2)=›Добавляет сумму квадратов коэффициентов к функции стоимости.
- Регуляризация ElasticNet=›Сочетает регуляризацию L1 и L2.
Мы будем использовать альфа-параметр для методов регуляризации. Альфа в данном контексте означает штраф за ошибки. Нам нужно будет определить оптимальное значение альфа. Для этого мы можем использовать технику настройки гиперпараметров. Но это не обязательно. Вы также можете попробовать разные допустимые значения для альфа-гиперпараметра.
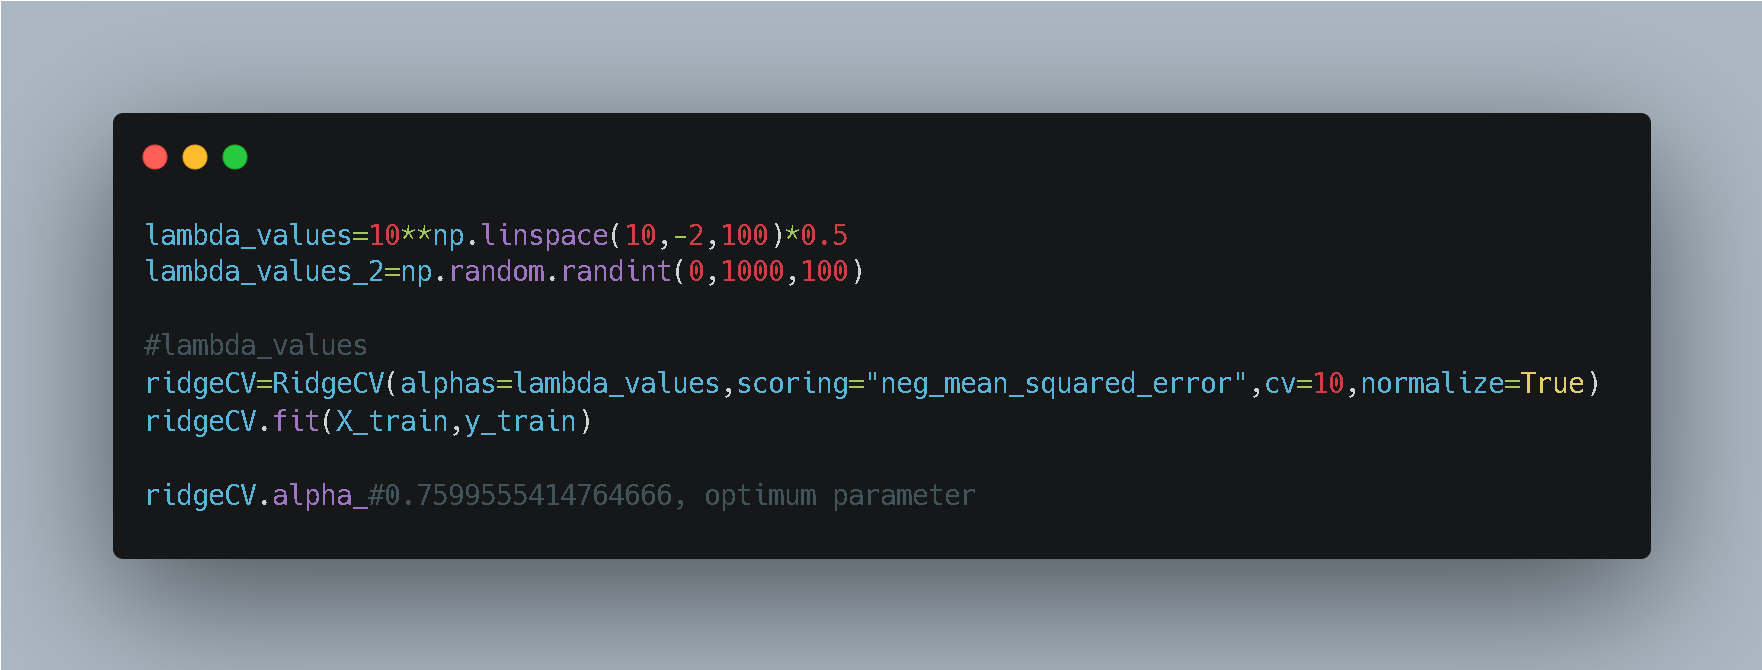
Что стоит за этим?Вы можете выбрать приемлемую модель, взглянув на среднеквадратичную ошибку как для обучающей, так и для тестовой выборки. По этой причине RMSE является нашей самой важной критикой. Мы смотрим на RMSE, чтобы убедиться и сравнить все результаты.
Регрессия хребта

- В этой формуле лямбда означает штраф за ошибки. Бета — это наклон кривой. SSE — это аббревиатура суммы квадратов ошибок.
Мы стремимся найти коэффициенты, которые минимизируют ошибку суммы квадратов, применяя штраф к этим коэффициентам. Формула, которую мы использовали для написания SSE, заключалась в том, чтобы найти разницу между фактическими значениями и прогнозируемыми значениями. Есть и другая часть, которая является сроком наказания. Если мы рассмотрим формулу, то часть, полученная из классической регрессии, будет такой же, но к этим бета-параметрам применяются различия в бета-параметрах и штраф.
- Регуляризация хребта помогает нам быть устойчивыми к переоснащению. Это лучше, чем SSE, когда слишком много параметров.
- Предлагает решение проблемы многомерности.
- Он эффективен при наличии проблемы мультиколлинеарности.
- Он устанавливает модель со всеми переменными. Он не удаляет из модели нерелевантные переменные и приближает их коэффициенты к нулю.
- Лямбда играет решающую роль. Это позволяет контролировать относительные эффекты терминов, а также найти хорошее значение для лямбда.
Лассо-регрессия
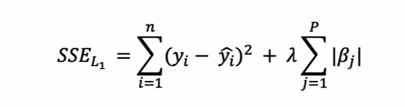
Недостаток гребневой регрессии заключался в добавлении в модель несвязанных переменных. Лассо важно решить эту проблему.
Коэффициенты Лассо приближаются к нулю. Кроме того, коэффициенты также могут быть нулевыми. Таким образом, осуществляется выбор переменной. Выбор подходящего значения альфа также очень важен для этого метода.
!!!Следует знать, что методы Риджа и Лассо не превосходят друг друга.
Регрессия ElasticNet

- ElasticNet сочетает в себе подходы L1 и L2.
- Делает регуляризацию более эффективной; Наказание в стиле гребня и выбор переменной в стиле лассо.
- Он устойчив к проблемам мультиколлинеарности, проблемам переобучения и более долговечен.
- Выражения lambda1 и lambda2 будут преобразованы в один альфа-параметр. В результате будет искаться только параметр лямбда. Другими словами, для регрессии ElasticNet мы рассмотрим здесь два условия регуляризации как одно значение.
Таким образом, мы увидели, насколько важны методы оптимизации модели для моделирования. Ridge, Lasso и ElasticNet — важные методы оптимизации модели, которые будут работать эффективно.
Вы можете найти соответствующую работу, выполненную с помощью python, здесь;
…





