
В этом посте будет рассмотрен синтетический пример, иллюстрирующий один из способов использования многовариантного многошагового LSTM для обнаружения аномалий.
Представьте, что у вас есть матрица из k временных рядов, поступающих к вам через равные промежутки времени, и вы просматриваете последние n наблюдений для каждой метрики.

Одним из подходов к обнаружению аномалий в таких условиях является построение модели для прогнозирования каждой метрики на каждом временном шаге в вашем горизонте прогноза, и когда вы заметите, что ваши ошибки прогнозирования начинают значительно меняться, это может быть признаком некоторых аномалий в ваших входящих данных. .
По сути, это неконтролируемая проблема, которую можно преобразовать в контролируемую. Вы обучаете модель прогнозировать собственные обучающие данные. Затем, когда это становится хорошо (при условии, что ваши обучающие данные относительно типичны для нормального поведения ваших данных), если вы видите некоторые новые данные, для которых ваша ошибка прогноза намного выше, чем ожидалось, это может быть признаком того, что ваши новые данные аномально как-то.
Примечание. Этот пример адаптирован и построен на основе этого руководства, которое я считаю очень полезной отправной точкой. Весь код для этого поста находится в этой записной книжке. Остальная часть этого поста, по сути, будет посвящена коду (я использовал отдельные описания для примеров, чтобы код выглядел немного лучше на носителе).
Импорт и параметры
Ниже показаны импорты и все параметры для этого примера, вы сможете поиграть с ними и посмотреть, какие разные результаты вы получите.
Примечание. Здесь есть Pipfile, в котором показаны необходимые библиотеки Python. Если вы не знакомы, вам действительно стоит проверить pipenv, это действительно полезно, если вы немного поиграете с ним.
Поддельные данные!
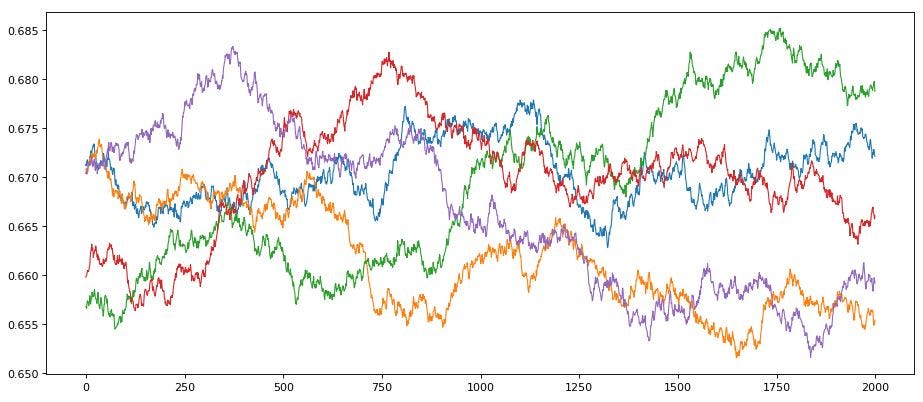
Мы сгенерируем некоторые случайные данные, а затем сгладим их, чтобы они выглядели реалистично. Это будут наши "нормальные" данные, которые мы будем использовать для обучения модели.
Затем мы сделаем копию этих нормальных данных и введем случайный шум в определенный момент и в течение определенного периода времени. Это будут наши неверные данные.
Таким образом, эти «сломанные» данные — это данные, с которыми мы должны увидеть, как модель борется с ошибкой прогнозирования. Именно эту ошибку (агрегированную и суммированную каким-то образом, например, преобразованную в z-показатель) можно затем использовать для определения показателя аномалии (вы также можете использовать потери от постоянного повторного обучения на новых данных, при этом потери при обучении должны изначально всплеск, когда в систему поступают неверные данные, но со временем обучение адаптирует модель к новым данным).
Это дает нам наши обычные данные, выглядящие как реальные слова, которые мы будем использовать для обучения модели.
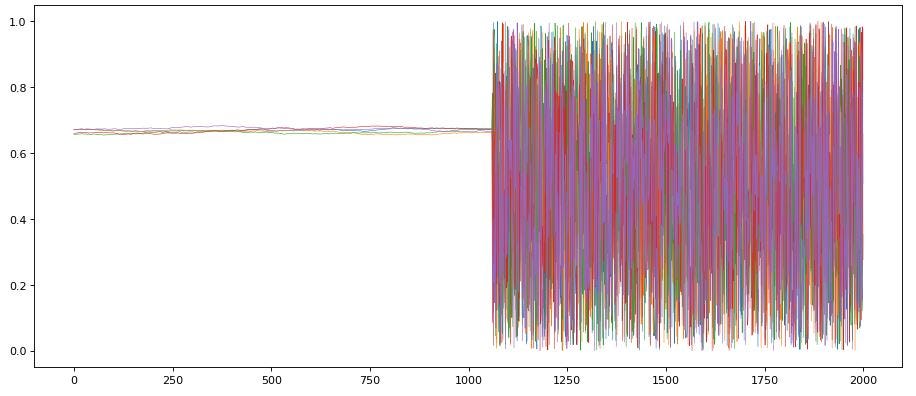
Чтобы сделать наши «сломанные» данные (называемые в коде data_new), я лениво просто копирую «нормальные» данные, но искажаю их сегмент случайным шумом.
Итак, ниже мы видим наши «сломанные» данные. Я установил здесь разорванный сегмент довольно широким, и совершенно очевидно, что разорванные данные совершенно другие. Есть надежда, что на самом деле однажды обученная модель будет хорошо улавливать гораздо более тонкие изменения в данных, которые менее очевидны для человеческого глаза.
Например, если все показатели должны были внезапно стать более или менее коррелированными, чем обычно, но каждый из них по-прежнему перемещается на типичную величину в отдельности, то это тип изменения, который вы хотели бы выделить в модели (это, вероятно, то, что я должен был попытаться сделать). делайте при создании «сломанных» данных, чтобы сделать весь пример более реалистичным, не стесняйтесь попробовать это сами и дайте мне знать, как у вас дела).
Некоторые вспомогательные функции
Я создал несколько вспомогательных функций, чтобы облегчить жизнь в примере блокнота. Я поделюсь кодом ниже и расскажу немного о каждом.
- data_reshape_for_model(): эта функция в основном берет типичный массив типа фрейма данных, перебирает эти данные и изменяет их все в пустой массив формы, ожидаемой моделью keras LSTM как для обучения, так и для прогнозирования. Выяснение того, как изменить форму данных на основе N_TIMESTEPS, N_FEATURES и длины данных, было, вероятно, самой сложной частью всего этого примера. Я заметил, что многие учебные пособия в Интернете просто изменяют данные, но делают это неполным образом, по сути, просто объединяя строки в пары. Но что вы действительно хотите сделать, так это пройтись по всем строкам, чтобы убедиться, что вы правильно прокручиваете свое окно N_TIMESTEPS по данным для всех возможных окон в вашем обучении.
- train(): это просто оболочка для функции обучения keras. В этом нет реальной необходимости.
- predict() : Подобно train(), это просто функция-оболочка, которая на самом деле мало что делает.
- model_data_to_df_long(): эта функция принимает массив данных, используемый моделью keras, и разворачивает его в один большой длинный фрейм данных pandas (массивы numpy иногда меня немного пугают, поэтому я всегда стараюсь отступать от pandas, когда Я могу уйти от этого 😉).
- model_df_long_to_wide(). Затем эта функция берет фрейм данных длинного формата, созданный функцией model_data_to_df_long(), и преобразует его в широкий формат, закрытый для исходного набора данных, состоящего из одной строки, одного наблюдения и одного столбца для каждого входного объекта. (плюс еще много столбцов для прогнозов для каждой функции для каждого временного шага).
- df_out_add_errors(): эта функция добавляет ошибки и столбцы агрегирования ошибок в основной кадр данных df_out, в котором хранятся все прогнозы и ошибки для каждой исходной строки данных.
- yhat_to_df_out(): эта функция принимает данные обучения в формате модели и выходные данные прогнозирования в формате модели и объединяет все вышеперечисленные функции, чтобы создать красивый маленький фрейм данных «df_out», в котором есть все, что мы хотим, и он является одним. одно наблюдение, чтобы оно более естественно совпадало с исходными данными.
Построить и обучить модель
Приведенный ниже код строит модель, обучает ее, а также вызывает прогнозирование для всех обучающих данных, чтобы иметь возможность получать ошибки в исходных «нормальных» обучающих данных.
Затем мы вызываем нашу функцию «сделать все» yhat_to_df_out() для обучающих данных и прогнозов модели.
Теперь мы можем построить множество вещей из df_out. Например, вот ошибки, усредненные по всем пяти функциям, для каждого горизонта прогнозирования временного шага.
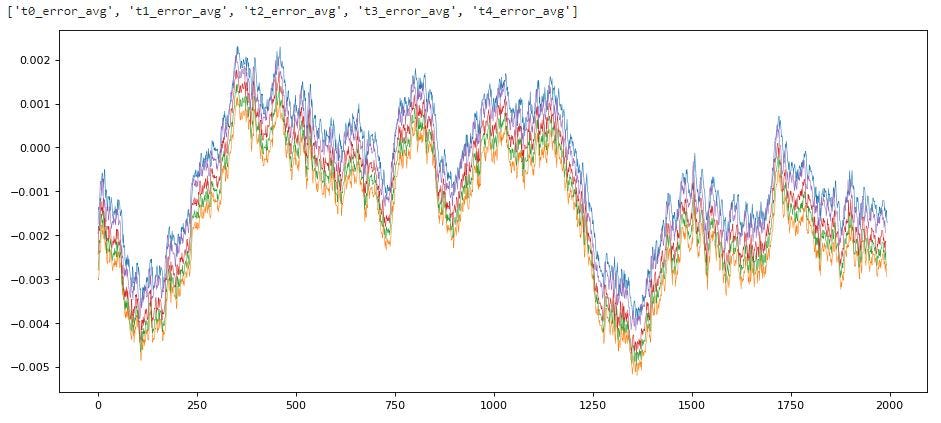
На приведенном выше графике мы видим усредненную ошибку модели на ее обучающих данных. Каждая линия представляет отдельный горизонт прогноза. Мы можем видеть, что линии как бы «наложены» друг на друга, что имеет смысл, поскольку вы обычно ожидаете, что ошибка на 5 временных шагов (красная линия «t4_error_avg») будет выше, чем прогноз на один шаг вперед (зеленый/ оранжевая строка «t0_error_avg»).
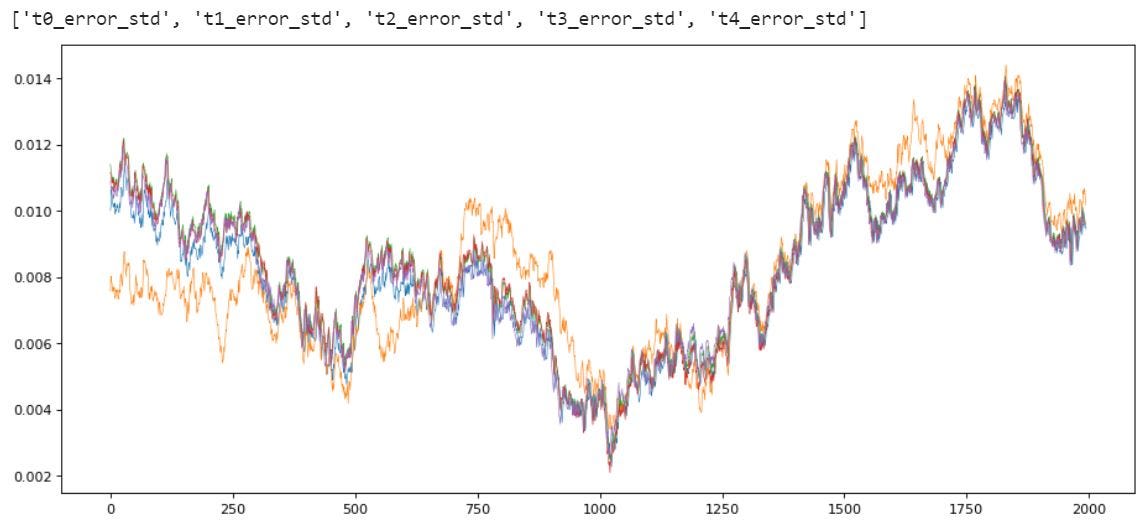
Если мы посмотрим на стандартное отклонение наших ошибок аналогичным образом, мы увидим, как стандартное отклонение наших ошибок обычно имеет тенденцию к увеличению в моменты, когда наши 5 исходных функций расходятся друг с другом, поскольку вы можете себе представить, что это самые сложные части. нашего временного ряда для этой модели, чтобы предсказать.
Давай сломаем это
Итак, теперь, когда наша модель обучена на наших «нормальных» данных, мы можем использовать ее, чтобы увидеть, насколько хорошо она предсказывает наши новые «сломанные» данные.
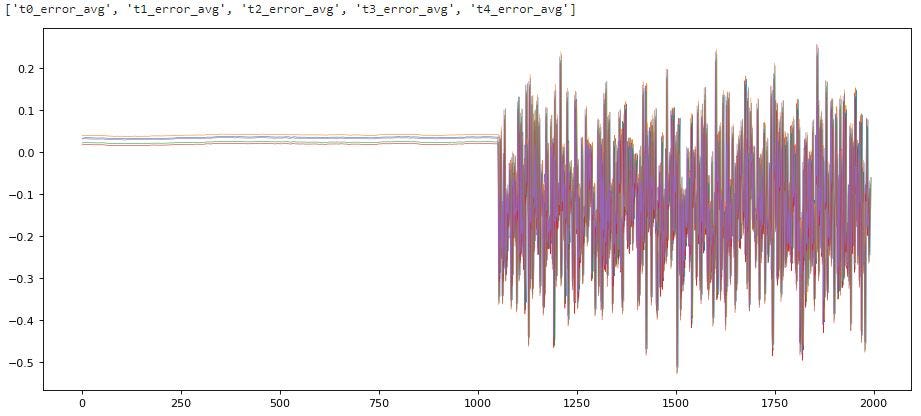
Из вышеизложенного мы видим, что как только случайные разрозненные данные поступают во временной ряд, ошибки прогнозирования модели резко увеличиваются.
Как уже упоминалось, это очень очевидный и синтетический вариант использования только для обучения, но основная идея заключается в том, что если ваши данные изменились более сложным и трудным для обнаружения способом, то ваши коэффициенты ошибок будут повсюду отражать это изменение. Затем эти частоты ошибок можно использовать в качестве входных данных для более глобальной оценки аномалий для вашей системы.
Вот и все, спасибо за чтение и не стесняйтесь добавлять любые комментарии или вопросы ниже. Я могу добавить несколько более сложных или реальных примеров, основанных на этом подходе, на более позднем этапе.
Спасибо, что дочитали до этого места, в качестве награды вот плейлист отличных видео по науке о данных, в которых, как я утверждаю, вы можете найти интересные видео.
ОБНОВЛЕНИЕ: Здесь — блокнот Google Colab, который немного лучше, так как я немного поработал над ним со времени первоначальной публикации в блоге.





