
В эпоху хронической нехватки персонала и возвращения к путешествиям в мире после COVID как никогда важно, чтобы отели адекватно планировали свою рабочую силу и операции для удовлетворения потребностей гостей.
Кроме того, очень важно, чтобы отели знали о любых потенциальных дополнительных потоках доходов, которые могут проявиться на рынке, и чтобы они использовали эти возможности с нужными гостями в нужное время. В отрасли дополнительные услуги, помимо простого бронирования, называются «особыми запросами». Это может быть запрос на номер вдали от лифтов, запрос на упаковку и игру или запрос на номер с видом.
Общие сведения, цели и источник данных
Этот анализ преследует две цели:
- Обучите и оцените набор моделей классификации, чтобы предсказать количество специальных запросов, сделанных бронированием, на основе других доступных функций с приемлемым уровнем точности.
- Изучение функций, которые сильно коррелируют с количеством специальных запросов, сделанных стороной бронирования.
Если вы не знакомы с тем, почемуэто полезно, важно быстро объяснить концепцию управления доходами. Проще говоря, отели и другие предприятия с ограниченными возможностями могут оптимизировать свои цены таким образом, чтобы спрос на номера (или, возможно, особые запросы) соответствовал рыночному спросу. Это гарантирует, что оператор полностью использует все доступные номера/услуги и максимизирует финансовую отдачу.
В контексте данного анализа это важно, поскольку это может привести к тому, что гостиничный оператор примет одно из двух решений:
- Если гостевой спрос на определенные специальные запросы превышает возможности, увеличьте цену этого предложения (или введите стоимость ранее бесплатной услуги)
- Если спрос гостей на определенные особые запросы не соответствует возможностям, введите рекламу «бесплатного» предложения этой услуги, которая не будет стоить бизнесу никаких дополнительных затрат, но повысит общий спрос на недвижимость.
Используемый здесь набор данных представляет собой данные Наборы данных о спросе на бронирование отелей, составленные Антонио, де Алмейда и Нуньес и впервые опубликованные в 2019 году. Данные состоят из информации о забронированных бронированиях в двух отелях в Португалии, одном пляжном курорте и одном в городе. . Подробнее с данными можно ознакомиться здесь.
Исследовательский анализ данных и очистка данных
Этот набор данных содержит 31 функцию и, помимо столбца «Особые запросы», всего 32 столбца. Всего в наборе данных 119 390 строк.
Первый важный элемент, который необходимо изучить при рассмотрении классификации, — более глубокое погружение в распределение класса предсказания. Для упрощения я объединил варианты в «1», «2» или «3+».

Что сразу становится очевидным при визуальном осмотре, так это то, что подавляющее большинство бронирований в этом наборе данных вообще не имеют особых запросов. В мире машинного обучения такое распределение называется несбалансированным. Чтобы успешно обучать непредвзятые модели, нам нужно выполнить некоторое преобразование данных (в противном случае лежащая в основе моделей математика будет каждый раз приводить к прогнозам «0» для оптимизации точности).
Обычно это делается путем повышающей выборки из классов меньшинства, понижающей выборки из классов большинства или с помощью какого-либо другого алгоритмического подхода. В этом проекте будет использоваться технология передискретизации синтетического меньшинства (SMOTE). SMOTE использует k-ближайших соседей для увеличения выборки из классов меньшинства и создания новых данных, характеристики которых пространственно аналогичны существующим данным. Это отличается от простой повышающей выборки, которая просто повторяет данные, и является лучшим выбором, поскольку лучше учитывает реальную вариацию данных.
После выполнения SMOTE (с использованием пакета Python с открытым исходным кодом) мы снова можем просмотреть дистрибутив:
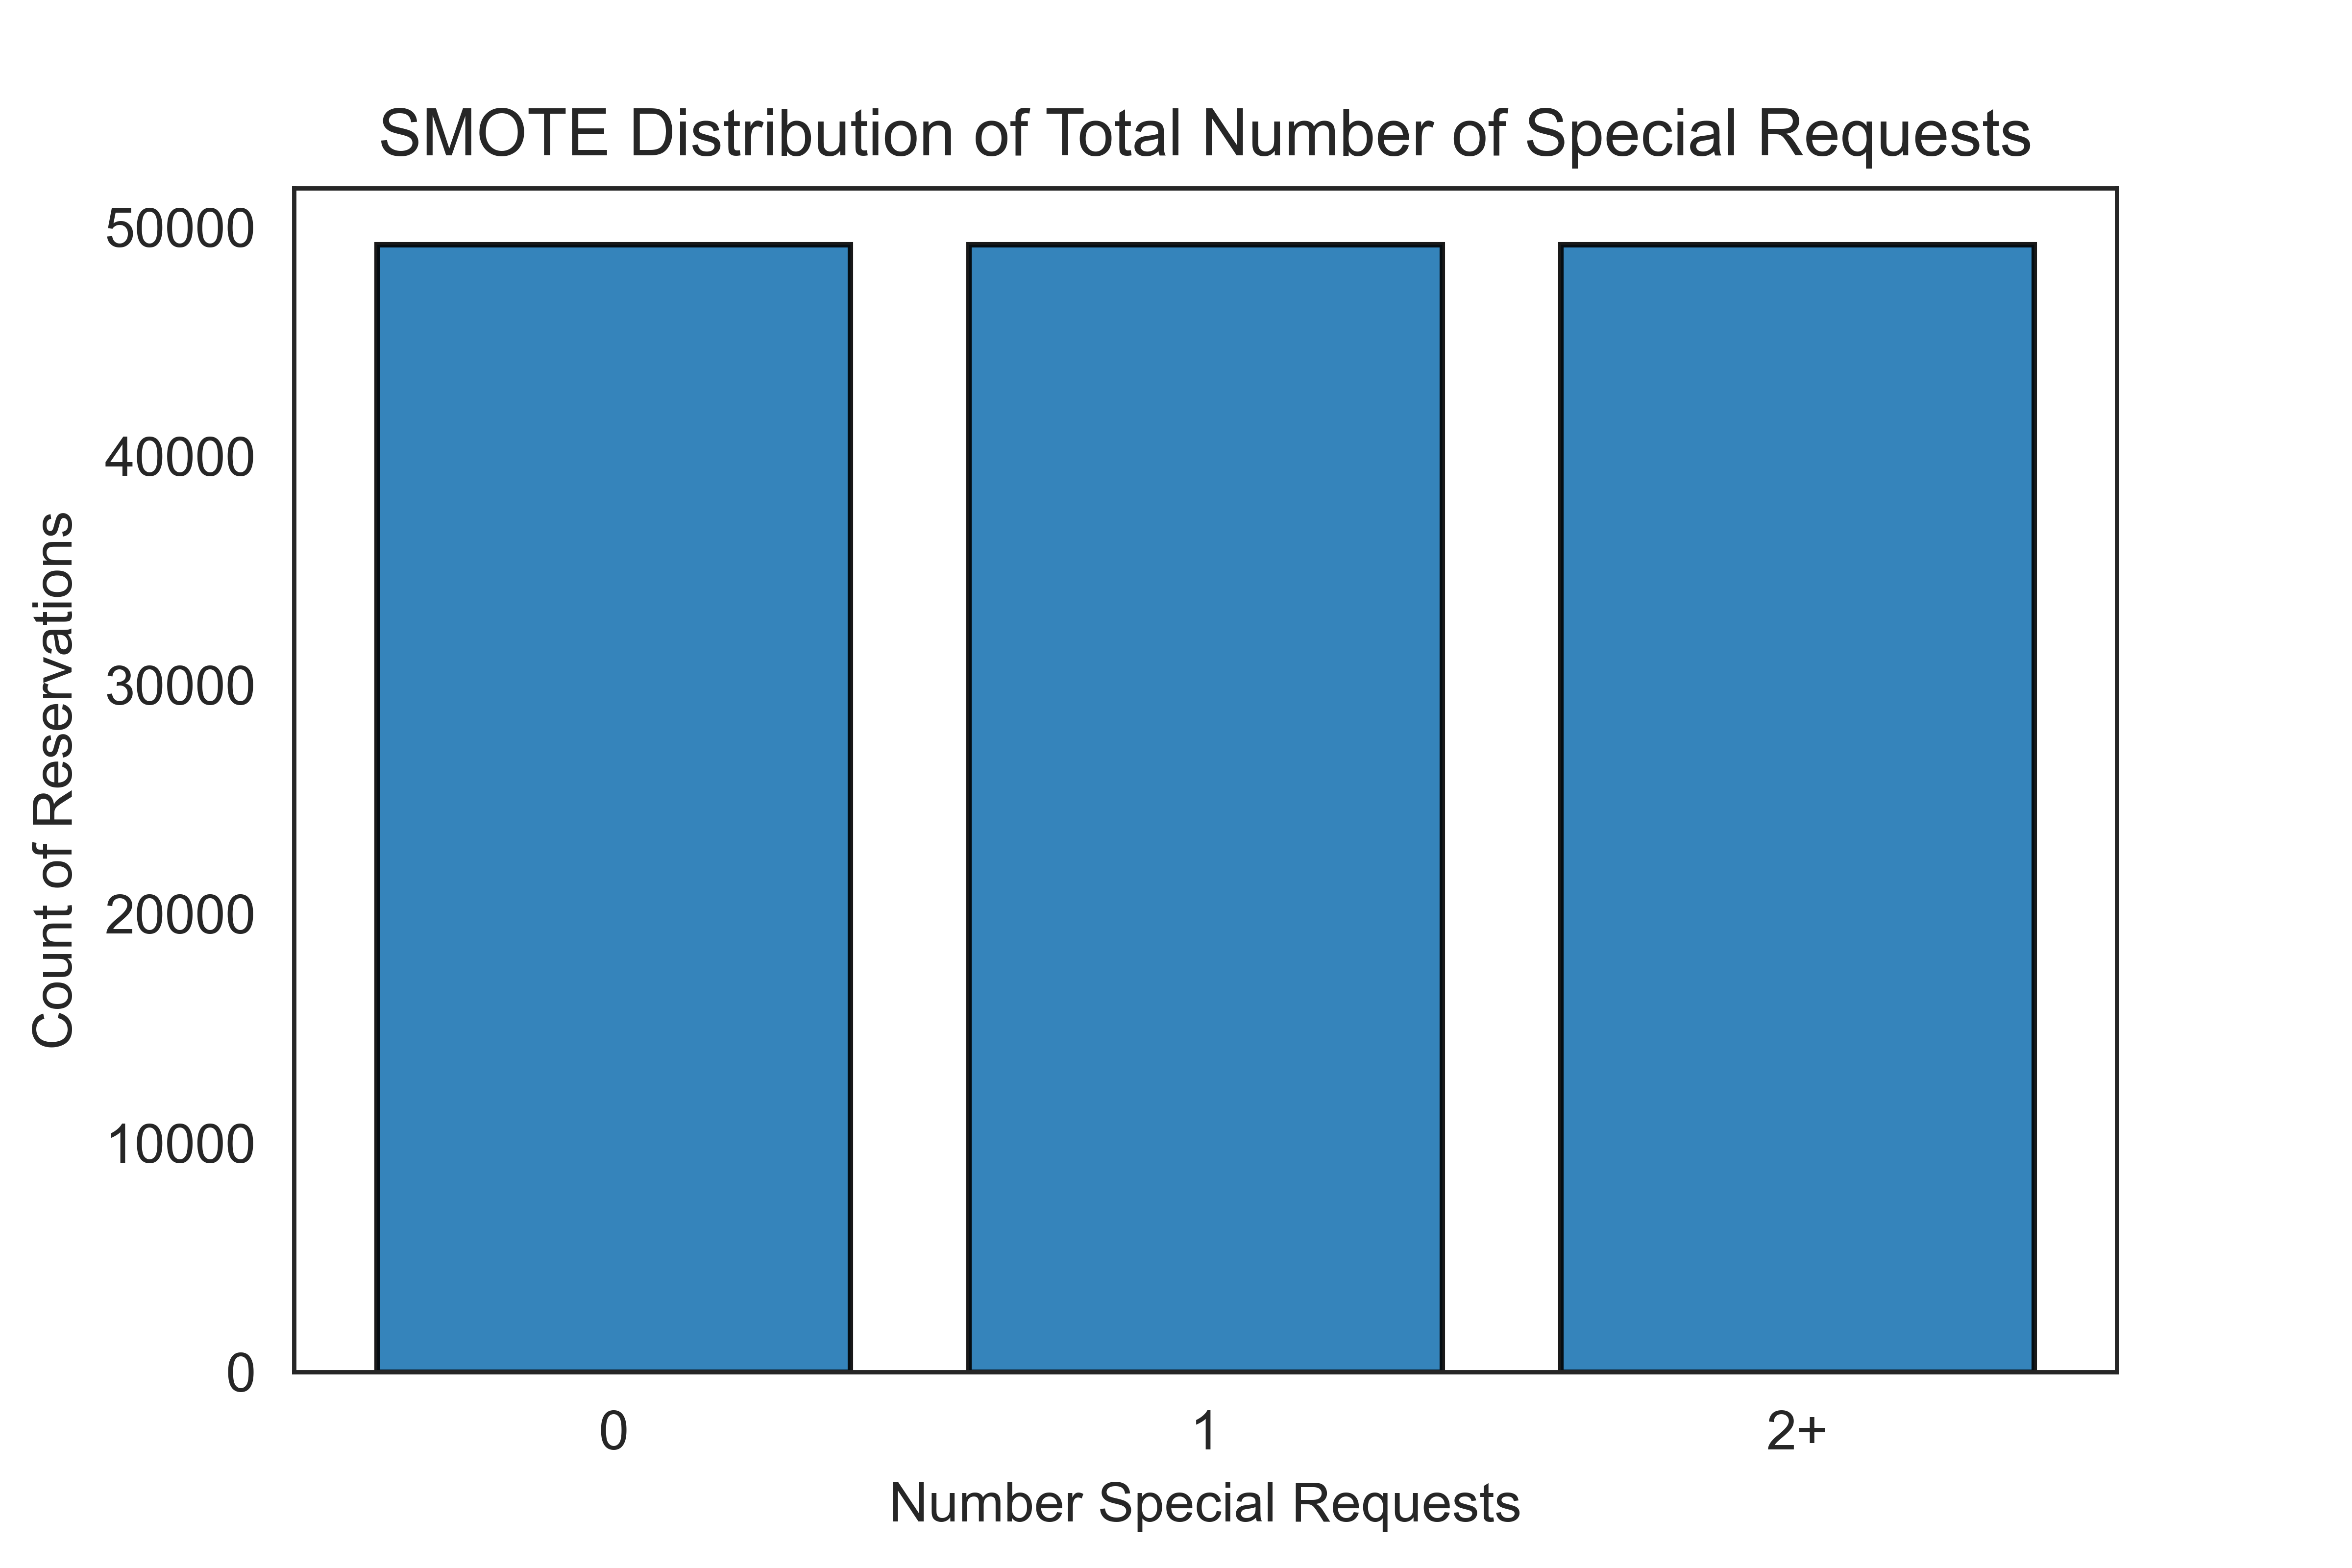
Идеально сбалансирован, как и предполагалось, и готов к статистическому обучению.
Чтобы иметь дело с переменными функций (в отличие от предиктора), я удалил несколько столбцов, которые не имеют отношения к прогнозированию количества специальных запросов. Это включало такие вещи, как даты и категориальные столбцы с очень большим количеством различных вариантов.
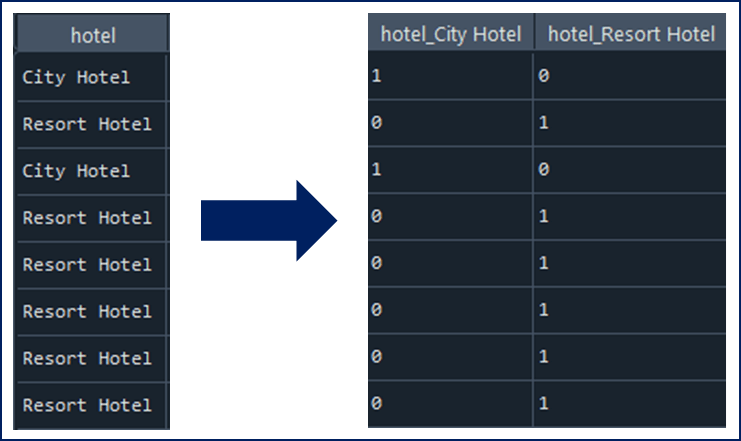
Затем для категориальных предикторов было выполнено однократное кодирование, чтобы осуществить переход от текста к числовому вводу. Это делается очень просто с помощью встроенной в Pandas функции get_dummies(). В этом примере «X» представляет собой матрицу данных признаков:
Например, столбец «отель», который содержит два разных класса, был преобразован в два разных столбца:
Наконец, нам нужно разделить данные на тестовые и обучающие, чтобы точно оценить достоверность моделей. Для этого проекта я использовал 70% для обучения и 30% для тестирования.
Обучение и оценка моделей классификации
Затем мы можем начать тестировать и проверять различные модели классификации, чтобы делать прогнозы, находить наиболее эффективные и анализировать предикторы, используемые при прогнозировании.
Были рассмотрены следующие типы моделей:
- K-ближайшие соседи
- Логистическая регрессия
- Наивный Байес
- Древо решений
- Случайный лес
Для некоторых из этих моделей требуется некоторая дополнительная подготовка данных (например, масштабирование), поскольку они зависят от геометрии данных. Это делается просто с помощью модуля предварительной обработки sklearn:
Каждая модель обучалась с использованием реализации sklearn и выполняла высокоуровневую настройку соответствующих параметров. Код для этого можно найти на моем GitHub, здесь. Результаты следующие:
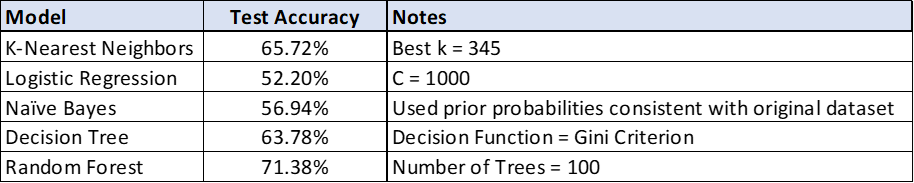
Случайный лес показал лучшие результаты на тестовом наборе по сравнению с другими четырьмя типами моделей с точностью предсказания класса ~ 71%. Это исключительная производительность, но дальнейшая настройка параметров, вероятно, может еще лучше подогнать модель под эти данные.
Параметры настройки и выбор функций
Определив лучший тип модели, мы можем затем настроить гиперпараметры. Существует множество способов настроить модель машинного обучения. Одним из наиболее распространенных является создание сетки параметров, которая содержит различные изменяющиеся значения, и тестирование перестановок, содержащихся в этой сетке. Здесь использовалась простая реализация GridSearchCV:
Этот код создает экземпляр GridSearchCV, принимает диапазоны параметров и проверяет точность каждой комбинации, чтобы вернуть лучшие из них. Затем он обучает новую модель, используя лучший набор параметров.
Наилучшие параметры пришлись на следующие:
- Максимальная глубина = 100
- Минимальные образцы на лист = 1
- Минимальные выборки для разделения = 2
- Количество деревьев = 200
Точность этой модели составила 78,62%, что примерно на 7% выше, чем у начальной модели обучения.
Затем мы можем использовать один из наиболее интригующих и интересных результатов модели случайного леса, чтобы выполнить выбор переменных и сократить количество функций, используемых в модели. Это выгодно по целому ряду причин, от упрощения модели до лучшего понимания того, какие функции наиболее важны для оценки количества специальных запросов, которые могут быть сделаны при бронировании. Выходные данные Random Forest в scikit-learn вычисляют значения важности признаков. Важность признака рассчитывается как вклад переменной в чистоту результирующих завершающих узлов, выполняющих классификацию. Затем важности нормализуются до [0, 1] для создания легко интерпретируемого вывода. На следующей диаграмме показаны 5 основных функций, возвращаемых моделью:
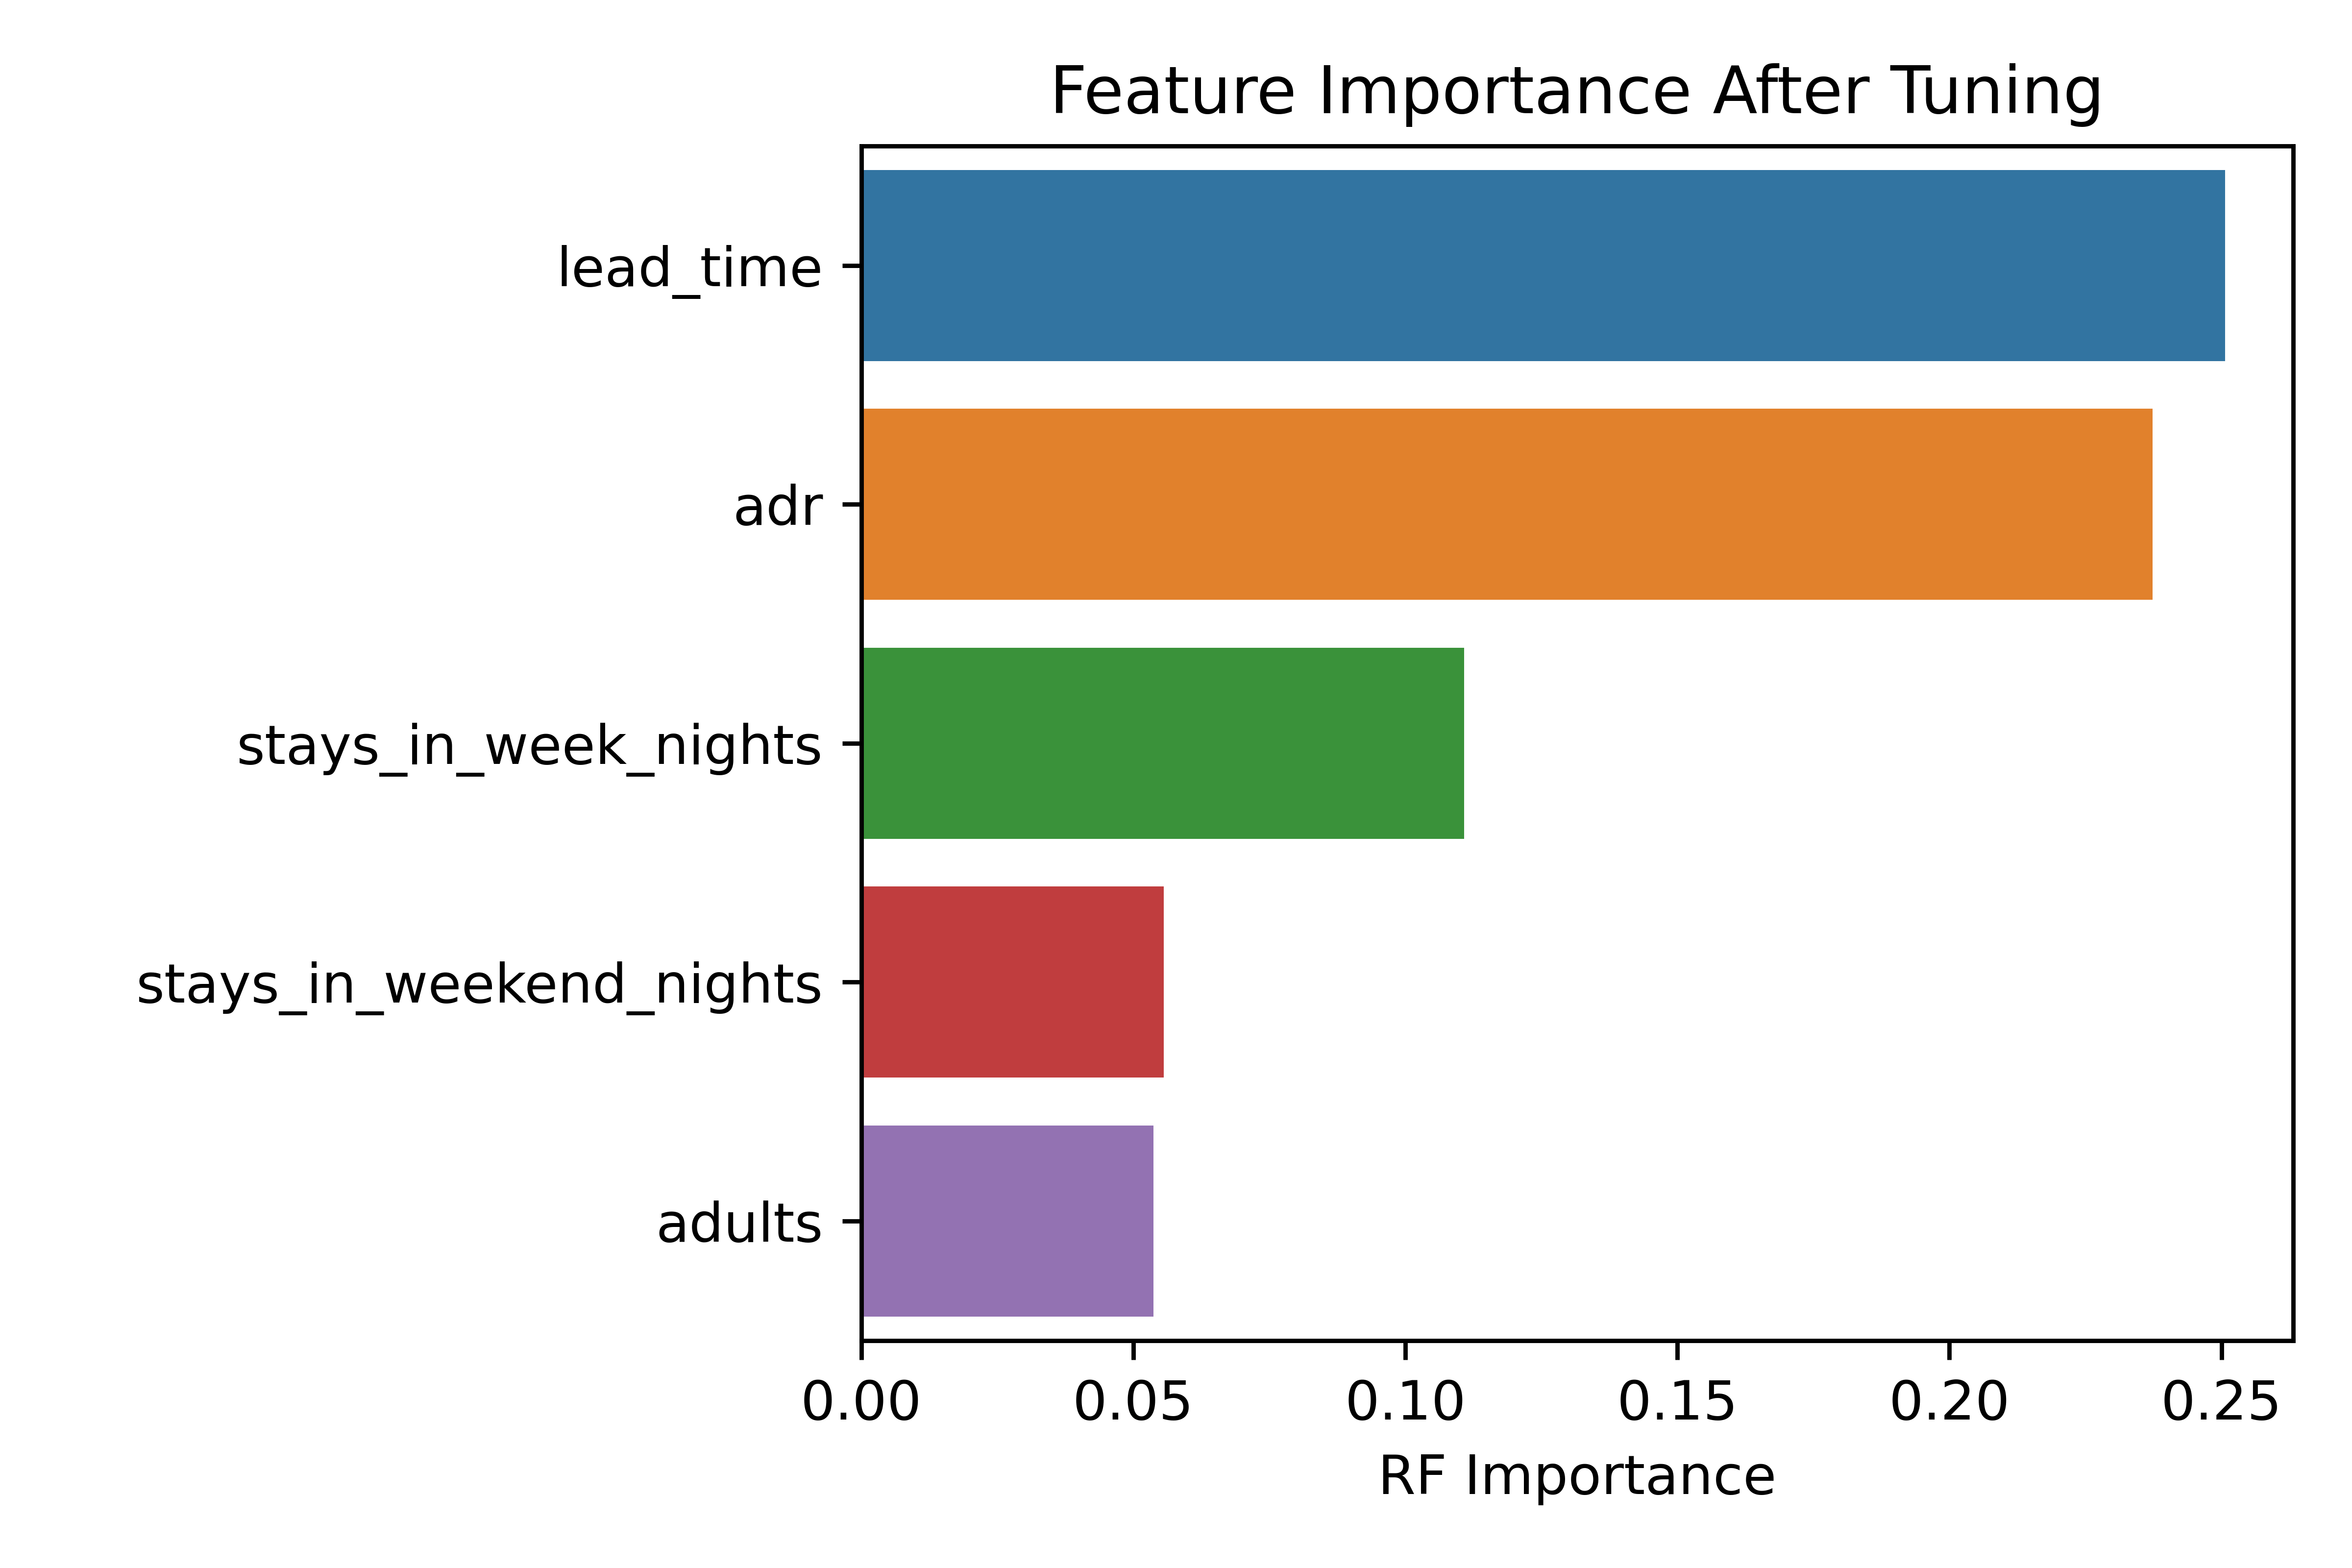
Время выполнения заказа и средний дневной доход очень важны для прогнозирования количества специальных запросов. Это чрезвычайно важное замечание, которое следует учитывать в контексте управления отелем.
Важность функции также можно использовать в машинном обучении как способ выбора переменных. Переоснащение модели с использованием только первых 5 с точки зрения важности функций дает точность на тестовом наборе 67,09%, что примерно на 11% ниже, чем у модели, использующей все переменные. Хотя это может показаться нелогичным, это более желательный результат, поскольку он свидетельствует о том, что модель со всеми переменными-предикторами, вероятно, является переобученной. Еще одним преимуществом является вычислительная эффективность; Модель случайного леса только с 5 переменными-предикторами намного быстрее и требует гораздо меньшей вычислительной нагрузки для отправки новых данных, чем модель с более чем 50 переменными-предикторами. Если бы нам нужно было сделать это для портфолио из тысячи объектов, стоимость увеличилась бы.
Окончательные результаты
Если бы управляющий отелем или курортом воспользовался этим анализом и получил единственную информацию, это было бы так:
- Бронирования с более высоким средним дневным доходом и заблаговременное бронирование, как правило, вызывают больше специальных запросов.
Этот вывод добавляет данные в пользу давнего и широко распространенного мнения о ведении бизнеса в сфере гостеприимства, ориентированной на клиента; клиенты, которые планируют и исследуют свои покупки и платят больше, ожидают получить больше.
Благодарности и дополнения
Этот анализ стал возможен благодаря сборщикам исходного набора данных, цитируемого ранее. Их целью было использовать данные для прогнозирования спроса, что сделало этот анализ новым подходом к использованию этих данных.
Дополнительные расширения этого анализа могут включать:
- Подход к прогнозированию временных рядов, если бы было доступно больше данных
- Изучение спроса на разные виды спецзапросов и возможности их монетизации.
- Анализ общего количества специальных запросов, сделанных в объекте размещения на уровне дня, а не на уровне бронирования, чтобы лучше подготовить отель к работе в течение дня.
Весь код этого проекта можно найти на моем GitHub, здесь.
Если вы нашли это интересным, не стесняйтесь добавить меня в LinkedIn здесь или подпишитесь на мой Medium, чтобы узнать о других проектах.





