

Опорный вектор вектор машина — это популярный алгоритм обучения с учителем, используемый для задач классификации и регрессии. Он используется как для классификации, так и для регрессии, но в основном для задач классификации. Лучший способ понять алгоритм SVM — сосредоточиться на его основном типе, классификаторе SVM. Идея классификатора SVM состоит в том, чтобы создать гиперплоскость в N-мерном пространстве, которая разделяет точки данных, принадлежащие разным классам. Однако эта гиперплоскость выбирается на основе поля, поскольку рассматривается гиперплоскость, обеспечивающая максимальное расстояние между двумя классами. Эти поля рассчитываются с использованием точек данных, известных как опорные векторы. Опорные векторы — это те точки данных, которые находятся рядом с гиперплоскостью и помогают ориентировать ее.
Далее объясняются такие термины, как гиперплоскость, поля, опорные векторы.
Гиперплан
Как мы видим на приведенной выше диаграмме, это плоскость принятия решений или пространство, которое разделено между набором объектов разных классов.
Работа SVM
Модель SVM представляет собой представление различных классов в гиперплоскости в многомерном пространстве. Гиперплоскость будет генерироваться SVM итеративно, чтобы можно было минимизировать ошибку. Цель SVM — разделить наборы данных на классы, чтобы найти максимальную предельную гиперплоскость (MMH).
Теперь о классификации. Мы хотим классифицировать точки данных для двух классов. Три различные линии классификации ниже могут быть способами его построения. Есть ли причина, по которой один лучше другого? SVM поможет нам в этом.
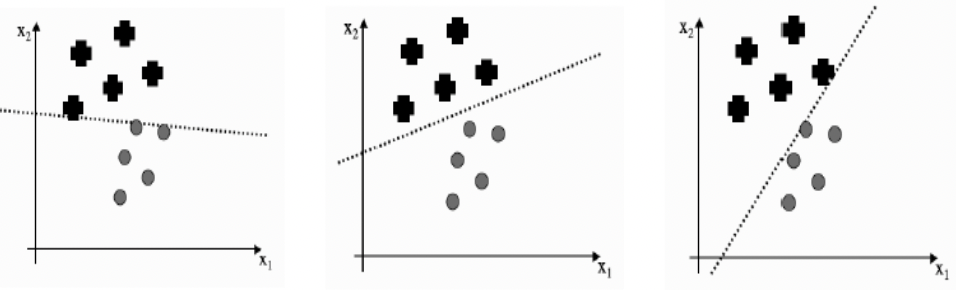
Многие из нас могут подумать, глядя на диаграмму, что нет никакой разницы между логистической регрессией и SVM… поскольку они оба используются для решения задач классификации (сортировка данных по категориям), ну… эти двое. Эта разница и есть ПРЕДЕЛЬНОЕ РАССТОЯНИЕ.
ПРЕДЕЛЬНОЕ РАССТОЯНИЕ
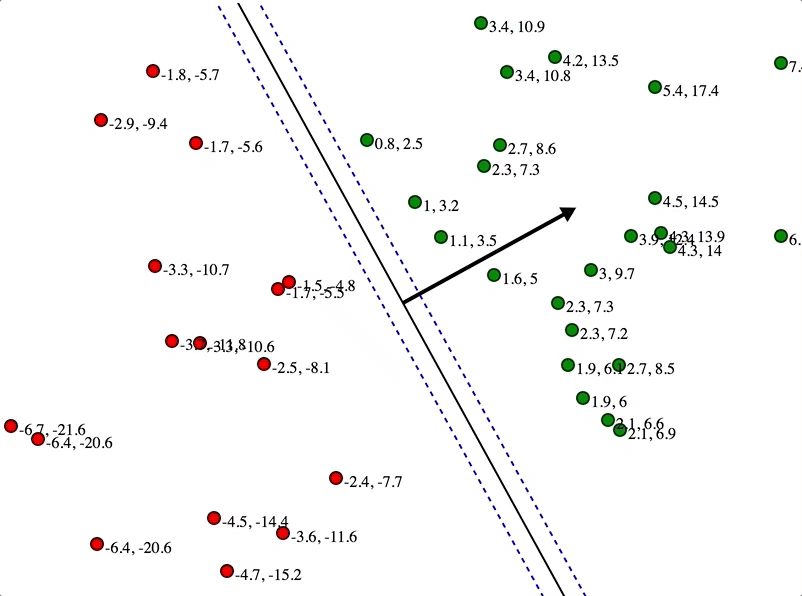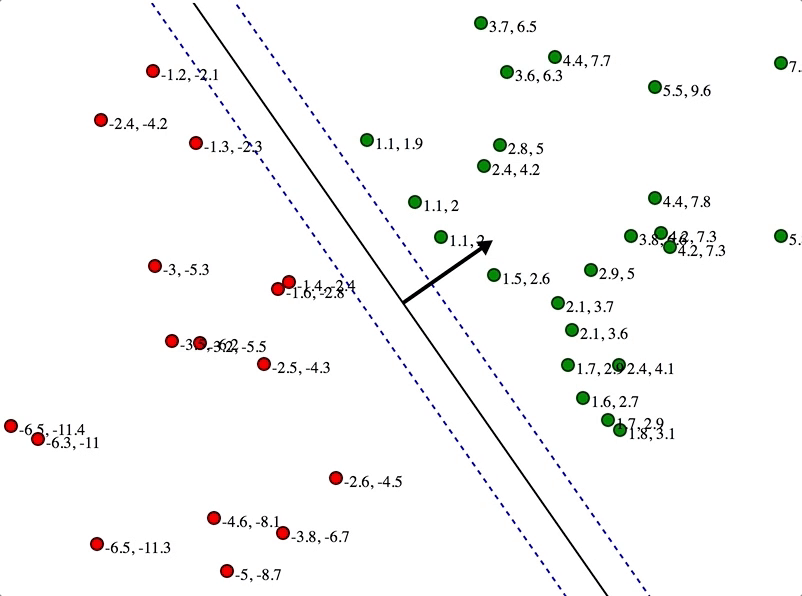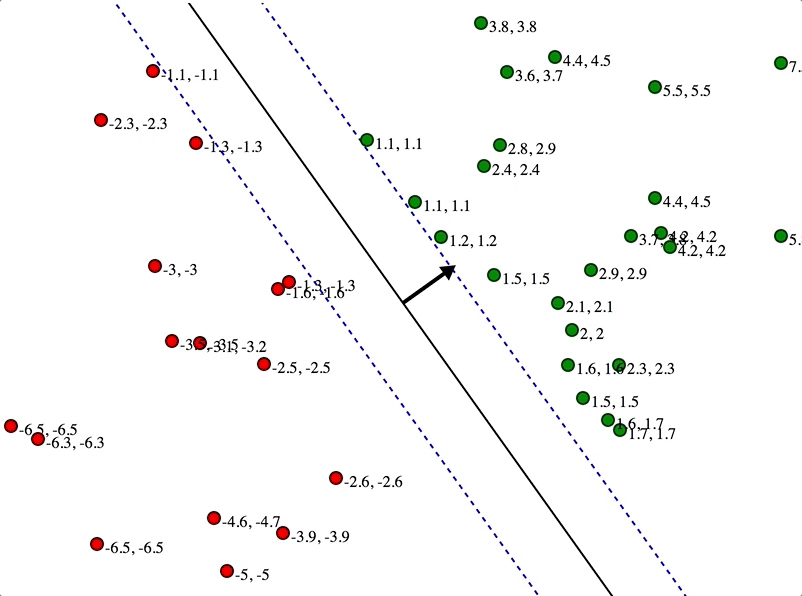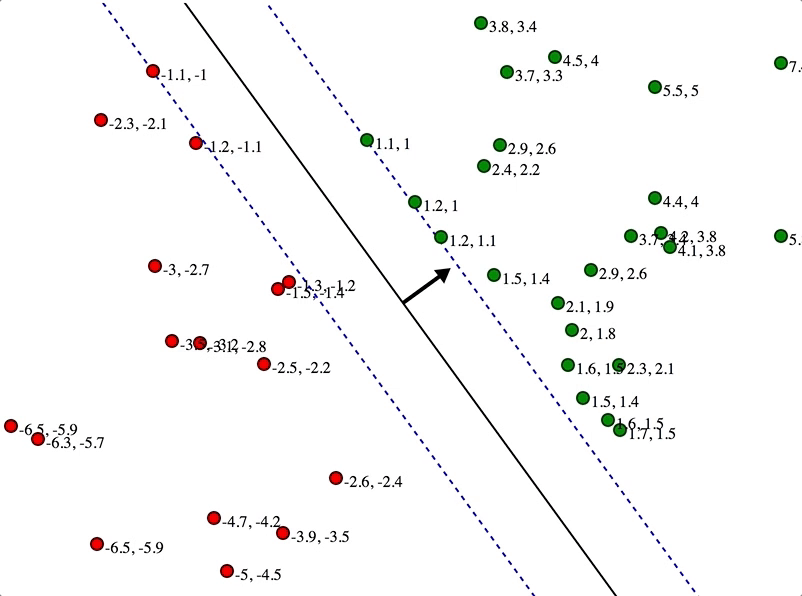
Представьте себе размещение нейтральной зоны вокруг линии, чтобы каждая точка в этой области была объявлена слишком близко к линии, чтобы ее можно было правильно классифицировать. Эта область симметрична относительно линии (ГИПЕРПЛОСКОСТИ), так что она образует цилиндр вокруг линии в 3D. Это известно как «ПРЕДЕЛЬНОЕ РАССТОЯНИЕ» или «ЗАПАД», КОТОРОЕ МЫ ПЫТАЕМСЯ МАКСИМАЛЬНО УВЕЛИЧИТЬ, т.е. в трехмерной фигуре мы стараемся максимизировать радиус. Хорошая маржа позволяет очкам находиться в соответствующих классах, не переходя в другие классы.
ОПОРНЫЕ ВЕКТОРЫ
- Точки данных в каждом классе, расположенные ближе всего к линии классификации, называются векторами поддержки.
- Опорные векторы находятся на максимально возможном расстоянии от гиперплоскости.
- Два класса лежат по разные стороны гиперплоскости.
Используя аргумент о том, что лучший классификатор — это тот, который проходит через середину ничейной земли, мы можем сделать следующий вывод:
- во-первых, маржа должна быть как можно больше
- во-вторых, опорные векторы являются наиболее полезными точками данных, потому что именно в них мы можем ошибиться.
ЛЮБОПЫТНЫЙ ФАКТ
ПОСЛЕ ОБУЧЕНИЯ МОДЕЛИ ВСЕ ДРУГИЕ ТОЧКИ ДАННЫХ, КРОМЕ ОПОРНЫХ ВЕКТОРОВ, МОГУТ БЫТЬ ОТМЕНЕНЫ, ПОЭТОМУ СОХРАНЯЕТ ПАМЯТЬ. ПОЭТОМУ ТЕПЕРЬ МОДЕЛЬ МОЖНО СОХРАНИТЬ ТОЛЬКО С ТОЧКАМИ ОПОРНОГО ВЕКТОРА!

ЛИНЕЙНО РАЗДЕЛИМЫЕ ДАННЫЕ

SVM учитывает все точки данных и выдает линию под названием «Hyperplane», которая разделяет оба класса. Эта строка называется «Граница решения». Все, что попадает в класс круга, будет принадлежать классу А и наоборот. Все, что мы рассмотрели выше, было связано с ЛИНЕЙНО РАЗДЕЛИМЫМИ ДАННЫМИ.
ЛИНЕЙНО НЕРАЗДЕЛИМЫЕ ДАННЫЕ
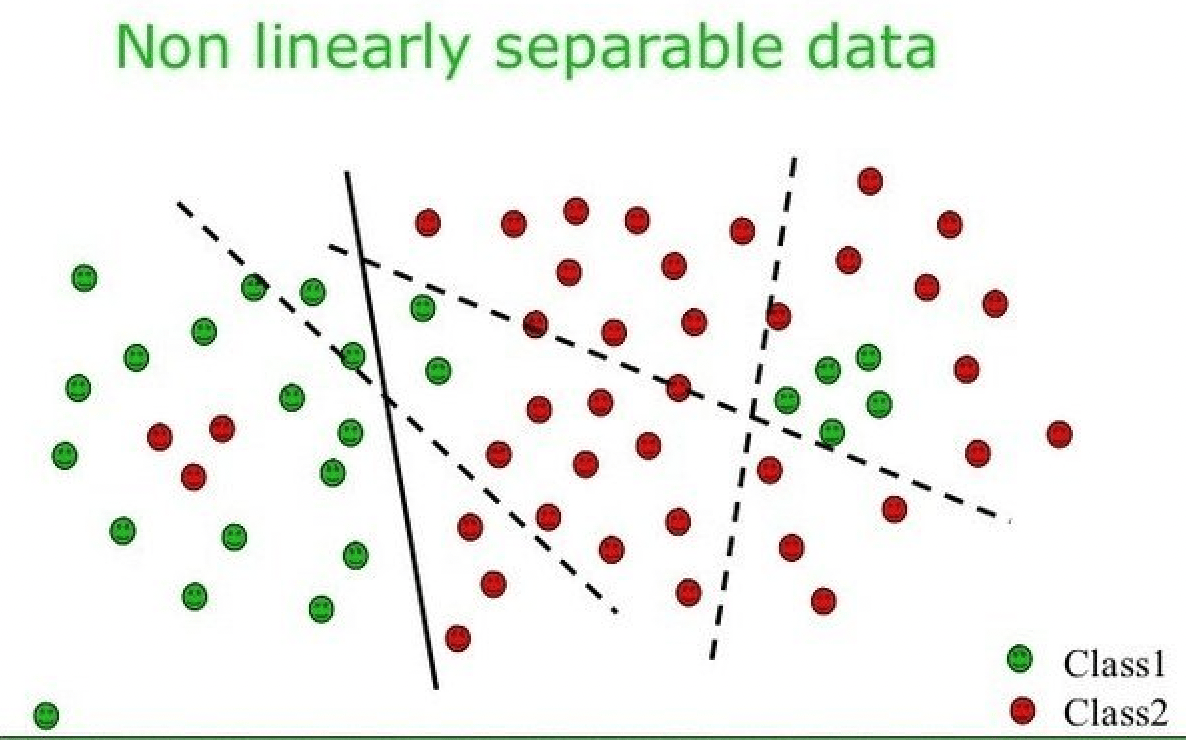
Если данные не являются линейно разделимыми, линейная классификация не может точно различить два класса, как показано на рисунке выше, тогда SVM использует KERNAL TRICKS, чтобы сделать его линейно разделимым. Концепция преобразования нелинейно разделимых данных в линейно разделимые.
КЕРНАЛС
Ядро SVM — это функция, которая берет маломерное входное пространство и преобразует его в многомерное пространство, т. е. преобразует неразделимую задачу в разделимую. Ядра — это способ решать нелинейные задачи с помощью линейных классификаторов. Функции ядра используются в качестве параметров в кодах SVM. Они помогают определить форму гиперплоскости и границы решения.

1. Если мы каким-то образом изменим характеристики, то сможем линейно разделить данные.
2. Если мы сможем использовать больше измерений, то сможем найти линейную границу решения, разделяющую классы.
3. Итак, все, что нам нужно сделать, это выяснить, какие дополнительные измерения можно получить с помощью ядер.
ПРЕИМУЩЕСТВА СВМ
- SVM очень хороши, когда мы не имеем ни малейшего представления о данных.
- Хорошо работает даже с неструктурированными и полуструктурированными данными, такими как текст, изображения и деревья.
- Фокус с ядром — настоящая сила SVM. С соответствующей функцией ядра мы можем решить любую сложную проблему.
- Он относительно хорошо масштабируется для высокоразмерных данных.
- Модели SVM имеют обобщение на практике, риск переобучения меньше в SVM.
Спасибо, счастливого обучения!





