
Прогнозирование мошенничества с кредитными картами с помощью персептрона.
Нейроны и искусственные нейронные сети, которые они создают, сегодня лежат в основе самых сложных моделей машинного обучения. Эти нейронные сети, являющиеся блестящим примером биовдохновения, произошли от менее популярного алгоритма под названием «Персептрон», подобно тому, как все живое на Земле произошло от одноклеточных организмов.
Идея персептрона была впервые выдвинута Маккаллохом и Питтсом в 1943 году. Впервые она была реализована в Корнеллской авиационной лаборатории Фрэнком Розенблаттом в 1958 году. Фрэнк Розенблатт по профессии, что неудивительно, был психологом.

Теория
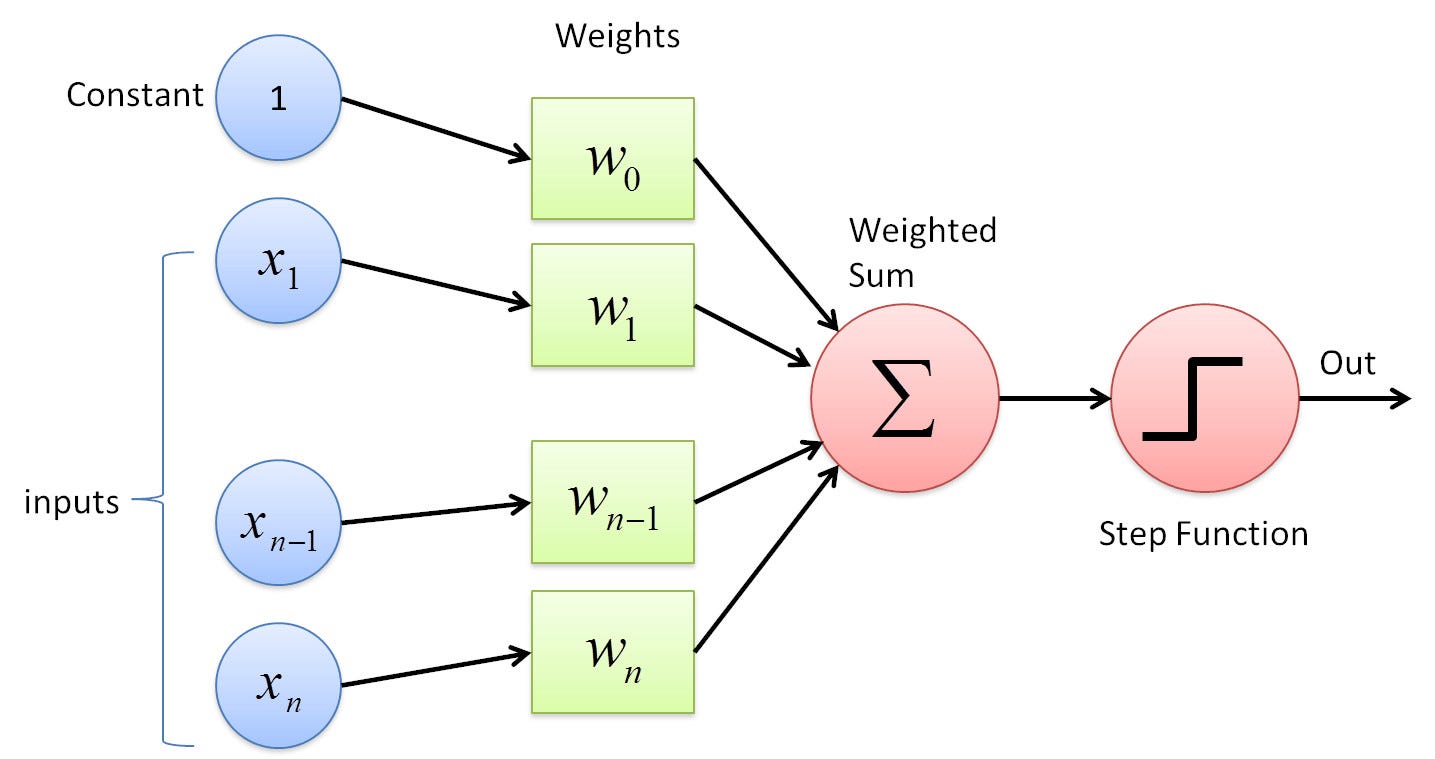
Выше приведено представление персептрона. Для каждого входа есть соответствующий вес. Во время прогнозирования взвешенная сумма входных данных передается в ступенчатую функцию, которая классифицирует ее в один из ожидаемых классов.
Думайте о каждом весе как о ручке, которую мы можем отрегулировать. Во время обучения нейронной сети мы настраиваем эти ручки, чтобы получить наилучшую возможную конфигурацию для решения поставленной задачи.
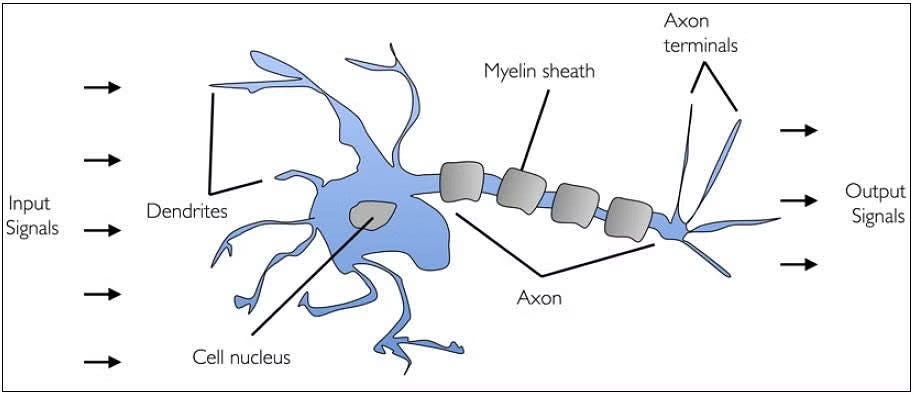
Это очень упрощенное описание того, как работает персептрон. Эта операция примерно аналогична работе биологического нейрона, хотя есть некоторые заметные отличия. Вы можете увидеть визуальное сходство между биологическим нейроном, приведенным ниже, и персептроном, приведенным выше.
Прогнозирование мошенничества с кредитными картами
Этот код можно найти по адресу https://github.com/kumuthu53/perceptron-credit-card-fraud.
Используемый набор данных можно найти по адресу https://www.kaggle.com/datasets/mlg-ulb/creditcardfraud.
Теперь я буду использовать Perceptron для прогнозирования мошенничества с кредитными картами. Для этого я буду использовать набор данных (источник указан выше), содержащий транзакции, совершенные по кредитным картам в сентябре 2013 года европейскими держателями карт.
Во-первых, мы должны прочитать данные.
df = pd.read_csv('data/creditcard.csv')
df.head()
Давайте посмотрим на структуру набора данных. Он имеет 31 столбец, которые включают функции от V1 до V28, время, сумму транзакции и класс. В столбце класса мошенничеству присваивается 1, а законной транзакции — 0. Время — это время, прошедшее с момента первой транзакции в наборе данных. Функции с V1 по V28 являются результатом преобразования набора данных методом анализа основных компонентов (PCA). По понятным причинам нельзя указать необработанные характеристики транзакции, такие как номер карты и срок действия.
В машинном обучении мы должны очистить набор данных перед его использованием. В этом случае столбец времени не следует использовать, поскольку он не имеет отношения к тому, является ли транзакция мошенничеством или нет. Поэтому его следует удалить.
# Remove the column 'Time'.
df = df.drop(["Time"], axis=1)
df.head()
Теперь давайте подробно рассмотрим данные. Я подсчитал процент срабатываний (мошенничества) от общего количества транзакций.
# Positives.
positives = df[df.Class == 1]
print("Num positives\t\t:", len(positives))
print("Total number\t\t:", len(df))
print("Positive percentage\t:", round((len(positives) / float(len(df))), 6), "%")
Выход:
Num positives		: 492
Total number		: 284807
Positive percentage	: 0.001727 %
Как мы видим, это крайне несбалансированный набор данных. У нас всего 492 мошенничества на 284807 транзакций с процентом мошенничества 0,001727%.
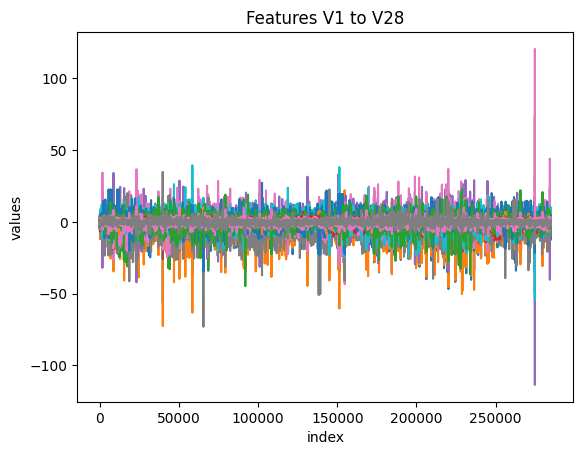
Теперь давайте визуализируем оставшиеся функции, чтобы получить представление об их диапазонах.
Визуализация функций с V1 по V28. Каждая функция выделена другим цветом.
# Visualise features V1 to V28.
plt_time = df.loc[:,df.columns.str.startswith("V")].plot(title="Features V1 to V28")
plt_time.set_xlabel("index")
plt_time.set_ylabel("values")
plt_time.get_legend().remove()
Выход:
Визуализация сумм.
# Visualise amount.
plt_time = df["Amount"].plot(title="Amount")
plt_time.set_xlabel("index")
plt_time.set_ylabel("amount")
Выход:
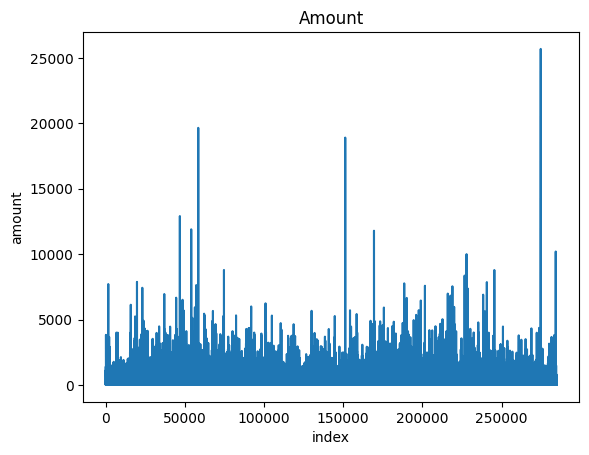
Глядя на эти визуализации, мы видим, что диапазоны разных столбцов сильно различаются. Поэтому имеет смысл масштабировать все эти функции в один диапазон, что мы и сделаем позже.
Чтобы создать модель для прогнозирования мошенничества с кредитными картами, мы должны использовать этот набор данных для обучения, а также для тестирования этой модели. Для этого мы разделим этот набор данных на обучающие и тестовые данные. Мы также должны разделить его на входы (X) и выходы (y).
X_train, X_test, y_train, y_test = train_test_split(X, y, stratify=y, test_size=0.30, random_state=42)
Теперь набор данных разделен на тестовые данные (30%) и обучающие данные (70%).
Как мы решили ранее, давайте масштабируем все входные данные.
# Scale the inputs.

scaler = MinMaxScaler()

scaler.fit(X_train)

scaler.transform(X_train)
scaler.transform(X_test)
Я использовал функцию MinMaxScaler() от scikit-learn, которая имеет диапазон по умолчанию от 0 до 1. Мы подгоняем масштабатор только к входным данным поезда и использовали его для масштабирования как тестовых входных данных, так и входных данных обучения.
Мы подгоняем масштабер только к входным данным поезда, а не ко всем входным данным, потому что мы должны соблюдать принцип машинного обучения обучения только на обучающих данных.
Нет, мы готовы создать модель и подогнать данные. Мы будем использовать реализацию алгоритма Perceptron от scikit-learn.
model = Perceptron(n_iter_no_change= 15,
                   random_state=42)

model.fit(X_train, y_train)
В модели Perceptron я только изменил параметры по умолчанию для количества итераций, для которых модель должна продолжать итерацию, когда нет улучшений. Полный список настраиваемых параметров см. на странице ‹https://scikit-learn.org/stable/modules/generated/sklearn.linear_model.Perceptron.html#sklearn.linear_model.Perceptron›.
Затем я вписываю в модель тренировочные входные данные и тренировочные цели.
Теперь мы можем использовать эту модель для прогнозирования классов для тестовых входных данных.
y_pred = model.predict(X_test)
Посмотрим, насколько хорошо мы справились. Наиболее распространенной метрикой, используемой для оценки производительности модели, является точность.
# Accuracy.
accuracy_score(y_test, y_pred)
Выход:
0.9990285921608558
Точность очень высока и составляет 99,903%. Однако в этом случае точность не является хорошей метрикой. Это связано с тем, что это чрезвычайно несбалансированный набор данных, в котором только 0,001727% записей являются мошенничеством. Если бы модель просто классифицировала каждую запись как не являющуюся мошенничеством, точность была бы столь же высокой.
Для детальной оценки давайте посмотрим на матрицу путаницы.
# Confusion matrix.
confusion_matrix(y_test, y_pred)
Выход:
array([[85244,    51],
       [   32,   116]])
В этой матрице путаницы строки представляют собой фактические классы (отрицательные и положительные значения сверху вниз), а столбцы — это предсказанные классы (отрицательные и положительные значения слева направо).
Как видим, из 148 фактических мошенничеств 116 (78,38%) являются прогнозируемыми. Также из 167 прогнозируемых случаев мошенничества 116 (69,46%) являются фактически мошенничеством.
Я считаю, что это хорошая производительность. Если бы была создана система для пометки подозрительных транзакций с помощью этой модели, она бы отмечала высокий процент мошенничества, а также производила лишь небольшое количество ложных срабатываний (0,000597%).
Производительность персептрона
По сравнению с современными нейронными сетями у персептронов есть слабость. Они могут решать только линейно разделимые задачи. Это означает, что негативы и позитивы должны быть разделены одной гиперплоскостью.
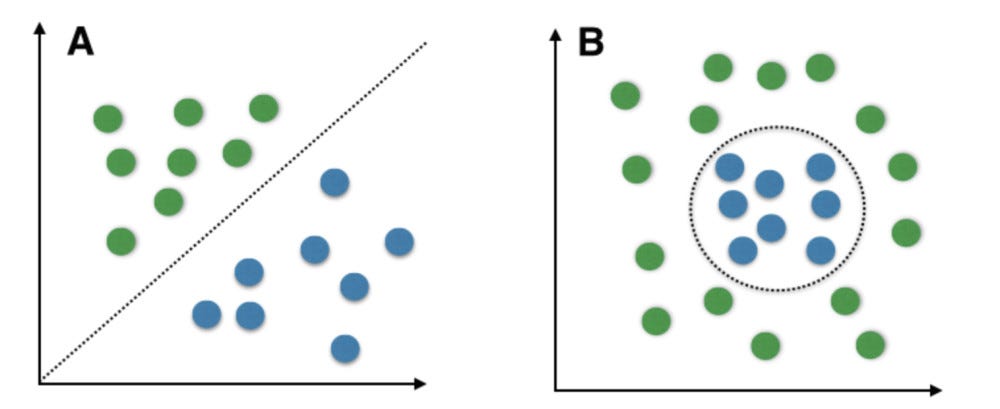
Несмотря на то, что по этой причине персептроны в настоящее время не используются широко, полезно изучить их, чтобы понять более продвинутые типы нейронных сетей.





