
Правильная работа с категориальными данными в моделях машинного обучения!
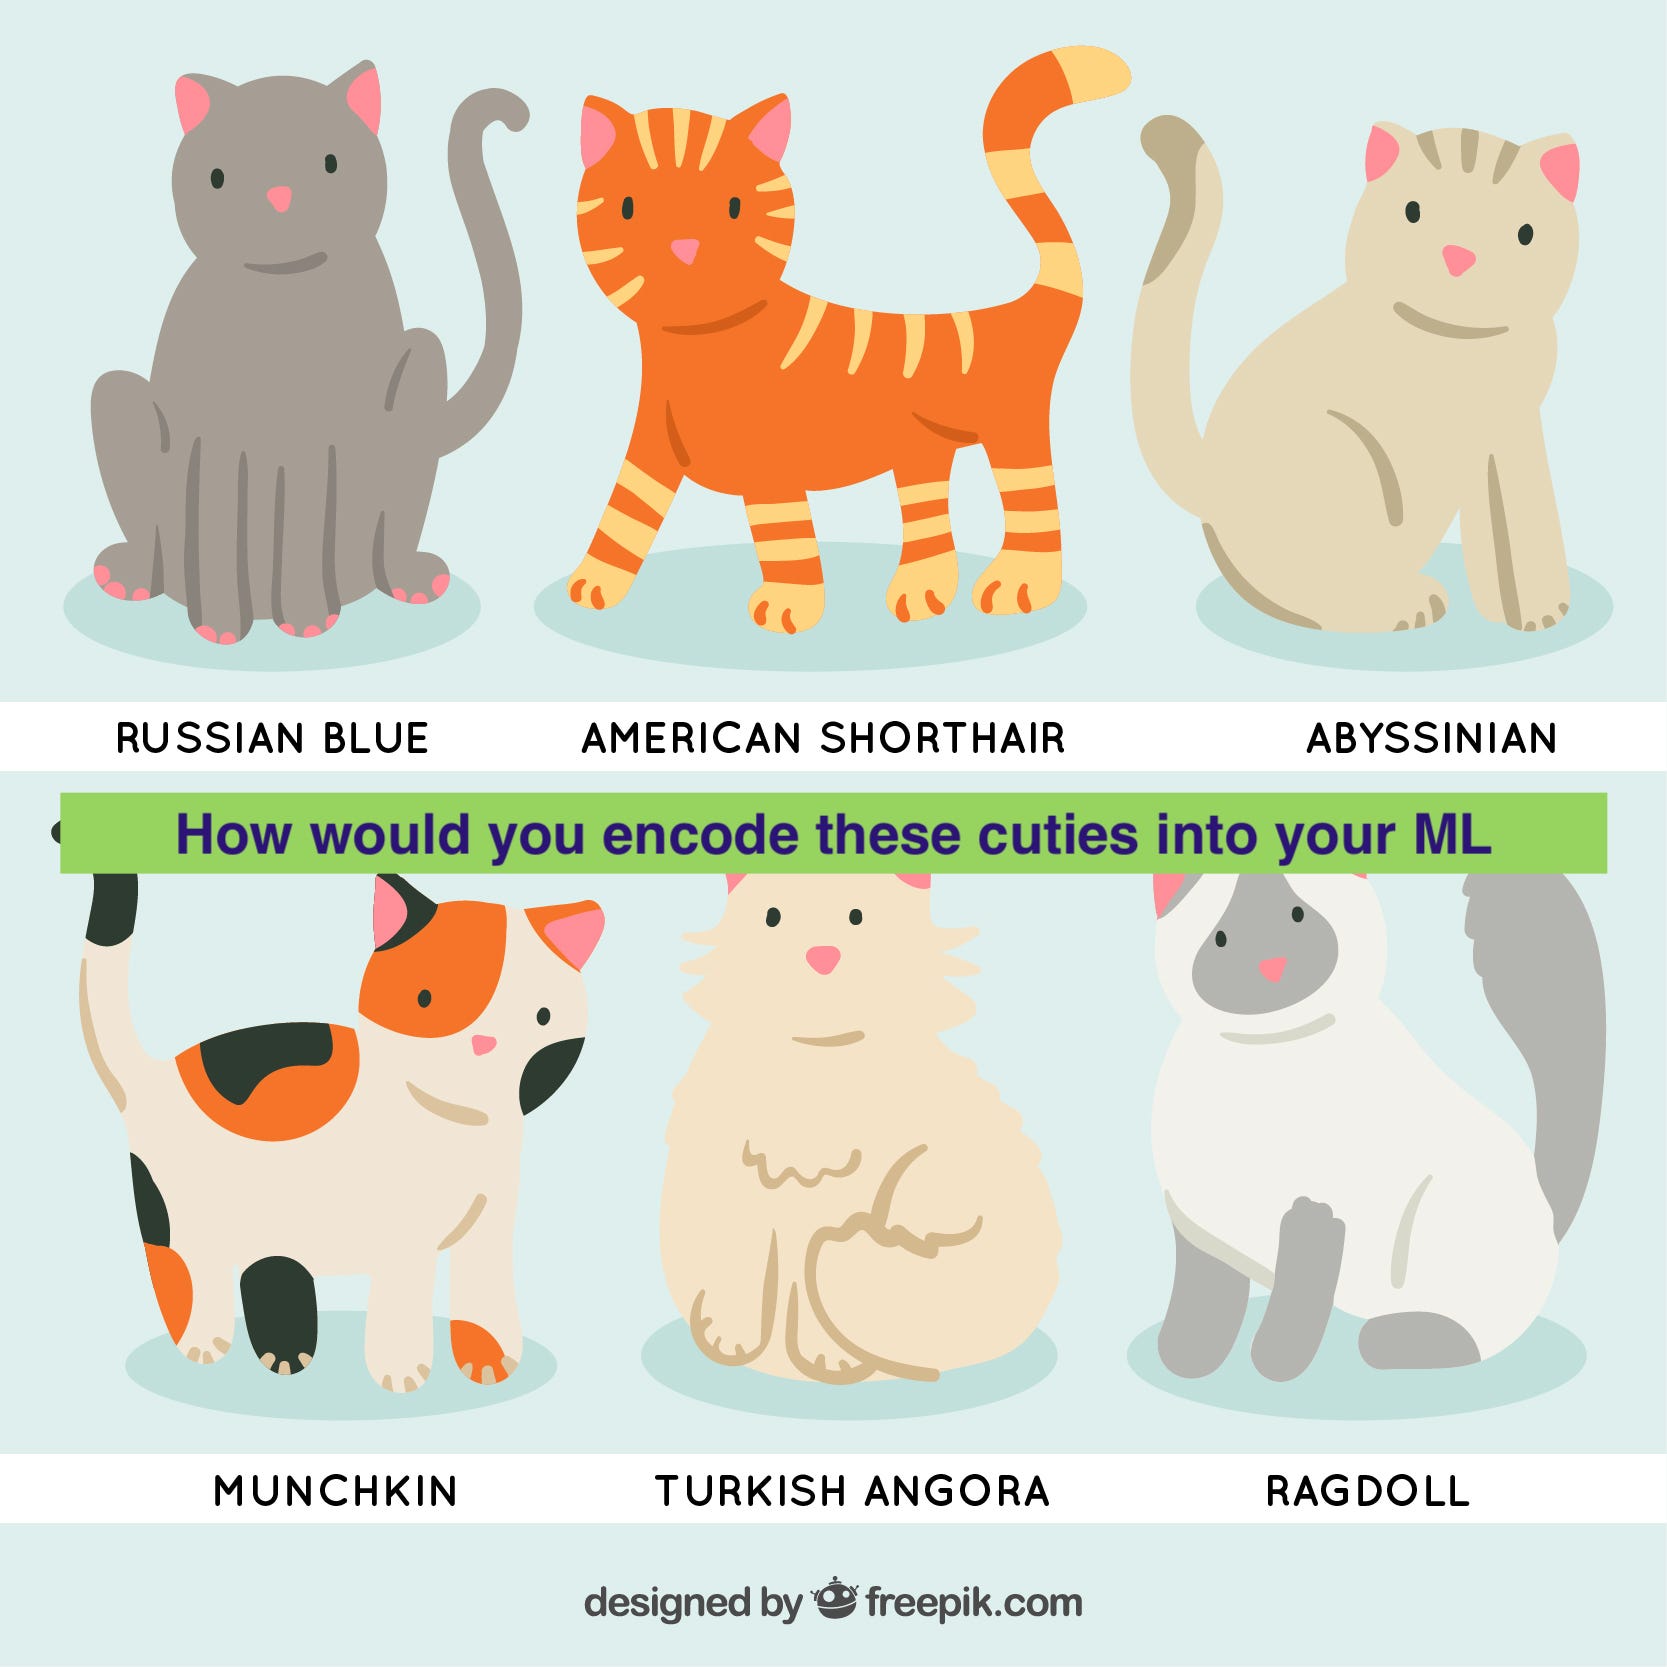
Большинство алгоритмов машинного обучения не понимают категориальные данные (например, породу кошек, как в приведенном выше наборе данных).
Как мы можем заставить алгоритмы ML понимать такие категориальные значения?
Мы могли бы полностью избавиться от категориальных данных и тренироваться только на числовых данных. Ваша модель, вероятно, будет не такой различительной, как с категориальными значениями (подаваемыми в алгоритм ML так, как он понимает).
Лучшим подходом было бы преобразование таких категориальных значений в числа. Но как?
На самом деле это довольно распространено в ML. Этот процесс преобразования категорийных значений в числовые значения называется кодированием.
Хотя существует множество способов кодирования, два наиболее популярных подхода — меточное кодирование и горячее кодирование.

Какую кодировку следует использовать для моего категориального столбца?
Это зависит! (Обычно это лучший ответ на любой вопрос)
Это зависит от типа категориального поля, с которым вы имеете дело, а также от модели алгоритма машинного обучения, которую вы используете (например, не используйте одно горячее кодирование, если вы используете древовидные алгоритмы). Если категориальное поле упорядочено естественным образом, мы используем кодировку меток.
Вы заметили одну оговорку с кодировщиком меток выше?
Хороший улов! Мы ожидаем, что холодный -> 0, теплый -> 1 и горячий -> 2 сохранят порядок и будут иметь некоторую меру температуры. Однако sklearn LabelEncoder присваивает номера в другом порядке.
import pandas as pd
from sklearn.preprocessing import LabelEncoder
df_w = pd.DataFrame({"weather": ['hot', 'warm', 'cold']})
LabelEncoder().fit_transform(df_w['weather'])
Выход:
array([1, 2, 0])
Почему? Есть предположения?
LabelEncoder упорядочивает категориальные значения в алфавитном порядке, а затем присваивает целочисленное значение, начиная с нуля.
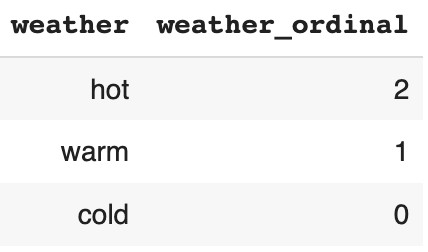
Нет простого способа сообщить порядок вашей программе. Вы должны либо заказать их самостоятельно, либо создать явную карту, как показано ниже, а затем использовать старую добрую функцию карты в Pandas.
weather_map = {"cold": 0, "warm": 1, "hot": 2}
df_w['weather_ordinal'] = df_w['weather'].map(weather_map)
Выход:
Почему этот порядок имеет значение?
Модели ML, как правило, создают «виртуальные сопоставления» с точками данных с похожими значениями в непосредственной близости и разными значениями в разных регионах. Предварительная обработка наших данных, чтобы сообщить модели ML, что они на самом деле упорядочены, помогает модели ML работать лучше.
А теперь вернемся к основной теме сегодняшнего дня. Когда нам следует использовать кодирование One Hot? И как?
Мы используем его, когда порядок не имеет значения или когда данные не должны быть упорядочены, чтобы давать неверные сигналы модели ML!
Возьмем, к примеру, породы кошек: британская короткошерстная, бенгальский и ширази. Можем ли мы упорядочить их каким-либо образом, который имеет смысл? Не совсем.
В этом случае мы хотим сообщить модели ML, что расстояние между этими породами равно. Один из способов сделать это — использовать одну горячую кодировку. Он не накладывает никакого порядка на закодированные значения.

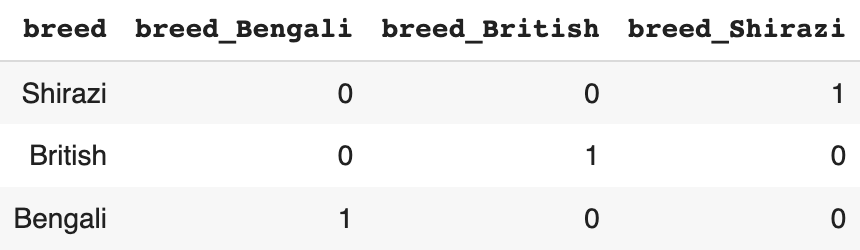
Если вы вычислите евклидово расстояние между этими точками данных, вы легко обнаружите, что это всегда квадратный корень из 2. В этом суть одного горячего кодирования!
Один из популярных способов выполнить одно горячее кодирование — использовать метод pandas get_dummies.
Следующий фрагмент кода показывает это:
df_c = pd.DataFrame({"breed": ["Shirazi", "British", "Bengali"]})
#get the one hot encoding and then concat with the original DF
pd.concat([df_c, pd.get_dummies(df_c[["breed"]])], axis = 1)
Это здорово. Вы можете спросить: «Я не понимаю, почему мы не можем использовать одни и те же get_dummies с набором данных, который я собираюсь обучить модели машинного обучения!».
При этом есть несколько проблем.
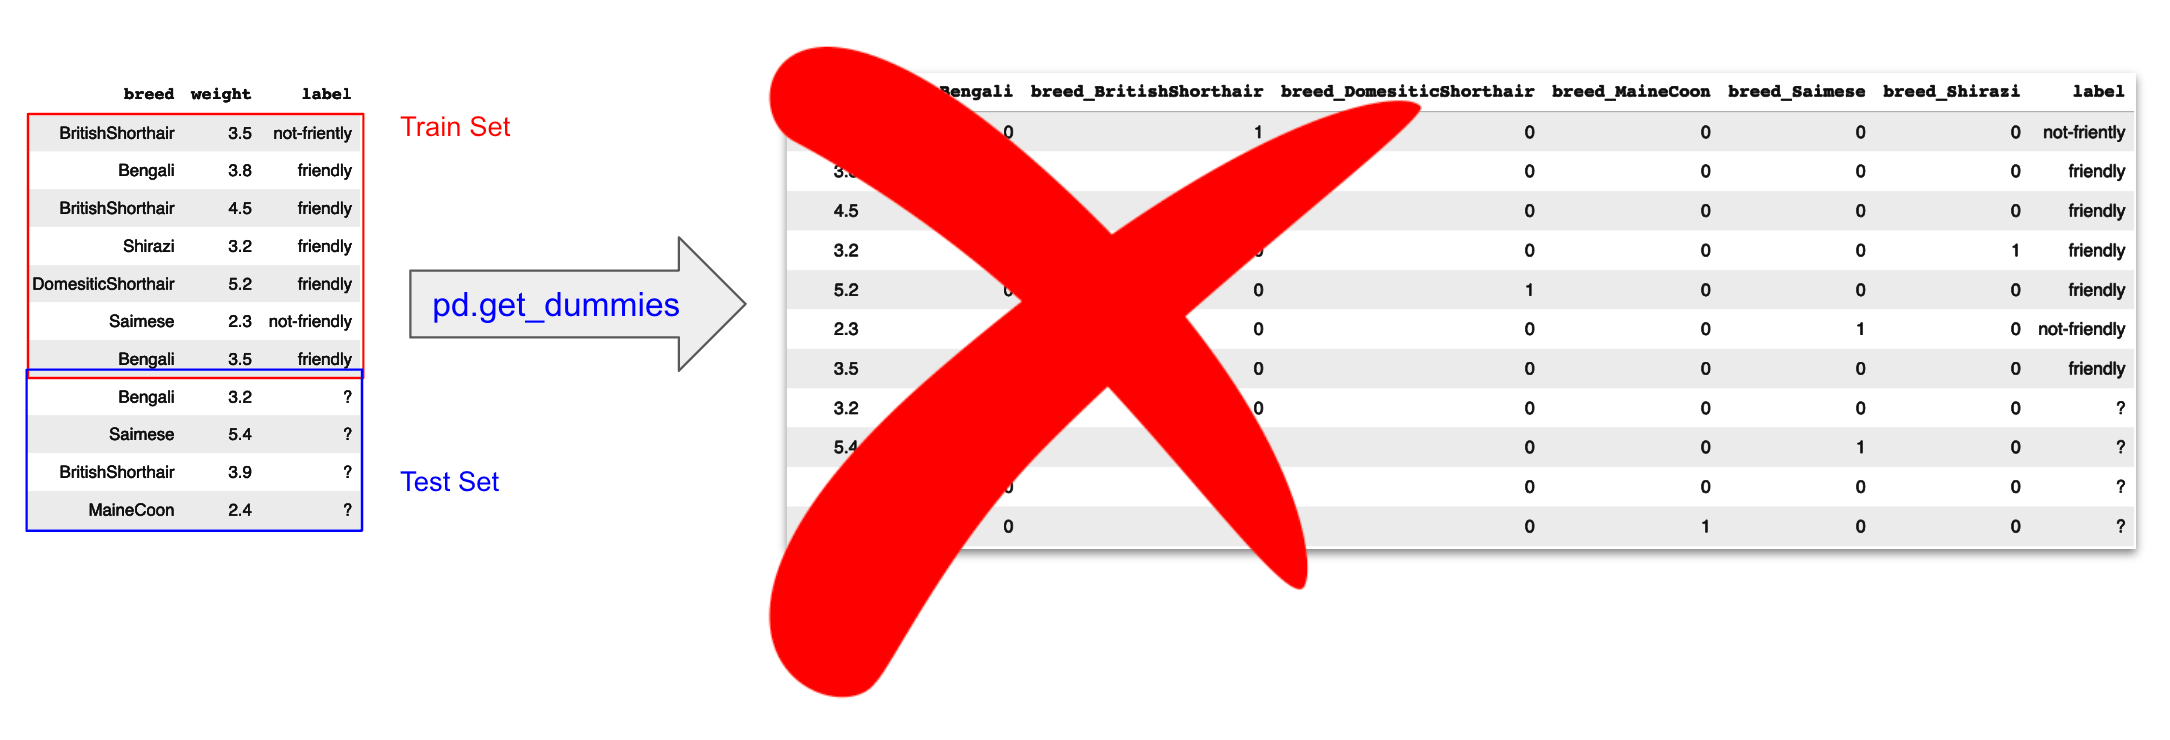
Если бы мы могли применить get_dummies ко всему набору данных — в какой-то степени это сработало бы. НО, ЭТО НЕПРАВИЛЬНО! Предвзятость закрадывается в ваши данные тестирования. Позволь мне объяснить.
При построении модели машинного обучения я не могу не подчеркнуть важность отделения тестового набора от обучающего в начале, прежде чем вы будете выполнять какое-либо кодирование или масштабирование.
Допустим, мы разделяем наш набор данных о кошках на наборы для обучения и тестирования, как показано ниже, а затем выполняем одно горячее кодирование столбца породы.
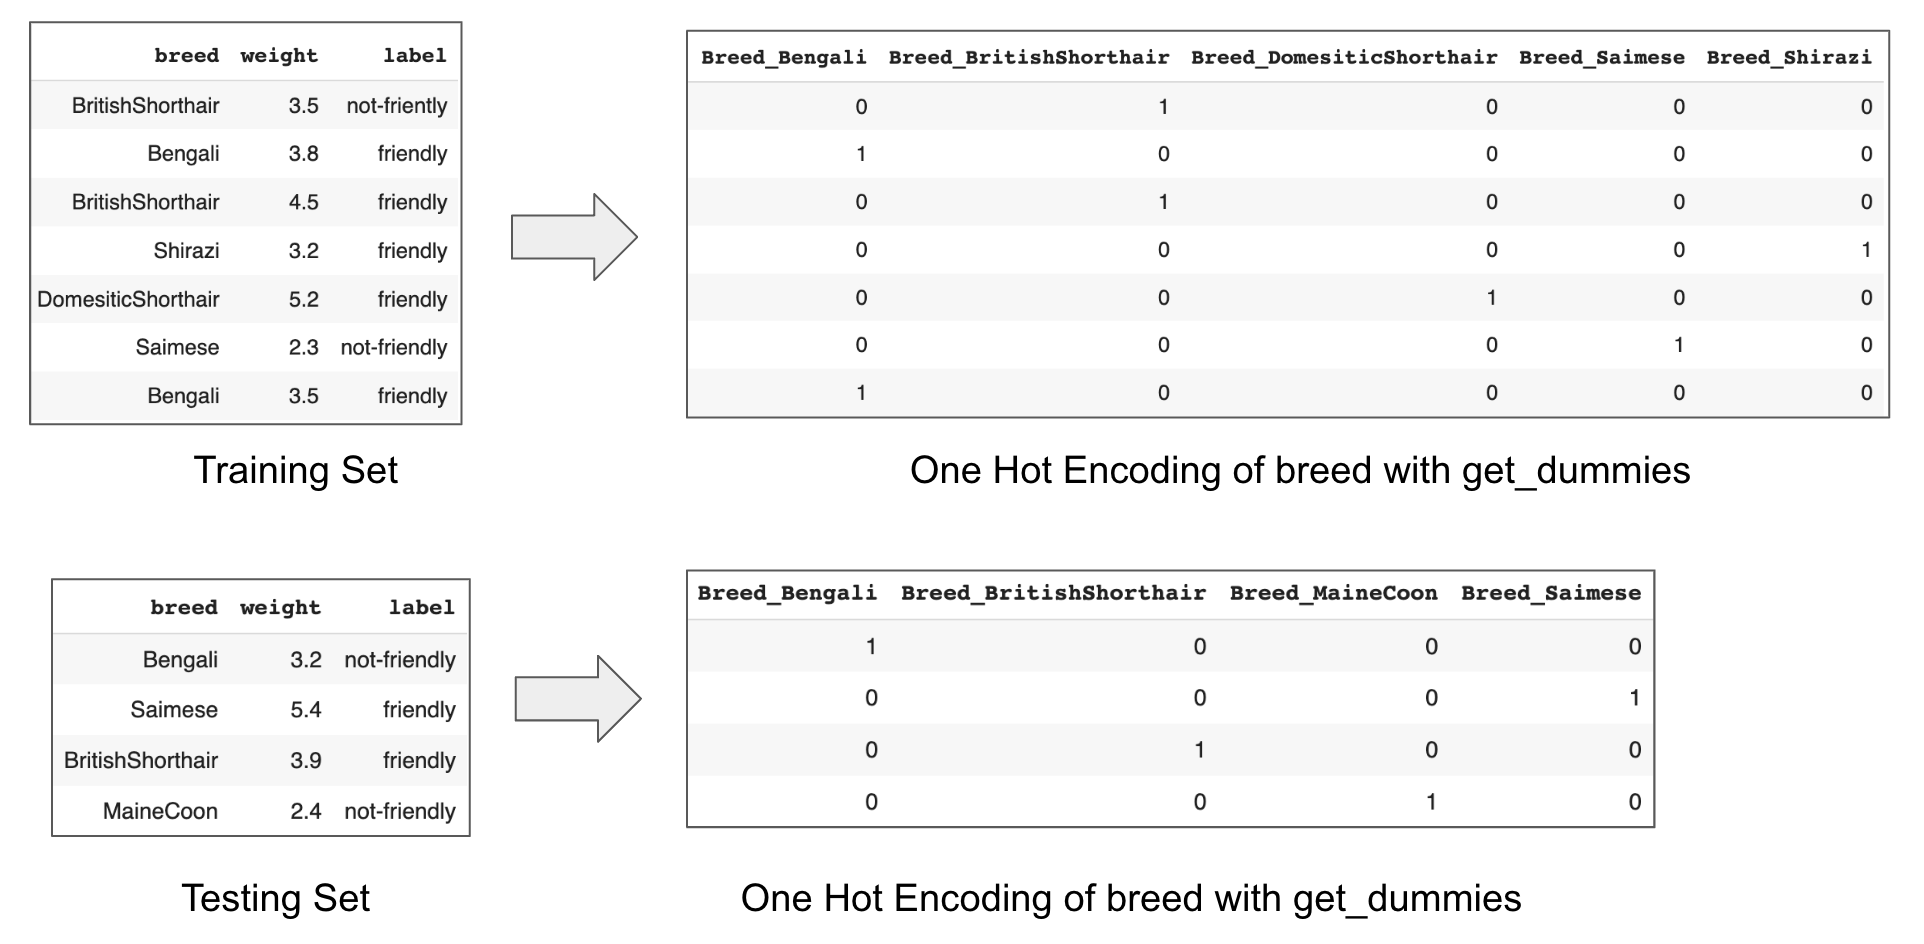
Вы замечаете какие-либо проблемы здесь?
Первое, что бросается в глаза, это разные размеры кодировок. В то время как в обучающем наборе представлены 5 столбцов, в тестовом наборе всего 4 столбца. Наша обученная модель машинного обучения запутается, если мы попытаемся предсказать тестовый набор с другим измерением.
Во-вторых, в тестовом наборе появился новый столбец Breed_MaineCoon. Модели машинного обучения не могут делать прогнозы на тестовых наборах данных с новыми полями.
Что мы можем с этим поделать?
Мы должны «определить» «новые» поля с набором данных для обучения и использовать тот же набор полей с набором для тестирования.
Другими словами, мы «исправляем» модель кодирования с помощью обучающего набора и придерживаемся ее. Мы используем эту фиксированную модель кодирования для кодирования тестовых данных.
Здесь нам на помощь приходит sklearn OneHotEncoder.
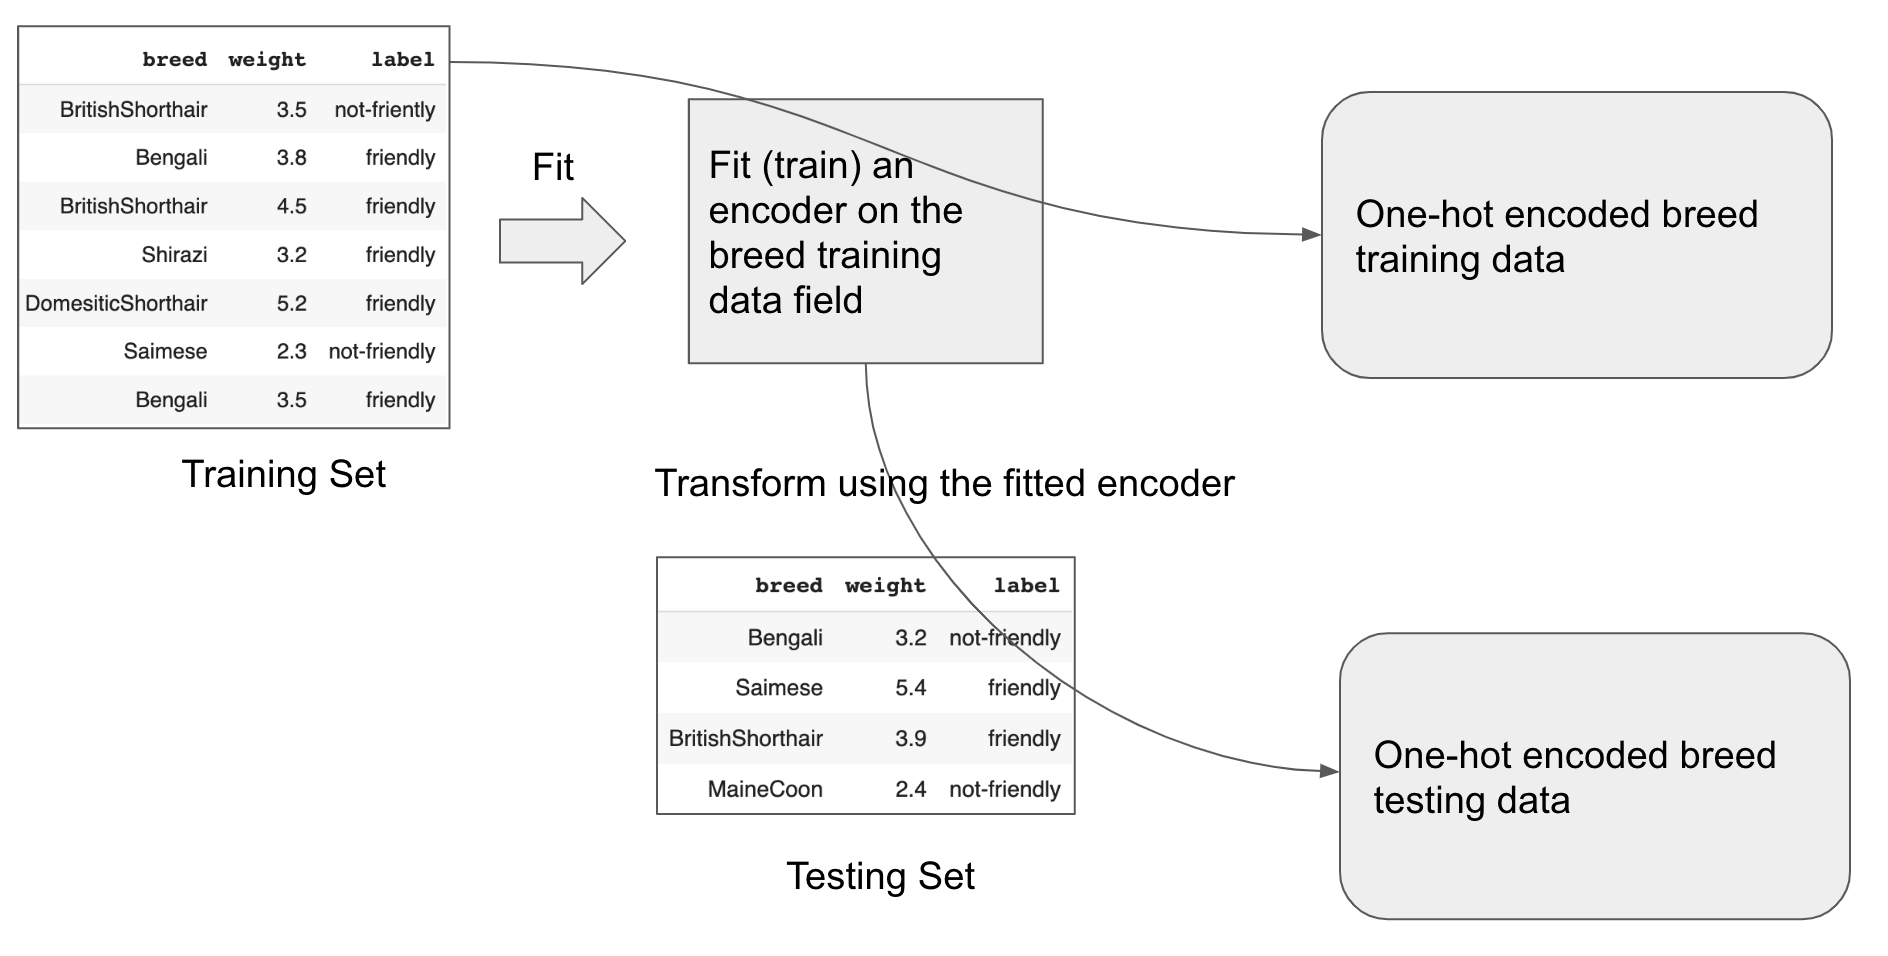
Вот как вы вписываете и трансформируете столбец породы в тренировочном наборе:
import pandas as pd
from sklearn.preprocessing import OneHotEncoder
#fit
ohe = OneHotEncoder(handle_unknown = 'ignore', sparse = False)
ohe.fit(df_train[['breed']])
#transform
df_breed_train = pd.DataFrame(ohe.transform(df_train[['breed']]), columns = list(ohe.get_feature_names()))
Выход:

Теперь мы используем подобранную модель (ohe) для преобразования столбца породы в тестовом наборе данных. Обратите внимание, что мы НЕ используем данные тестирования для подбора модели. Это очень распространенная ошибка, которую допускают даже некоторые специалисты.
df_breed_test = pd.DataFrame(ohe.transform(df_test[['breed']]), columns = list(ohe.get_feature_names()))
Выход:

В машинном обучении нет никакой магии. Модели машинного обучения могут хорошо предсказывать только тестовые данные, которые очень похожи по форме на обучающие данные. (Если данные тестирования сильно отличаются от данных обучения, модель не будет хорошо прогнозировать).
Таким образом, мы сосредоточимся только на категориях, которые мы видели в обучающих данных. Мы сообщаем подогнанному кодировщику «игнорировать» новые категориальные значения, найденные в тестовом наборе. Обратите внимание, что последняя строка в тестовом наборе полностью равна нулю, так как наш кодировщик не распознает категорию MaineCoon.
На практике мы обычно выполняем прогнозы на невидимых данных, и поэтому рекомендуется сохранить кодировщик в файл, чтобы вы могли загрузить тот же кодировщик для преобразования, когда позже захотите сделать прогноз для новой точки данных.
Бонус:
Мы следуем тому же принципу, когда масштабируем/нормализуем данные в наших наборах для обучения и тестирования. Сначала мы подгоняем скейлер/нормализатор к обучающим данным, а затем используем подогнанный скейлер/нормализатор для масштабирования/нормализации тестовых данных.
Вывод:
- Никогда не кодируйте и не масштабируйте весь набор данных при обучении моделей машинного обучения.
- Подберите модель к обучающим данным, а затем используйте модель для преобразования набора тестов.
- Для этого используйте sklearn OneHotEncoder.
Практический совет:
Опыт 1: хотя логично использовать порядковое кодирование для категориальных значений с некоторым порядком (уровни температуры, сорта и т. д.) и одно горячее кодирование для категориальных значений без порядка (например, порода кошки, любимый фрукт и т. д.), я рассматривайте метод кодирования как гиперпараметр, то есть я пробую оба кодирования для категориальных данных и использую тот, который лучше работает с метрикой, на которой я сосредоточен (например, точность или отзыв).
Опыт 2: Кроме того, одно горячее кодирование может быть неправильным решением для некоторых алгоритмов машинного обучения. Например, рекомендуется не использовать одно горячее кодирование при использовании моделей на основе дерева решений, таких как случайный лес.
Опыт 3: Вы должны быть осторожны, чтобы не переусердствовать. Проверьте, не создает ли ваша кодировка значительный разрыв между производительностью поезда и теста. Вы можете попробовать другую кодировку или уменьшить количество категорий в одной горячей кодировке путем группирования.
Опыт 4. Существуют алгоритмы машинного обучения для обработки кодирования (например, LightGBM, CatBoost). Вы также можете попробовать их.
Не стесняйтесь обращаться ко мне, если у вас есть какие-либо вопросы. Я хотел бы услышать ваши отзывы. Это помогает мне писать больше подобных статей.
PS: Вы проверили, что произойдет, если вы нажмете кнопку "Нравится" более одного раза :)
Оставайся голодным!





