
Это вторая часть моего резюме глав, которые я прочитал из книги Погружение в глубокое обучение.
Если вы не читали, это часть 1, в которой резюмируется раздел 3.1 со страниц 82 по начало 86.
Погружение в глубокое обучение — часть 1
В этой серии я поделюсь с вами своим кратким изложением книги «Погружение в глубокое обучение, я начал читать ее… nouranalimohammed.medium.com»
В следующих разделах аналитического решения рассказывается об оптимизации модели и о том, как рассчитать градиенты.
Минипакетный стохастический градиентный спуск
Идея алгоритма градиентного спуска заключается в итеративном уменьшении ошибки путем обновления параметров в направлении, постепенно снижающем функцию потерь.
Затем авторы упоминают две крайности для применения алгоритма GD...
- Наивный подход:
Возьмем производную функции потерь, которая представляет собой среднее значение потерь, рассчитанных для каждого примера в наборе данных, полное обновление мощно, но имеет некоторые недостатки…
Недостатки:
. Может быть очень медленным, так как нам нужно пройти через весь набор данных, чтобы сделать одно обновление.
. Если в обучающих данных много избыточности, польза от полного обновления очень мала. - Экстремальный подход
Рассматривайте только один пример за раз и обновляйте шаги, основываясь на одном наблюдении за раз. Напоминает ли это вам что-то??
Да, это стохастический градиентный спуск алгоритм или SGD.
Он может быть эффективным даже в больших наборах данных, но он также имеет некоторые недостатки…
Недостатки:
. Обработка одной выборки за раз может занять больше времени, чем обработка всей партии
. Некоторые слои NN хорошо работают, когда мы обрабатываем более одного наблюдения за раз (нормализация партии слой).
Если два метода имеют серьезные недостатки, то что нам делать? Все просто, мы просто выбираем золотую середину.
Минипакетный стохастический градиентный спуск
Вместо того, чтобы брать полный набор данных как пакет или брать только одну выборку, мы берем мини-пакет, размер мини-пакета зависит от многих переменных:
- Объем памяти
- количество ускорителей/графических процессоров
- количество слоев
- размер набора данных
Но авторы рекомендуют число от 32 до 256 (кратное большой степени 2).
Шаги алгоритма:
- Произвольная выборка мини-пакета Bi фиксированного числа |B| обучающих выборок и случайным образом инициализировать параметры модели
- Вычислите производную средней потери на мини-партии
- мы умножаем градиент на заданное небольшое положительное значение η, скорость обучения, и вычитаем полученный член из текущих значений параметров.

Затем мы знакомимся с некоторыми важными понятиями:
гиперпараметры: настраиваемые параметры, которые не обновляются в цикле обучения, например размер пакета |B|.
обобщение: найдите параметры, которые приводят к точным прогнозам на основе ранее невиданных данных.
Нормальное распределение и квадрат потери
Нормальное распределение и линейная регрессия с квадратом потерь имеют более глубокую связь, чем общее происхождение.
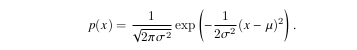
Предположим, что наблюдения возникают в результате шумовых измерений, где шум нормально распределяется следующим образом.
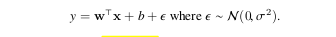
Тогда вероятность получения конкретного y данного x равна
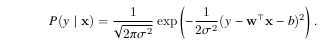
В соответствии с принципом максимального правдоподобия наилучшие значения параметров w и b — это те, которые максимизируют правдоподобие всего
набора данных.
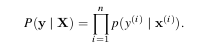
Окончательная формула для минимизации отрицательной вероятности выглядит следующим образом.

Наконец, линейная регрессия считается однослойной нейронной сетью.

И это все, что касается раздела 3.1, он довольно напряженный, но как только вы разбиваете его на более мелкие части, он становится приятным и легким.
Спасибо, что дочитали до конца этой статьи, и до встречи в части 3!





