
Вы можете подумать, что я объясню, как работает логистическая регрессия? ну не совсем. Вы можете получить это на любом случайном канале YouTube или при переполнении стека.
Теперь я здесь, чтобы научить математике этого простого, но красивого алгоритма «логистической регрессии».

мы можем предсказать любую переменную ответа с помощью переменной-предиктора. И переменная ответа может быть либо количественной, либо качественной. т. е.количественный показатель носит числовой характер, а качественный носит категориальный характер.
Пример: некоторые известные породы собак: немецкая овчарка, лабрадор-ретривер, шпиц, бульдог, сибирский хаски, мопс 😍
отличная работа! Вы должны знать некоторые симпатичные породы собак. Что теперь ?
👇
логистическая регрессия подпадает под классификацию. А классификация — это не что иное, как предсказание приведенного выше качественного ответа. Если вы видите, что у нас есть множество точек данных или записей в нашем наборе данных. Таким образом, прогнозирование качественного отклика для этих точек данных называется классификацией этой конкретной точки данных.
приведенный выше рисунок представляет собой точечную диаграмму, представляющую различные точки данных или записи, построенные между x (независимыми) и y (зависимыми) переменными.
если наши переменные ответа (т. е. зависимая переменная) являются качественными, то нам нужно классифицировать точки данных на основе этой категории следующим образом 👇
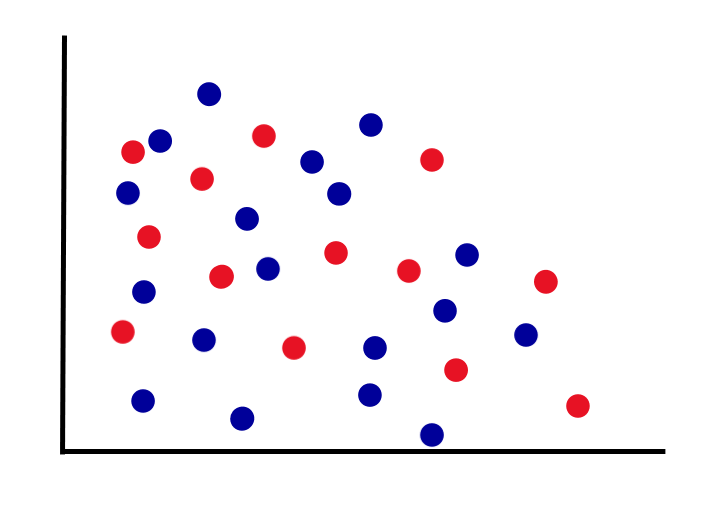
скажем, синие точки — это пользователи Android, а красные точки — пользователи iPhone.
у нас есть много методов, таких как линейный дискриминантный анализ, k-ближайших соседей для классификации, которые используются для прогнозирования качественного ответа, и одним из таких методов является логистическая регрессия
Логистическая регрессия (): принадлежит к семейству дискриминационных классификаторов. Существует две широкие категории алгоритмов логистической регрессии.
а. Бинарная логистическая регрессия, когда зависимая переменная строго бинарна
б. Полиномиальная логистическая регрессия, когда зависимая переменная имеет несколько категорий. Существует два типа полиномиальной логистической регрессии.
- Упорядоченная полиномиальная логистическая регрессия (зависимая переменная имеет упорядоченные значения)
- Номинальная полиномиальная логистическая регрессия (зависимая переменная имеет неупорядоченные категории).
Логистическая регрессия — это метод моделирования качественного ответа. мы пытаемся предсказать категорию ответа на основе независимых переменных. В логистической регрессии он также предсказывает вероятность каждой из категорий качественной переменной с использованием логистической функции в качестве основы для классификации. Таким образом, в этом смысле они также ведут себя как методы регрессии.
Если два уровня ответов приняты как Успех и Неудача, Вероятность (Успех) прогнозируется на основе значений предикторов.
Логистическая функция, также известная как Logit , Классификатор с максимальной энтропией, представляет собой контролируемый метод обучения для классификации. Он устанавливает связь между зависимой переменной класса и независимыми переменными, используя регрессию.
Линейная регрессия подходит в некоторых качественных случаях, а в других качественных случаях не рекомендуется. Позвольте мне объяснить с помощью примера.
Пример: В доме живут разные породы собак. мы хотим предсказать силу укуса собаки на основе ее породы.
- ДОГ
- МАЛЬТИПО
- ПИТБУЛЬ
И если мы используем линейную регрессию для этой проблемы. Мы, вероятно, кодируем эти значения как категориальную переменную, а затем используем метод наименьших квадратов, чтобы соответствовать модели линейной регрессии для прогнозирования ответа.
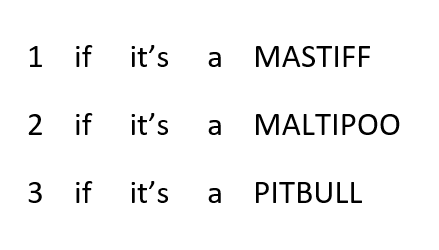
Теперь эта модель линейной регрессии упорядочивает ответы, как показано на рисунке выше. И предполагается, что разница между мастифом и мальтипу такая же, как разница между мальтипу и питбулем.
Но в реальном мире может быть и так 👇
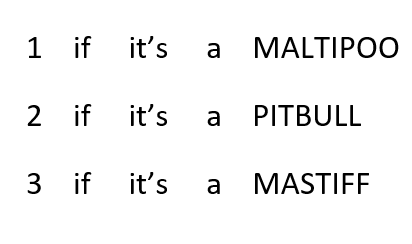
Таким образом, каждый из этих случаев будет давать разные линейные модели, которые в конечном итоге дают разные прогнозы на тестовом наборе.
Предположим, рассмотрим другой пример
Пример: все студенты получили свои результаты, и университет объявил оценки вместо оценок.
- A
- B
- C
Теперь в этом сценарии линейная регрессия имеет полное право считать, что разница между A и B такая же, как разница между оценками B и C. Потому что A имеет более высокий уровень, B - средний уровень, а C - наименьший уровень. Даже если модель меняет порядок, мы можем легко это понять, потому что это естественный порядок. т. е. мы обычно знаем, что оценки будут упорядочены в последовательности A, B, C. Так что здесь нет места путанице.
Но нет естественного способа преобразовать категориальную переменную ответа с более чем двумя уровнями в количественный ответ для линейной регрессии.
Предположим, у нас есть только две категории (PASS, FAIL), то есть двоичные. мы можем подойти к линейной регрессии и перейти к методу фиктивных переменных, чтобы преобразовать наши категориальные переменные в числовые, как это 👇

если наш прогноз > 0,5, мы присваиваем ему значение FAIL.
если наш прогноз ‹ 0,5, мы даем ему как ПРОШЕЛ.
Даже если мы изменим порядок, мы получим те же предсказания.

Следовательно, если уровень превышает 2, то не рекомендуется использовать линейную регрессию, но для двоичного уровня мы можем использовать линейную регрессию для прогнозирования качественных ответов.
Пример: у нас есть 10000 собак в доме, и категории всех этих 10000 собак:
- Угрожающий (т.е. опасный)
- Не угроза (не так опасна)
И наш класс интересов - найти здесь опасных собак.
Итак, нам нужно предсказать собак на основе этих двух категорий. У нас есть «Сила укуса» как независимая переменная.
Если мы используем здесь линейную регрессию, чтобы предсказать категорию собаки на основе признака «Сила укуса»:
Давайте представим
Для Biting Force, близкого к 0, модель линейной регрессии предсказывает отрицательную вероятность.
Для Biting Force, близкого к 1, модель линейной регрессии предсказывает значение больше 1.
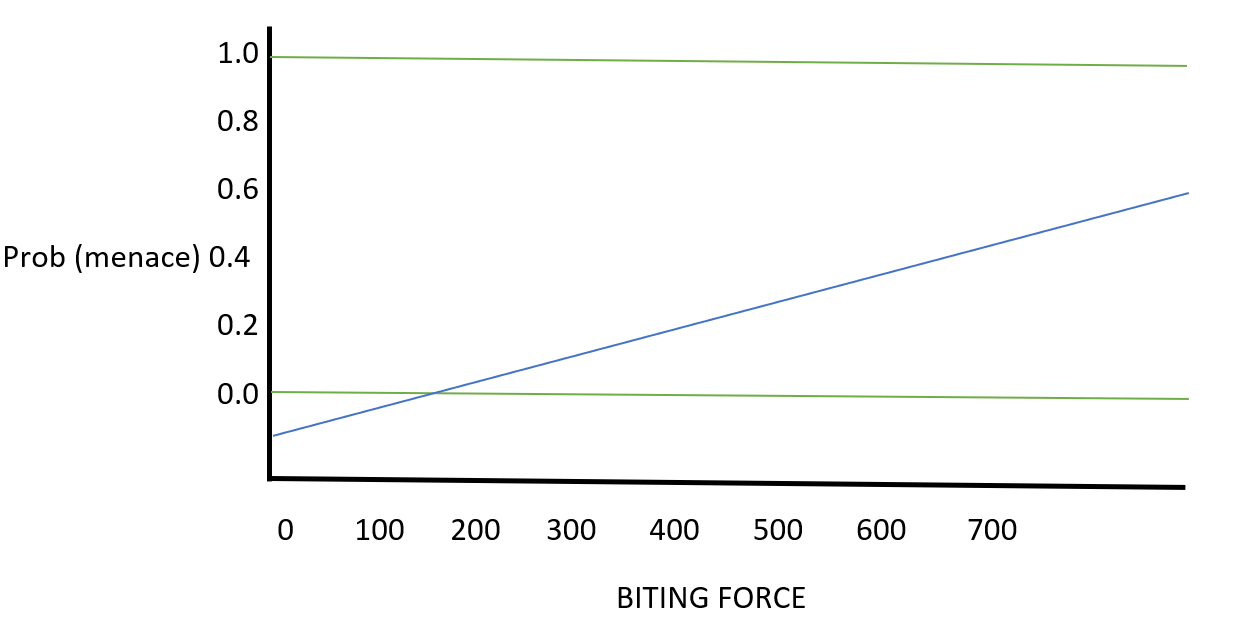
Но обычно вероятность колеблется между 0 и 1. Таким образом, использование линейной регрессии вероятностей не имеет никакого смысла. Это ограничение линейной регрессии. Поэтому, чтобы противостоять этому, мы используем логистическую регрессию.
Теперь мы моделируем наши прогнозы с помощью функции, которая дает значения вероятности в диапазоне от 0 до 1. Здесь, в логистической регрессии, мы используем функцию, называемую «логистическая функция». Эта функция дает s-образнуюкривую для любого значения x
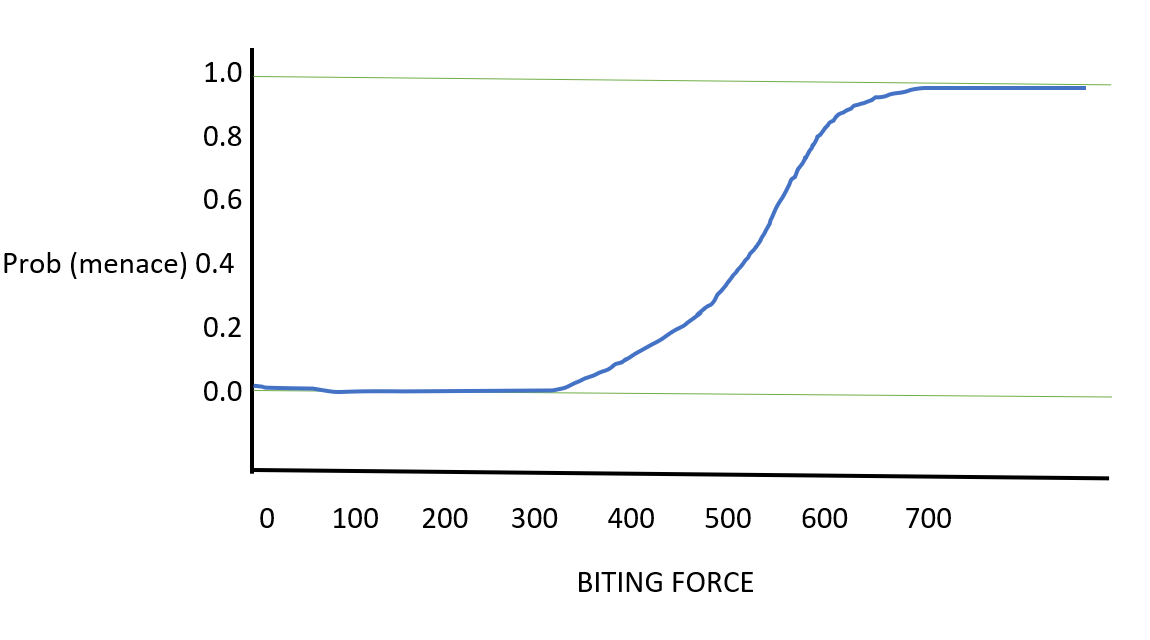
Если мы используем здесь логистическую регрессию, чтобы предсказать категорию собаки на основе признака «Сила укуса»:
Для более низкой силы укуса модель логистической регрессии предсказывает вероятность, близкую к 0, но не ниже 0.
Для более высокой силы укуса модель логистической регрессии предсказывает вероятность, близкую к 1, но не превышающую 1.
Логистическая функция:
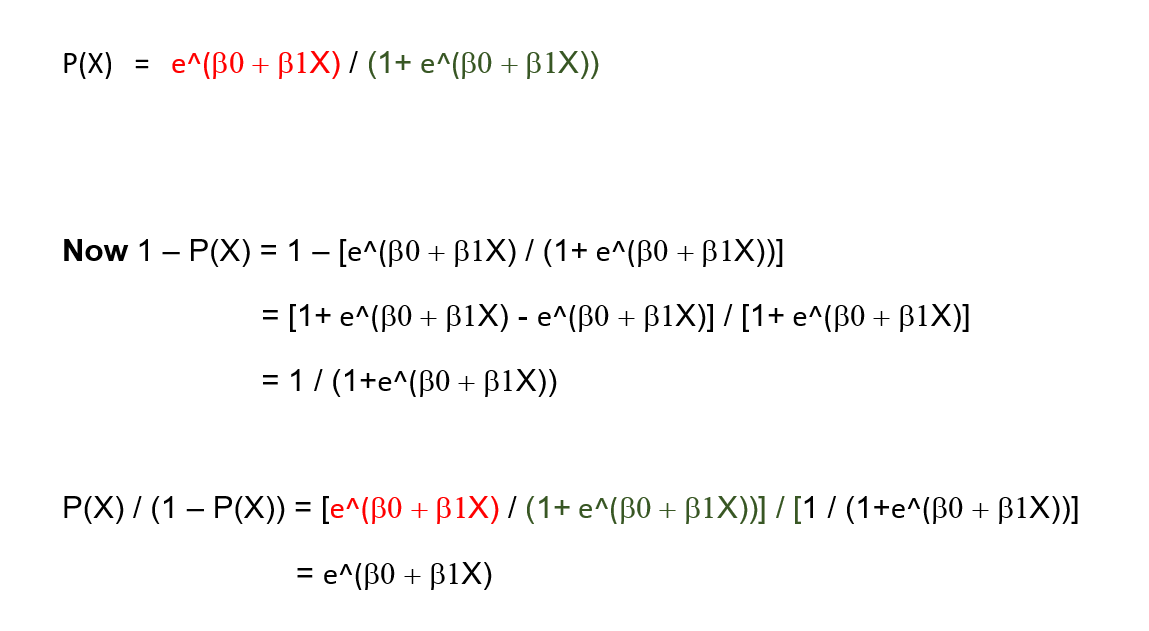
Здесь P(X)/(1 — P(X)) называется коэффициентом с диапазоном (от 0 до ∞)
шансы близки к 👇
0→ очень низкая вероятность
∞→ очень высокая вероятность
после применения логарифмического преобразования с обеих сторон получаем

Приведенное выше уравнение имеет логит, линейный по X.
Лог (P(X) / (1 — P(X))) → log-шансы или logit
В модели линейной регрессии beta1 представляет собой наклон или веса, т. е. дает среднее изменение y при увеличении x на одну единицу.
Но в модели логистической регрессии бета 1 дает среднее изменение логарифмических шансов при увеличении x на одну единицу. Поскольку здесь нет линейной зависимости между P(X) и X 👇
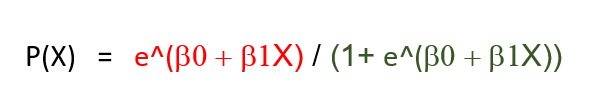
поэтому бета1 здесь не равна изменению P(X) при увеличении x на одну единицу.
Изменение p(X) зависит от текущего значения x.
Но если beta1 равно +ve, то для любого значения x
- если x увеличивается, то P(X) увеличивается
Если beta1 равно -ve, то для любого значения x
- если x увеличивается, то p(X) уменьшается
Оценка коэффициентов:
В линейной регрессии мы использовали метод OLS (обычных наименьших квадратов) для оценки коэффициентов. Но метод максимального правдоподобия намного лучше, чем МНК, благодаря своим статистическим свойствам.
Когда мы попытаемся оценить наши коэффициенты beta0_hat и beta1_hat, подгоняя эти коэффициенты к нашей регрессионной модели, прогнозируемая вероятность угрозы P(X)_hat будет близка к фактической p(X) угрозы.
т. е. для опасных собак p(X) будет близко к 1.
для собак, которые не так опасны, p(x) будет близко к 0
Если это примет математическую форму, то будет 👇
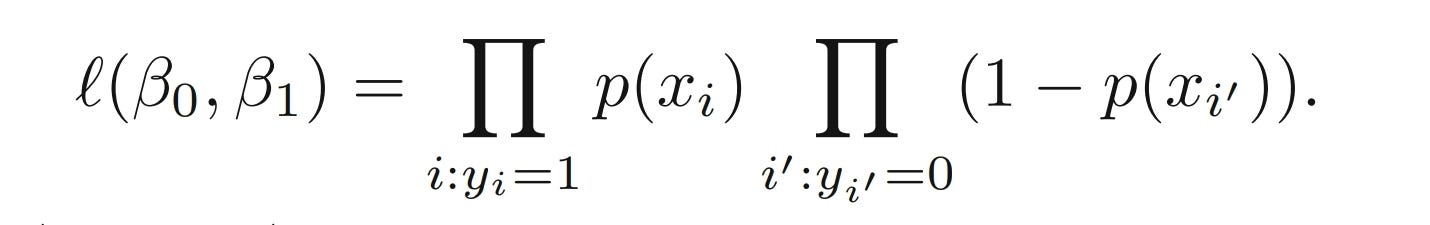
Оценки коэффициентов beta0_hat и beta1_hat используются для максимизациифункции правдоподобия, отсюда и название функция максимального правдоподобия.
Ниже приведен пример данных, в которых у нас есть переменная ответа категории (дефолтеры и недефолтеры), а баланс является одной из переменных-предикторов. И нам интересно прогнозировать неплательщиков.

Здесь,
- Пересечение:beta0_hat = -10,6513,
- Наклон:beta1_hat = 0,0055 (наклон)
Как сказано выше, это означает, что увеличение баланса на одну единицу повысит вероятность (по умолчанию). То есть увеличение баланса на одну единицу увеличит шансы журнала (по умолчанию) на 0,0055 единицы.
- z-статистика здесь аналогична t-статистике в линейной регрессии. на приведенном выше рисунке его значение очень велико, что указывает на то, что оно далеко от 0. Таким образом, оценка коэффициента beta1_hat велика и достаточно точна, чтобы отличаться от 0.
Если его значение близко к 0, это указывает на то, что beta1_hat слишком мала или неточное утверждение о том, что эта переменная влияет на отклик.
Таким образом, на приведенном выше рисунке z-статистика очень велика, а значение p (0,0001) меньше 0,05. Мы можем легко отвергнуть нулевую гипотезу, говоря, что баланс и вероятность (по умолчанию) имеют какую-то связь.
Перехват — это не что иное, как если x (т. Е. Баланс) равен 0, то перехват — это среднее среднее значение Y (ответ).
Если x не равен 0, то перехват не имеет смысла.
В реальном мире мы можем найти оба этих сценария. Но причина, по которой мы строим регрессионные модели, заключается в том, чтобы понять взаимосвязь между предикторами и откликами. Так что здесь перехват не имеет ничего общего с пониманием взаимосвязи между переменными. Вам нужен перехват для расчета прогнозируемых значений.
Если x не равен 0, но вы все же хотите осмысленный перехват, рассмотрите возможность центрирования x. Если вы измените масштаб x так, чтобы среднее значение или какое-либо другое значимое значение было равно 0 (просто вычтите константу из x), теперь перехват имеет смысл.
перехват — неотъемлемая часть нашей модели, он сдвигает лог коэффициентов к их фактическому значению, если ни одна переменная не может этого сделать. если вы удалите перехват из модели, то модель будет смещена.
Прогнозы:
Теперь мы можем предсказать вероятность
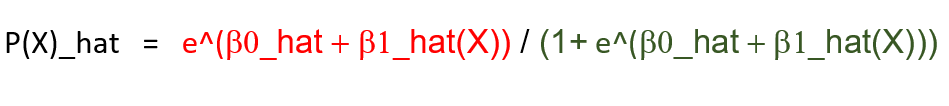
подставляя значения beta0_hat , beta1_hat в приведенное выше уравнение, мы можем получить вероятности.
Также мы можем использовать качественные независимые переменные в логистической регрессии, используя метод фиктивной переменной. Он просто принимает значение 1 для интересующего нас класса и 0 для другого класса. т. е. если у вас есть категория независимой переменной (студент, нестудент), то 1 для студента, 0 для нестудента.
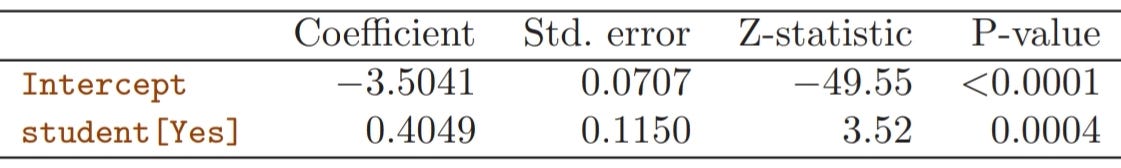
здесь коэффициент для категории «студент = да» равен 0,4049 (т. е. положительный) и p = 0,0004, что намного меньше значения значимости (0,05) и z-statistic = 3,52, что показывает расстояние от 0.
Все эти значения указывают на то, что учащиеся имеют более высокую вероятность невыполнения обязательств, чем неучащиеся. Если вы хотите вычислить вероятность для студентов = да и для студентов = нет, вы можете заменить все приведенные выше значения в таблице в приведенной выше формуле, тогда вы получите значения
Вероятность (по умолчанию = Да | Студент = Да) = 0,0431
Вероятность (по умолчанию = да | Студент = нет) = 0,0292
Множественная логистическая регрессия:
Что, если у нас есть несколько качественных переменных-предикторов, и мы хотим с их помощью предсказать бинарный отклик?
мы можем расширить эту формулу 👇
as 👇

и мы можем продлить это 👇
as 👇

Мы можем использовать метод максимального правдоподобия для оценки нескольких коэффициентов.
Сейчас я объясню одну самую важную вещь.
Предположим, вам нужно предсказать качественный ответ (по умолчанию = Да) с помощью различных переменных-предикторов (студент, баланс). Представьте, что студент и баланс связаны друг с другом. т. е. (мультиколлинеарность).
И когда вы предсказываете Y только со студентом = Да, игнорируя другую переменную предиктора (баланс), которая коррелирует со студентом. Тогда будут результаты 👇
здесь мы получили коэффициент для предиктора студента 0,4049 (т.е. положительный)
И когда вы прогнозируете Y со всеми предикторными переменными студента, баланс которых коррелирует друг с другом. Тогда будут результаты 👇
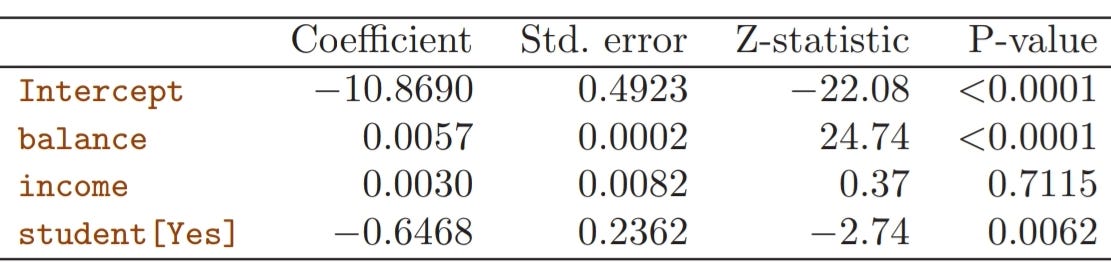
Здесь коэффициент для предиктора «студент» равен -0,6468 (т. е. отрицательный)
Смотрите здесь ниже 👇
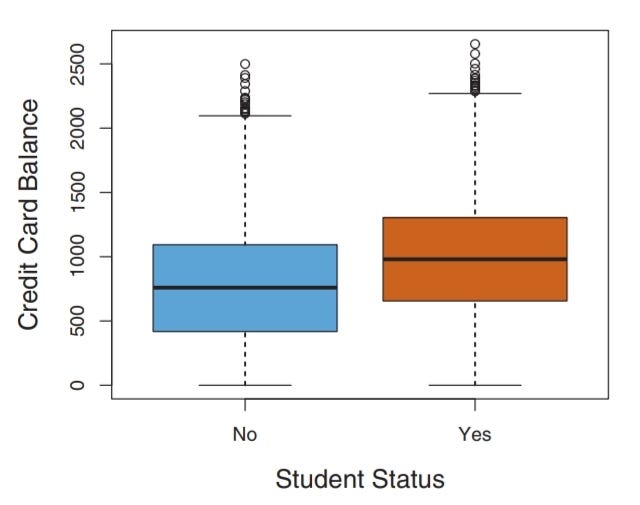
Он ясно показывает, что независимые переменные «студенты» и «баланс» коррелируют друг с другом.
А теперь смотрите здесь 👇

Оранжевая кривая — студент = Да
Синяя кривая - студент = Нет
И когда мы строим график, он показывает, что уровень по умолчанию для не-студентов выше, чем уровень по умолчанию для студентов. Но оранжевая прерывистая линия ниже указывает на то, что общие показатели по умолчанию для студентов высоки по сравнению с синей прерывистой линией, которая представляет собой общий уровень по умолчанию для неучащихся.
т. е. даже несмотря на то, что отдельный студент с балансом кредитной карты, как правило, имеет более низкую вероятность дефолта, чем не студент с таким же балансом. Но в целом студенты, как правило, чаще не учатся, чем неучащиеся.
То есть, если мы не учитываем баланс кредитной карты студента, а выдаем ему кредит, студент более рискован, чем не студент. Но если у студента и не студента одинаковый баланс кредитной карты, то не студент более рискован, чем студент.
Оценка моделей логистической регрессии:
- Когда вы создаете матрицу путаницы. Всегда передавайте (y, y_hat) или наоборот в функцию матрицы путаницы. то есть путаница (y, y_hat) или путаница (y_hat, y). Но всегда выбирайте один в каждой модели и помните об этом. Потому что, если вы постоянно меняете это от модели к модели, вы можете запутаться.
Наш класс интереса должен быть "ненормальным". Исходя из этого, мы примем это решение
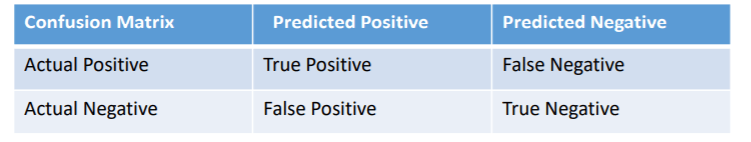
- Истинно положительный : где наши фактические и прогнозируемые данные говорят о том, что данные принадлежат нашему классу.
- Истинно отрицательный: где наш фактический и прогнозируемый говорят, что данные не принадлежат к нашему классу.
- И TP, и TN являются правильными классификаторами.
- Ложное срабатывание:точка данных изначально принадлежала другому классу. Но наша модель предсказывает эту точку данных, поскольку она принадлежит к нашему интересующему классу.
- False Negative: точка данных изначально принадлежала нашему классу. Но наша модель предсказывает эту точку данных, поскольку она принадлежит к другому интересующему классу.
- И FP, и FN являются неверными классификациями.
2. Точность. Насколько точно или четко модель классифицирует точки данных. Чем меньше ложных прогнозов, тем лучше будет точность.

Но оценки точности ненадежны, потому что наш интересующий класс недостаточно представлен. т. е. наша цель — предсказать ненормальное поведение. Но обычно для ненормальных случаев записи будут менее доступны по сравнению с обычными случаями.
т. е. неплательщики (нормальные) → 90
неплательщики (ненормальные) → 10
например, если мы предскажем, что все точки данных не являются дефолтерами, то все же мы получим исходную точность 90% недефолтеров. Следовательно, точность не является надежной.
3. Специфика. Как фактические отрицательные данные определяются нашей моделью как отрицательные.

4. Чувствительность/отзывность:сколько из фактических истинных точек данных определяется нашей моделью как истинные точки данных.
(с точки зрения непрофессионала, вспомнить не во всех случаях, неплательщики, которые у нас есть в нашей обучающей выборке. Сколько из них были идентифицированы нашей моделью как неплательщики)

5. Точность.Среди точек, определенных нашей моделью как положительные, какие могут быть действительно положительными.

Полнота и точность называются метриками уровня класса. Они представляют правильность модели в конкретном классе, и когда мы используем метрики sklearn, эти отзыв и точность связаны с нашим интересующим классом (т. Е. Недостаточно представлены)
Даже если мы не укажем и не напечатаем полноту и точность, будут полнота и точность класса, который является меньшим классом. Мы также можем найти полноту и точность других классов, но по умолчанию нас интересует класс 1. 0 - другой класс.
Отзыв и точность противостоят друг другу. Если отзыв увеличится, то возрастет и точность. Если отзыв уменьшился, то точность увеличилась.
Чтобы улучшить как отзыв, так и точность, нам нужно выбрать лучшие функции. Это относится ко всем алгоритмам и моделям.

Выше некоторые синие точки находятся в зоне не по умолчанию, некоторые красные точки находятся в зоне по умолчанию. Пороговое значение = 0,5 (мы не можем это изменить)
Если мы сдвинем порог влево, чтобы захватить максимум синих точек, то 👇
FN будет уменьшен, а отзыв увеличится
но
тогда красные точки, которые обычно принадлежат зоне недефолтера, попадут в зону дефолта. (т. е. в точности увеличивается FP), то наша точность уменьшается.
Где мы должны держать порог, чтобы получить оптимальный отзыв, а оптимальная точность будет нашим бизнес-требованием.
Если речь идет о здравоохранении, где жизнь и смерть имеют большое значение, то отзыв будет для нас очень важен.
Если это ритейл (недвижимость), то для нас будет очень важна точность. Если мы идентифицируем ненарушителя как нарушителя. Это приведет к тому, что клиент уйдет на новую сторону.
По умолчанию порог будет равен 0,5.
Если вы хотите изменить пороговое значение, мы используем «метод рэпера» или «класс рэпера».
Мы в основном делаем это пороговое изменение вне нашего построения модели.
Предположения логистической регрессии:
- Зависимая переменная является категориальной. Дихотомический для бинарной логистической регрессии и мультиметка для многоклассовой классификации.
- Атрибуты и логарифмические шансы, т.е. log(p(X)/1-p(X)) должны быть линейно связаны с независимыми переменными.
- Атрибуты не зависят друг от друга (низкая или отсутствующая мультиколлинеарность).
- В бинарной логистической регрессии интересующий класс кодируется цифрой 1, а другой класс — 0–5. по алгоритму)
- Примечание. предположения линейной регрессии, такие как гомоскедастичность, нормальное распределение ошибок, линейная связь между зависимыми и независимыми переменными, здесь не требуются. OVR — это совокупность различных моделей для создания единой модели логистической регрессии.
Приложения:
- . Прогнозирование погоды: у вас может быть только несколько определенных типов погоды. Штормовая, солнечная, облачная, дождливая и еще несколько.
- Медицинский диагноз: по симптомам можно предсказать заболевание, которым страдает пациент.
- . Если ссуда должна быть предоставлена конкретному кандидату, это зависит от его проверки личности, сводки счета, любой собственности, которой он владеет, любой предыдущей ссуды и т. д.
Плюсы:
- Простота реализации и интерпретация выходных коэффициентов.
- Предоставляет как вероятности, так и классы в качестве выходных данных.
- Быстро обучается, так как функция ошибок (перекрестная энтропия) выпуклая, гладкая и непрерывная.
Минусы:
- Предполагается линейная связь между логарифмическими шансами и независимыми переменными.
- Может прекратить обучение (схождение весов) при наличии хороших разделителей классов в качестве атрибутов. Такие атрибуты будут иметь очень большой вес. Это потребует соответствующей регуляризации, чтобы заставить модель учиться и обобщать. (т. е. если какая-либо независимая переменная может разделить или классифицировать 2 класса без какого-либо перекрытия, тогда наш алгоритм логистической регрессии прекратит обучение, он будет использовать этот единственный атрибут. Но это теоретический недостаток, в реальном мире, мы никогда не столкнемся с такими атрибутами. Если они встречаются в реальном мире, то кому нужно строить модель ?
- Выбросы могут иметь огромное неблагоприятное влияние на логарифмическую регрессию шансов. 4. Предполагается, что атрибуты независимы, что обычно не так.
Некоторые важные моменты, которые следует помнить:
- Логистическая регрессия присваивает вероятности различным классам, к которым может принадлежать точка запроса.
- он учится на тренировочном наборе векторов весов и смещения. Каждый вес (Wi ) назначается одному входному признаку Xi.
- вес, присвоенный каждому признаку, показывает, насколько этот признак важен для принятия решения о классификации.
Представим, что по переменной X1 распределение двух классов (0 и 1) хорошо разделено.

по переменной X2 распределение двух классов (0 и 1) не так хорошо разделено.

Таким образом, переменная X1 имеет больший вес, чем переменная X2.
4. Веса могут быть положительными, т. е. иметь прямую корреляцию объекта с интересующим классом**, в то время как отрицательный вес указывает на обратную связь с интересующим классом.
Веса могут быть в диапазоне от -∞ до +∞.
Когда мы умножаем эти веса (Wi*Xi) на соответствующие входные переменные, получается любое число +ve или -ve.
5. Эти результаты суммируются, как в линейной регрессии.
(Z = w.x + b)
приведенное выше уравнение похоже на 👇
Y = m1X1 + m2X2 + C
т. е. внутри логистическая регрессия использует линейную модель для прогнозирования вероятностей того, что точка данных принадлежит определенному классу.
обычно вероятность колеблется от 0 до 1. Но в этом Z = w.x + b, результаты этого уравнения будут в диапазоне от -∞ до +∞.
Теперь, как мы можем назвать это вероятностью?
Линейная модель не может дать вам вероятности. Он дает необработанные цифры. Эти необработанные числа преобразуются в значения вероятности с помощью функции «сигмоид». Математически это

это «е» является числом Эйлера. Это «е» преобразует эту прямую линию в s-образную кривую. Затем эта s-образная кривая становится 0 при -∞ и становится 1 при +∞ вот так 👇
Именно это и является свойством функции вероятности.
мы уже обсуждали два вышеупомянутых сюжета и интуицию, стоящую за ними.
Линия наилучшего соответствия — это та, которая дает нам наилучшую S-образную кривую, что уменьшает ошибки неправильной классификации.
Чтобы свести к минимуму ошибки неправильной классификации, алгоритм использует функцию логарифмических потерь или кросс-энтропийных потерь (отрицательное логарифмическое правдоподобие) для нахождения наиболее оптимальных весов и смещений по всему набору данных (N записей).





