
Интуитивно понятный обзор того, как модель может распознать то, чего она не видела.
Введение - что такое безупречное обучение?
Обучение с нулевым выстрелом позволяет модели распознавать то, чего она не видела раньше.
Представьте, что вам нужно разработать новейшую и лучшую модель машинного обучения, которая может классифицировать всех животных. Да, все животные.
Используя свои знания в области машинного обучения, вы сразу понимаете, что нам нужен маркированный набор данных с хотя бы одним примером для каждого отдельного животного. В мире насчитывается 1899 587 описанных видов, поэтому вам понадобится набор данных примерно с 2 миллионами различных классов.
Ой.

Как вы, наверное, уже заметили, получить большие объемы высококачественных данных с пометками сложно. Очень тяжело.
Это не поможет, когда вашей модели предстоит изучить миллионы различных классов (например, видов животных).
Так как же решить эту проблему?
Один из способов - уменьшить зависимость наших моделей от данных с ярлыками. Это мотивация беспроигрышного обучения, при котором ваша модель учится классифицировать классы, которых она раньше не видела.
В примере классификации видов животных ваша модель может предсказать, что изображение в правом нижнем углу - это «Панда», даже если она не видела явно помеченный пример «Панды» во время обучения.
Сумасшедший, да ?!
В следующем разделе мы узнаем, как работает этот, казалось бы, волшебный метод, на некоторых примерах моделей, в которых используется установка нулевого выстрела.
Как работает обучение без выстрела?
Хотя в литературе существует несколько подходов к обучению с нулевым выстрелом, в этой статье основное внимание уделяется недавнему методу под названием Contrastive Language-Image Pretraining (CLIP), предложенному OpenAI, который хорошо зарекомендовал себя в настройке с нулевым выстрелом [2].
Цель CLIP - научиться классифицировать изображения без явных ярлыков.
Интуиция
Как и традиционные модели с учителем, CLIP состоит из двух этапов: этап обучения (обучение) и этап вывода (прогнозирование).
На этапе обучения CLIP изучает изображения путем «чтения» вспомогательного текста (т. Е. Предложений), соответствующего каждому изображению, как в примере ниже.
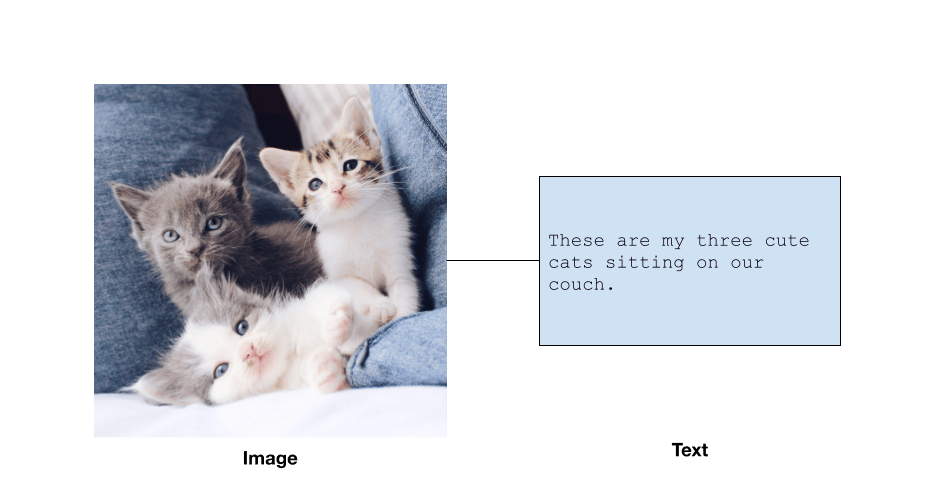
Как человек (при условии, что вы никогда раньше не видели кошек), вы можете прочитать этот текст и, вероятно, расшифровать, что три вещи на изображении - это «кошки». Если вы видели достаточно фотографий кошек с подписями со словом «кошка», скорее всего, вы действительно хорошо научитесь определять, есть ли на снимке кошки.
Точно так же, наблюдая 400 миллионов пар изображение-текст различных объектов, модель может понять, как определенные фразы и слова соответствуют определенным образцам в изображениях. Получив это понимание, модель может использовать эти накопленные знания для экстраполяции на другие задачи классификации.
Но подождите секунду.
Вы можете спросить, разве этот «вспомогательный текст» технически не является разновидностью ярлыка, что делает этот процесс не обучением без ярлыков, которое я обещал вначале?
Хотя вспомогательная информация (например, подписи) является формой наблюдения, она не метки! Благодаря этой вспомогательной информации мы можем использовать богатый информацией неструктурированные данные вместо того, чтобы самостоятельно анализировать неструктурированные данные, чтобы вручную создать одну метку (например, «это мои три симпатичных котика…» → «коты»).
Разработка этикетки требует времени и сокращает потенциально полезную информацию. Используя методологию CLIP, мы можем обойти это узкое место и максимально увеличить объем информации, к которой модель имеет доступ.
Погружение глубже - тренировка нулевого выстрела
Насколько точно модель может извлекать уроки из этих вспомогательных текстов?
Как следует из названия архитектуры, CLIP использует технику, называемую контрастивным обучением, чтобы понять взаимосвязь между парами изображений и текста. Если вы не знакомы с контрастным обучением, я предлагаю ознакомиться с этой статьей о контрастном обучении, прежде чем продолжить.

По сути, CLIP стремится минимизировать разницу между кодировками изображения и соответствующего текста. Другими словами, модель должна научиться делать кодировки изображений и кодировки соответствующего текста как можно более похожими.
Давайте еще немного разберем эту идею.
Что такое кодировки? Кодировки - это просто низкоразмерные представления данных (зеленые и фиолетовые поля на рисунке выше). В идеале кодировки изображения или текста должны представлять наиболее важную, различимую информацию об этом изображении или тексте соответственно.
Например, все изображения кошек должны иметь похожие кодировки, поскольку все они содержат кошек, при этом они должны быть отличными от кодировок собак.
Обратите внимание, что в этом идеальном мире, где кодировки похожих объектов также похожи, а кодировки разных объектов также различаются, становится очень легко классифицировать изображения. Если мы загрузим изображение в модель и кодировка похожа на некоторые другие «кошачьи» кодировки, которые видела модель, она может сказать, что это «кошка»!
Похоже, что ключ к хорошей классификации изображений - это изучение идеальных кодировок изображений. На самом деле это вся предпосылка CLIP (и большая часть глубокого обучения)! Мы начинаем с ужасных кодировок (т. Е. Случайных кодировок для изображения), и мы хотим, чтобы модель изучила идеальные кодировки (т.е. изображения кошек имеют похожие кодировки).
Для большей интуиции, лежащей в основе этой идеи изучения представлений данных, я рекомендую следующую статью:
Понимание скрытого пространства в машинном обучении
Изучите фундаментальную, но часто« скрытую концепцию глубокого обучения на сайтеdatascience.com»
Почему кодировка изображения должна быть как можно более похожей на соответствующую кодировку текста? Теперь, когда мы знаем, что такое кодировка и почему важно изучать хорошие кодировки, мы можем понять, почему мы заставляем модель делать кодировки изображений и текста похожими.
Напомним, что наша конечная цель - научиться классифицировать изображения, и поэтому нам необходимо научиться хорошо представлять изображения (кодировки). Когда у нас были метки, мы могли изучать хорошие кодировки, минимизируя разницу между выходными данными модели и ожидаемыми выходными данными (метками).
Однако в случае с CLIP у нас нет единого вывода модели, и у нас нет единого ожидаемого вывода. Вместо этого мы можем рассматривать кодировки обучающих изображений как выходные данные модели, а текстовые кодировки соответствующих заголовков - как ожидаемые выходные данные.
Фактически, мы можем представить, что модель учится создавать для нас хорошие ярлыки. Поскольку кодировщик текста также обновляется в процессе, со временем модель узнает, как извлекать более важную информацию из текста, тем самым давая нам лучшую кодировку текста (ожидаемый результат).
Имея это в виду, имеет смысл попытаться минимизировать разницу между кодировками изображения и текста. Это потому, что мы знаем, что похожие изображения, вероятно, будут иметь похожие кодировки текста, точно так же, как в помеченная настройка, где похожие изображения будут иметь одинаковые метки. В результате модель научится генерировать похожие кодировки для похожих изображений.
Погружение глубже - вывод нулевого выстрела
Как только модель обучена на достаточном количестве пар изображение-текст, ее можно использовать для вывода (используйте модель для прогнозирования невидимых данных). Вот где настройка становится действительно умной.
На этапе вывода мы настраиваем типичную задачу классификации, сначала получая список всех возможных меток. Поэтому, если бы мы предсказывали виды животных, нам понадобился бы список всех видов животных (например, пингвинов, панд, колючих болванов и т. Д.) (Шаг 2 на рисунке).
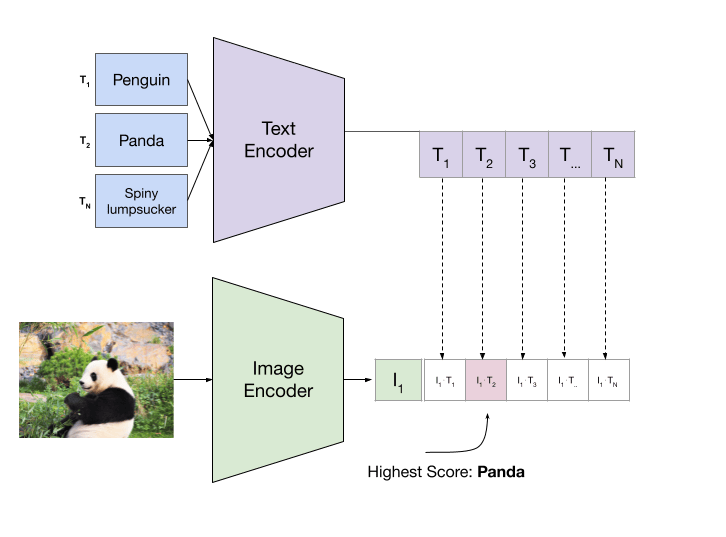
Затем каждая метка будет закодирована предварительно обученным текстовым кодировщиком из шага 1.
Теперь, когда у нас есть кодировки меток, от T₁ до Tₙ, мы можем взять изображение, которое хотим классифицировать, пропустить его через предварительно обученный кодировщик изображений и вычислить, насколько похожа кодировка изображения на каждая кодировка текстовой метки с использованием метрики расстояния, называемой косинусное сходство.
Теперь мы классифицируем изображение как метку с наибольшим сходством с изображением. Мы можем это сделать, поскольку знаем, что модель научилась генерировать кодировки для изображений, которые максимально похожи на ее текстовый аналог, большинство из которых, вероятно, содержат метку, которую мы пытаемся классифицировать.
И вуаля! Мы достигли возможности нулевого выстрела! ²
Интересно, что CLIP - относительно новый метод, который имеет уникальный уровень простоты по сравнению с более традиционными подходами к обучению с нулевым выстрелом. Некоторые из этих концепций, включая подход на основе встраивания и генеративный подход, интуитивно объясняются в статье ниже.
Независимо от того, какой подход используется, общая тема обучения с нулевым выстрелом заключается в том, что мы можем использовать некоторую вспомогательную информацию (например, текстовые описания), которые не являются явными ярлыками, как слабую форму надзора.
Возможные применения Zero-Shot Learning
В общем, обучение с нулевым выстрелом наиболее полезно в сценариях, где необходимы большие аннотированные наборы данных, но их нелегко получить.
Ниже мы исследуем некоторые потенциальные реальные приложения, указанные в [3].
Рентгенография грудной клетки COVID-19
Рентгенологическая диагностика COVID-19 - прекрасный (и актуальный, если вы читаете это в 2021 году) пример того, как обучение с нулевым выстрелом может быть применено в медицински значимых и малоэффективных условиях.
Поскольку на начальных этапах пандемии было мало рентгеновских снимков грудной клетки, положительных на COVID-19, было трудно создать высокопроизводительную модель, которая могла бы отличить COVID от не-COVID или COVID от более распространенного респираторного заболевания, такого как пневмония.
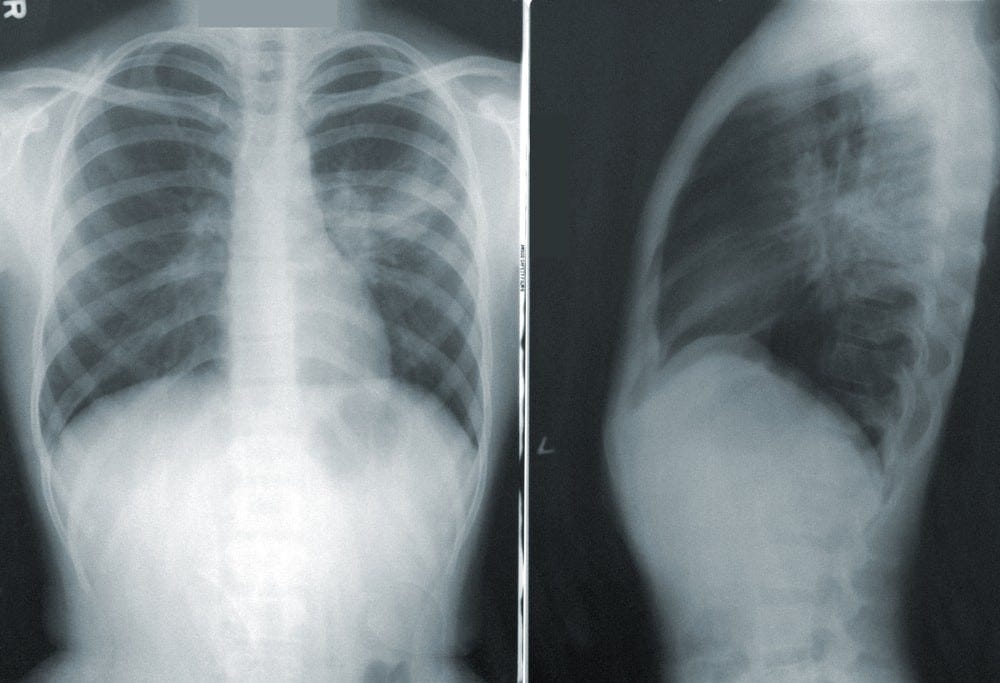
Чтобы решить эту проблему с несколькими ярлыками, нам нужна модель, которая может узнать о COVID-19, имея только изображения других заболеваний и некоторую вспомогательную информацию о рентгеновских снимках грудной клетки COVID-19 - без явных ярлыков COVID.
В этом случае мы можем использовать текстовые описания рентгеновских снимков грудной клетки COVID-19 в качестве вспомогательной информации. Пример приведен ниже.
Видны двусторонние мультифокальные пятнистые GGO и консолидация. - [3]
Насколько мне известно, пока нет официально опубликованных работ, демонстрирующих применение нулевого выстрела к классификации COVID. Однако наличие вспомогательной текстовой информации подчеркивает потенциал беспроблемного обучения, применимого к такой важной с медицинской точки зрения задаче.
Автономные автомобили
Еще один важный пример ИИ, который почти наверняка увидит то, чего раньше не видел, - это система восприятия автономного транспортного средства.
Фактически, даже люди видят на дороге новые объекты, на которые они не знают, как реагировать. Если мы хотим создавать безопасные и прочные автомобили с автоматическим управлением, мы должны дать им возможность адаптироваться к невидимым обстоятельствам.
Опять же, насколько мне известно, существует несколько работ, в которых подходы с нулевым выстрелом применялись к системам восприятия самоуправления. Однако некоторые интересные идеи включают использование текстовых описаний концепт-каров³, чтобы научить модель отличаться от обычных автомобилей [3], и перенос политик, изученных в моделировании, в город без промедления [1].
Ключевые выводы
- Обучение с нулевым выстрелом - это установка, при которой модель может научиться распознавать вещи, которые она раньше не видела во время обучения.
- Существуют разные подходы к нулевому обучению, но общим является то, что вспомогательная информация, такая как текстовые описания, используется или кодируется в процессе обучения вместо явных меток.
- Существует несколько потенциальных применений нулевого обучения в реальном мире - от диагностики заболевания COVID-19 до беспилотных автомобилей.
Работы, описанные в этой статье, - это только верхушка айсберга! По мере развития области мы неуклонно работаем над ИИ, который многие из нас представляют: тот, который не ограничен строго структурой помеченных данных, тот, который может понимать вещи, которых он раньше не видел, и тот, который более человечен.
использованная литература
Примечания
- Да, колючий паук - актуальная вещь. См. Https://www.treehugger.com/animals-with-completely-ridiculous-names-4864307
- Это упрощенное объяснение CLIP. Предлагаю взглянуть на бумагу от OpenAI.
- Согласно Википедии, концепт-кар - это автомобиль, созданный для демонстрации нового стиля и / или новых технологий. Другими словами, они выглядят достаточно дурацкими, чтобы отличить их от обычных автомобилей.





