
Amazon Forecast — это полностью управляемый сервис, использующий машинное обучение для предоставления высокоточных прогнозов.
Amazon Forecast использует машинное обучение для объединения данных временных рядов с дополнительными переменными для построения прогнозов. Amazon Forecast не требует опыта машинного обучения для начала работы. Вам нужно предоставить только исторические данные, а также любые дополнительные данные, которые, по вашему мнению, могут повлиять на ваши прогнозы. Например, спрос на рубашку определенного цвета может меняться в зависимости от сезона и местоположения магазина. Эту сложную взаимосвязь трудно определить самостоятельно, но машинное обучение идеально подходит для ее распознавания. После того как вы предоставите свои данные, Amazon Forecast автоматически проверит их, определит, что является значимым, и создаст модель прогнозирования, способную делать прогнозы, которые на 50 % точнее, чем просто анализ временных рядов.
Для начала необходимо создать группу наборов данных, в группу наборов данных можно добавить до трех наборов данных в формате файла CSV.
Amazon Forecast использует домены прогнозирования, чтобы помочь автоматизировать процесс выбора, настройки и обучения наиболее оптимальной модели для ваших целей.
Для создания группы наборов данных требуется имя и обозначение домена прогнозирования. Доступны следующие семь доменов прогнозирования:
· Розница — используется для прогнозирования розничного спроса.
· Планирование запасов — используется для прогнозирования спроса на сырье и определения того, сколько запасов любого данного товара имеется на складе.
· Емкость EC2 — используется для прогнозирования емкости Amazon Elastic Compute Cloud.
· Рабочая сила — используется для планирования и определения необходимого количества рабочей силы.
· Веб-трафик — используется для прогнозирования веб-трафика на веб-ресурс или набор веб-ресурсов.
· Метрики — используются для прогнозирования таких метрик, как выручка, продажи и денежный поток.
· Пользовательский — используется для создания прогнозов, которые не вписываются ни в одну из других предопределенных областей прогнозирования.
Единственным необходимым набором данных в Amazon Forecast является набор данных целевой временной ряд. Для целевого временного ряда требуются следующие поля с соответствующими типами данных:
· item_id(строка)
· отметка времени(отметка времени)
· целевое_значение(с плавающей запятой)
Обязательное поле target_value в наборе данных целевой временной ряд зависит от выбранного домена прогнозирования в группе наборов данных. Например, если вы выберете Планирование запасов в качестве Домена прогнозирования, target_value будет представлен спрос и будет помечен как «спрос» в столбце CSV. заголовок и схему вместо «target_value».
Набор данных связанные временные ряды — это первый из двух необязательных наборов данных. Связанный временной ряд содержит два обязательных поля: item_id и отметка времени. Поля Price, stockout_days, inventory_inhand, доход и in_stock рекомендуются для связанных временных рядов. Важно отметить, что любое поле, добавляемое в связанный временной ряд, не являющееся одним из обязательных полей, должно иметь тип данных integer или float.
Набор данных метаданные элемента — это второй из двух необязательных наборов данных. Для набора данных метаданные элемента требуется только поле item_id. Категория, торговая марка, время выполнения заказа, цикл_заказа и безопасный_запас — все это примеры дополнительных полей, которые можно включить в набор данных метаданные товара. Все поля в наборе данных метаданные элемента должны иметь строковый тип данных.
Чтобы импортировать наборы данных в группу наборов данных, Amazon Forecast требует создания схемы. Схемы, используемые для импорта наборов данных в группы наборов данных Amazon Forecast, должны соответствовать заголовкам столбцов как по имени, так и по порядку.
Ниже приведен пример схемы целевого временного ряда:
{
«Атрибуты»: [
{
«Имя атрибута»: «item_id»,
«Тип атрибута»: «строка»
},
{
«ИмяАтрибута»: «отметка времени»,
«Тип атрибута»: «отметка времени»
},
{
«ИмяАтрибута»: «спрос»,
«Тип атрибута»: «плавающий»
}
]
}
Ниже приведен пример того, как может выглядеть CSV-файл коррелирующих целевых временных рядов:
ITEM_ID,TIMESTAMP,DEMAND
11111,2019–10–05,10,7
22222,2019–10–05,42,0
33333,2019–10–05,3,12
Два из трех наборов данных включают третий этап настройки, требующий выбора частоты данных. Частота данных для набора данных целевого временного ряда и набора данных связанного временного ряда основана на значениях метки времени в полях метка времени.
Оба набора данных должны иметь паритет между собой в отношении значений меток времени и, соответственно, должны иметь одинаковую частоту данных.

Еще одна важная деталь, на которую следует обратить внимание, — это ограничение доступных форматов, которые можно использовать для представления полей меток времени в наборах данных прогноза. Все значения типа данных метки времени должны быть в формате гггг-ММ-дд или в формате гггг-ММ-дд ЧЧ:мм:сс. Любой другой формат метки времени приведет к сбою при импорте в группу наборов данных. Если частота данных вашего набора данных составляет минуты или часы, вы должны использовать формат гггг-ММ-дд ЧЧ:мм:сс.
После того, как все наборы данных будут успешно импортированы в группу наборов данных, можно создать предиктор. Predictor — это упрощенное и автоматизированное средство выбора, настройки и обучения модели прогноза. Есть несколько значений конфигурации, о которых следует помнить, чтобы обеспечить успешное обучение:
· Горизонт прогноза — сообщает Amazon Forecast, как далеко в будущем следует прогнозировать ваши данные, и задается в единицах, которые должны иметь прямую корреляцию с частотой данных в вашем целевом наборе данных временных рядов.
· Частота прогнозов — частота, с которой генерируются ваши прогнозы. Это значение должно быть больше или равно частоте набора данных целевого временного ряда.

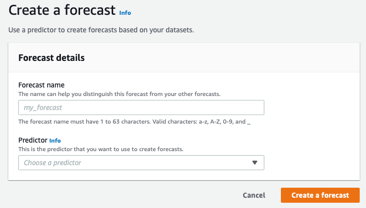
После завершения обучения Predictor его можно использовать для создания прогноза. И как только прогноз будет создан, его можно запросить с помощью поиска прогноза, чтобы сгенерировать прогноз для определенного элемента.


При этом остается только интерпретировать результаты. Значения P10, P50 и P90 имеют соответственно 10%, 50% и 90% вероятность удовлетворения фактического спроса; при этом значение P50 ближе всего к тому, каким должен быть фактический спрос.
Для получения дополнительной информации, пожалуйста, нажмите здесь:





