
Из предыдущей статьи https://medium.com/@chantrapornchai/arima-for-energy-consumption-data-part-ii-ac779b40586e мы рассматриваем использование авторегрессии с использованием statsmodel с ARIMA. Трудно определить p, q, d, хотя мы изучаем ACF, PACF. Одно из предложений — выполнить поиск по сетке на p, d, q, как в https://machinelearningmastery.com/grid-search-arima-hyperparameters-with-python/. Нам нужно повторить четыре цикла для возможных значений p, d, q, которые, тем не менее, значительно медленнее.
Одним из полезных методов является использование авто-аримы с помощью пирамиды-аримы https://www.alkaline-ml.com/pyramid/modules/generated/pyramid.arima.auto_arima.html#pyramid.arima.auto_arima, которая очень похожа на R авто-арима.
Из блога https://medium.com/@josemarcialportilla/using-python-and-auto-arima-to-forecast-seasonal-time-series-90877adff03c, https://www.analyticsvidhya.com/ blog/2018/08/auto-arima-time-series-modeling-python-r/, мы нашли применение auto-arima для нашего тематического исследования.
Параметров для auto_arima слишком много. Вы можете просмотреть подробности на странице https://www.alkaline-ml.com/pyramid/modules/generated/pyramid.arima.auto_arima.html#pyramid.arima.auto_arima. Для нашего использования мы вызываем с начальными параметрами:
stepwise_model = auto_arima(train, start_p=2, start_q=2,
                           max_p=4, max_q=4, m=10,
                           start_P=0, seasonal=False,
                           d=1,max_d=1,  D=1, trace=True,
                           error_action='ignore',
                           suppress_warnings=True,
                           stepwise=False, n_jobs=4 )
stepwise_model.fit(train)
Без параметра n_job он будет работать в непараллельном режиме. В пошаговом режиме точность модели должна быть выше. Однако этот режим не может работать с параметром n_job из-за характера вычислений. n_jobs не повлияет, если stepwise=True. Кроме того, при установке seasonal=True требуется правильное временное окно m. Для наших данных, когда m постоянно равно 24, 30 и т. д., они работают так медленно и используют слишком много ресурсов, что мы не можем завершить подгонку. Это связано с тем, что у нас есть точки данных 7x,xxx. Когда мы делим на 67% для обучения и остатка для тестирования, точки обучающих данных становятся 4x, xxx большими, и, поскольку наши данные основаны на минуте, когда мы хотим предсказать 60 минут вперед m становится 60. Это очень медленно. Итак, чтобы только продемонстрировать концепцию, мы устанавливаем seasonal=False и m=10 и запускаем ее. Мы должны установить seasonal=True также. Обратите внимание, что в большинстве демонстрационных наборов данных, которые составляются ежегодно, m=12 и набор данных хранится в ежемесячной записи.
В нашем случае данные всего за 2 месяца, но мы их очистили, как показано на https://medium.com/@chantrapornchai/introduction-to-data-science-with-energy-data-part-1-45f49b3682e8.
После завершения прогона окончательные параметры отображаются
print(stepwise_model.aic())
print(stepwise_model.summary()))
Результат перебора параметров показан на рис. 1. Мы также печатаем сводку параметров. Модель (p=4,d=1,p=4)

Мы можем сохранить модель в файле pickle.
with open(filename, 'wb') as pkl:
   pickle.dump(stepwise_model, pkl)
В следующий раз мы можем перезагрузить его для использования и не тратим время на обучение.
with open(model_file, ‘rb’) as pkl:
   stepwise_model = pickle.load(pkl)
Затем мы прогнозируем, используя данные тестирования для следующих контрольных точек.
future_forecast = stepwise_model.predict(n_periods=test_size)
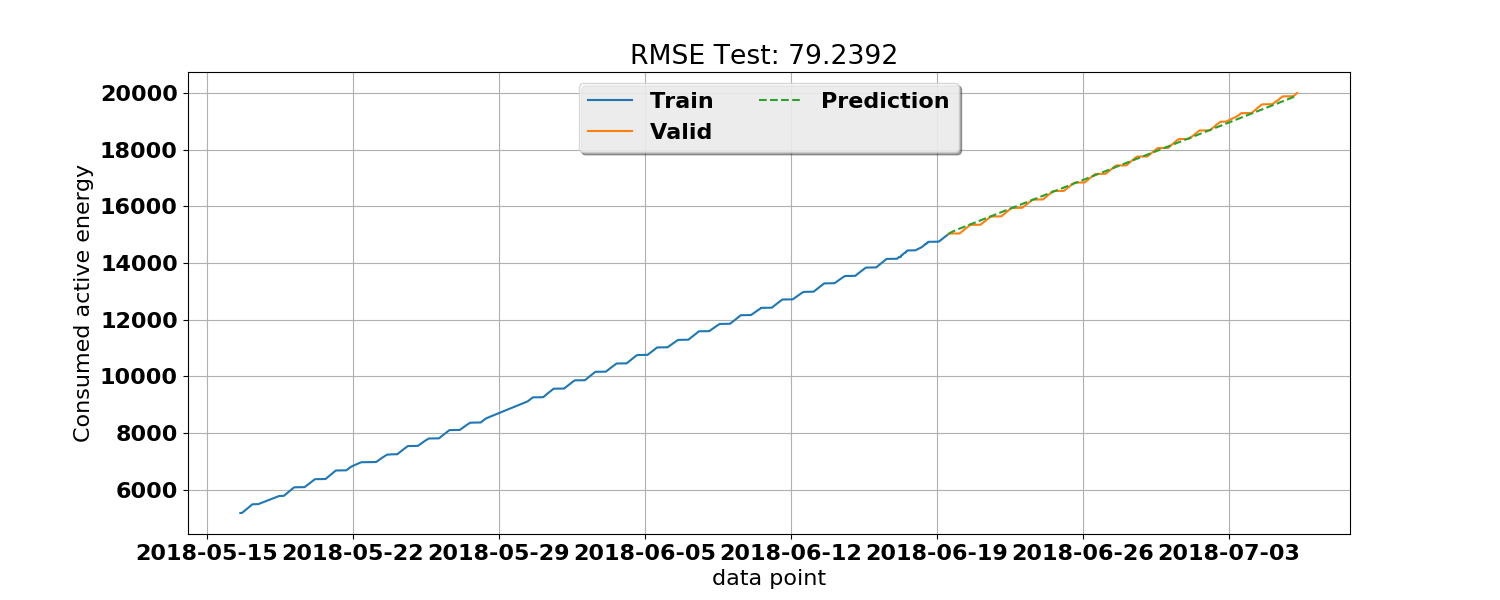
На рис. 2 показан тест RMSE для выбранной модели.
Полный код здесь.





