
Тим Сандерс провел это исследование в рамках своей магистерской программы по науке о данных и обществе в Тилбургском университете.
Я попытался предсказать уровень охвата вакцинацией в субнациональных районах на основе социально-демографических переменных с использованием моделей машинного обучения.
Показатели охвата вакцинацией в разных странах показывают, что существуют различия в субнациональных районах. Эти различия можно объяснить, взглянув на тип жителей субнациональной территории. Попытка объяснить влияние социально-демографических переменных на недоверие к вакцинам может предоставить интересную информацию для политиков.
В этом сообщении в блоге я хотел бы поделиться своими недавними выводами о том, как я предсказал уровень охвата вакцинацией в каждом муниципалитете Фландрии, Бельгия, используя модели машинного обучения со средней ошибкой 0,93% на лучшей модели.
Используемые модели машинного обучения: случайный лес, регрессия лассо и K-ближайшие соседи.
Выбор функций
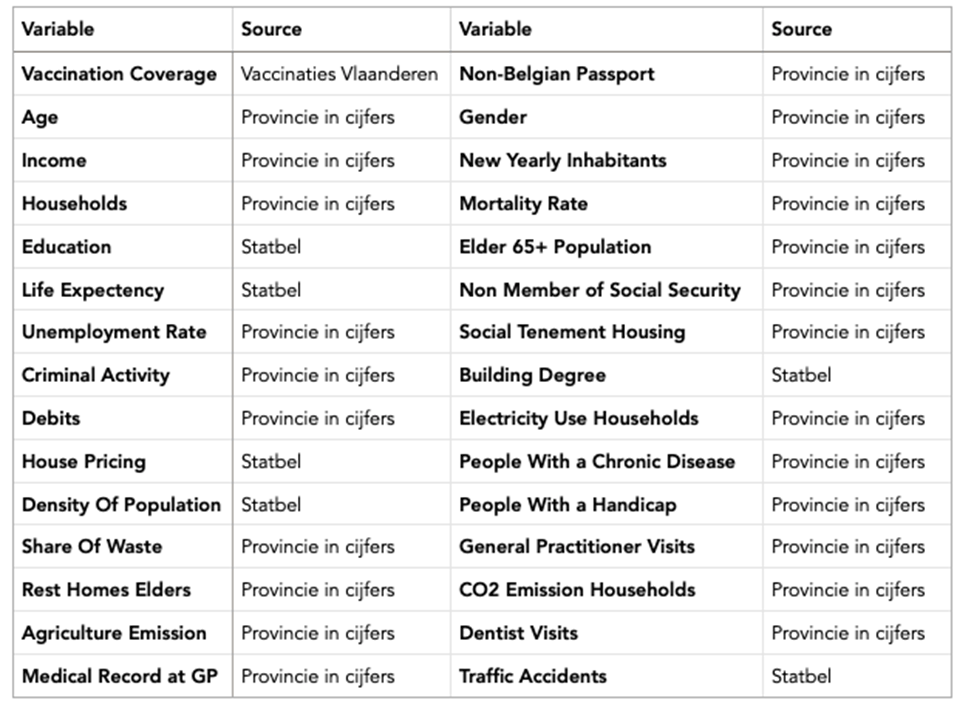
Процедура начинается с процесса выбора признаков. Я собрал соответствующие социально-демографические переменные с порталов открытых данных statbel и provincie in cijfers. Это правительственные организации в Бельгии. Эти переменные были агрегированы, например, путем взятия среднего уровня образования вместо включения всех уровней. Это привело к следующему набору социально-демографических переменных.
Поскольку социально-демографические переменные, как правило, сильно коррелированы, набор данных был протестирован на мультиколлинеарность с помощью теста Фаррара-Глаубера. В литературе рекомендуется удалять каждую переменную, набравшую выше порогового значения 10 по шкале VIF, поскольку это подразумевает высокую мультиколлинеарность, которая может привести к смещению ваших моделей. Матрица корреляции Пирсона R выполняется, чтобы определить, какие переменные следует удалить, чтобы устранить мультиколлинеарность. После этого алгоритм Боруты классифицировал оставшиеся переменные как важные или неважные по отношению к переменной результата, коэффициенту охвата вакцинацией. Это привело к тому, что некоторые переменные были классифицированы как неважные и затем были исключены из набора данных.
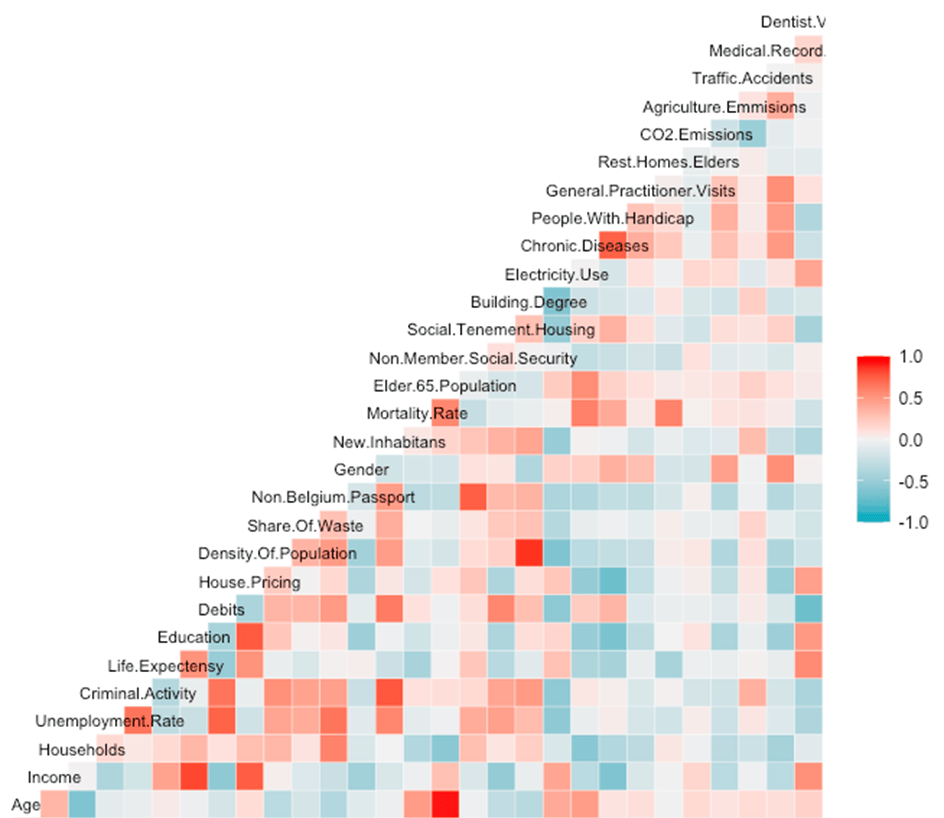
Матрица корреляции показала, что возраст, по-видимому, сильно коррелирует с долей пожилых людей старше 65 лет, жители без бельгийского паспорта, по-видимому, сильно коррелируют с отсутствием членства в системе социального обеспечения, а доход, по-видимому, сильно коррелирует с образованием. Переменная важность случайного леса и алгоритма Боруты использовалась, чтобы решить, какую из этих переменных следует удалить. Поскольку не являясь членом системы социального обеспечения, население старше 65 лет и уровень образования имели наименьшую важность переменной, было решено удалить эти три переменные из набора данных. После удаления этих переменных снова был проведен тест Фаррара-Глаубара. Это показало, что в наборе данных больше нет высокой мультиколлинеарности, поскольку каждая переменная оценивалась ниже порогового значения по шкале VIF.
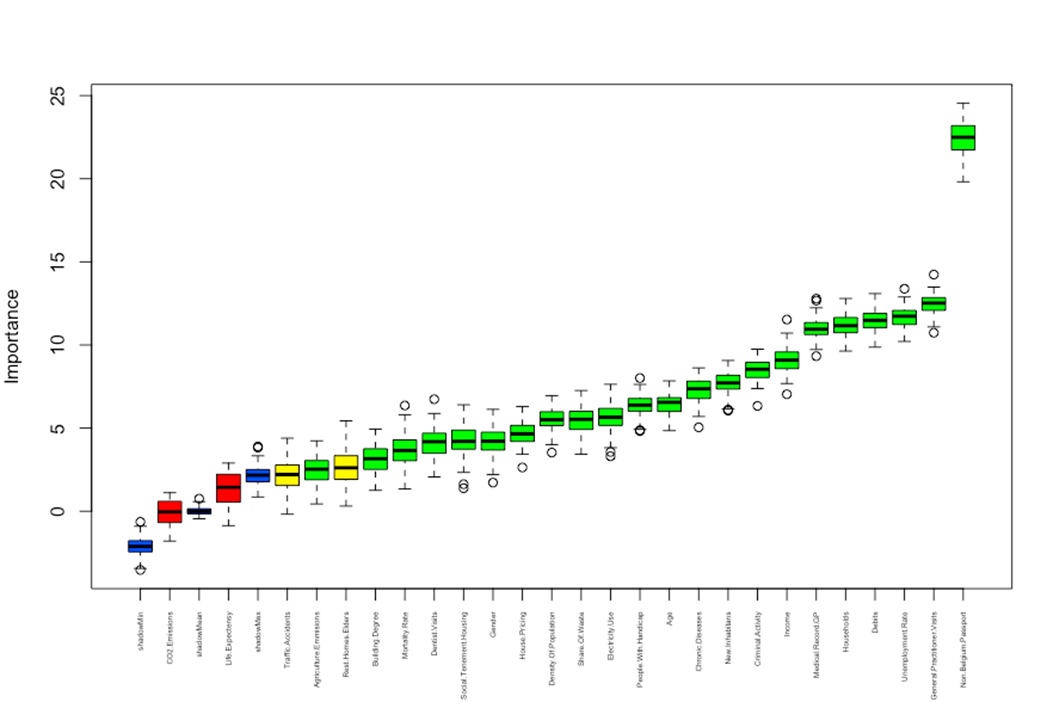
Последним методом выбора признаков, который я использовал, был алгоритм Боруты. Борута показал, что переменные выбросы CO-2, ожидаемая продолжительность жизни, дорожно-транспортные происшествия и дома престарелых являются неважными переменными, связанными с переменным результатом охвата вакцинацией. По этой причине эти переменные были удалены из набора данных. Удаление этих переменных показало снижение частоты ошибок всех моделей. Модели машинного обучения также обучались и тестировались только на самых важных переменных, вытекающих из алгоритма Боруты. Сохранение только тех функций, значение которых превышает пороговое значение в 5%, привело к более высоким ошибкам в моделях, показывая, что лучше сохранить весь выбор.
Обучение моделей:
Наши данные были разделены на обучающий набор, содержащий 70% данных, и тестовый набор, содержащий 30% данных. Первой моделью был случайный лес. Для случайного леса настраиваемыми параметрами являются mtry, количество деревьев и максимальное количество узлов. Перекрестная проверка показала, что наилучшие результаты были получены при mtry = 12, ntrees = 500 и maxnodes = 22. Вторая модель, которую я применил, — регрессия лассо. Параметр регуляризации был настроен с использованием перекрестной проверки и дал наилучшие результаты при оценке по умолчанию, равной 1. Последняя модель — это KNN. Параметр K был настроен с помощью поиска по сетке, в результате чего K = 24.
Результаты модели:
Различные модели были обучены, проверены и протестированы на данных. Важной частью перед прочтением этих результатов является понимание масштаба переменной результата: охват вакцинацией. Эти результаты показаны в таблице ниже (эти данные относятся к 15 сентября 2021 года и включают 283 муниципалитета во Фландрии после исключения дела).
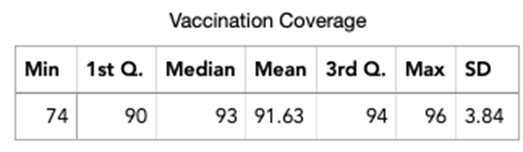
Как видно из таблицы, шкала небольшая, со стандартным отклонением 3,84, половина данных находится в диапазоне 90–94%, а разница между минимумом и максимумом составляет 22. Это приведет к потенциально очень низкой частоте ошибок. Выполнение случайного леса, k-ближайших соседей и регрессии лассо приводит к следующим результатам обучения и набора тестов.
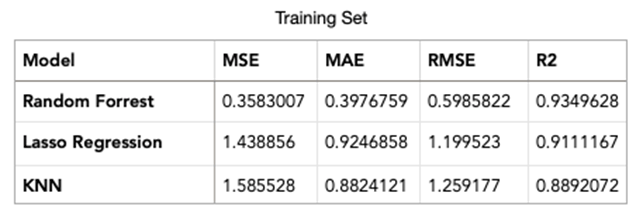
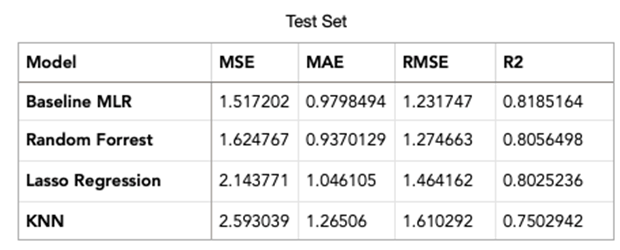
Глядя на результаты моделей на тестовом наборе, можно сделать вывод, что социально-демографические переменные могут очень хорошо предсказать охват вакцинацией против COVID-19 на субнациональных территориях. Хотя масштаб охвата прививками невелик, с помощью случайного леса удалось предсказать охват прививками со средней разницей в 0,93% от фактического охвата прививками во Фландрии. Демонстрация того, что данные о социально-демографических переменных для прогнозирования охвата вакцинацией могут быть полезны для определения районов с потенциально низким охватом вакцинацией для будущих пандемий или программ дополнительной вакцинации против COVID-19.
Глядя на разницу в частоте ошибок на обучающем и тестовом наборах, все модели работают на тестовом наборе немного хуже, чем на тренировочном наборе. Это может указывать на переоснащение моделей. Для противодействия переобучению было применено несколько методов. Параметры моделей были настроены, и с помощью перекрестной проверки были выбраны лучшие параметры моделей. Снижение набора функций путем выбора лучших функций в процессе выбора функций также должно уменьшить переобучение. Окончательный тест был проведен путем выполнения моделей на нескольких обучающих/тестовых наборах. Это показало минимальные различия в результатах, показывающие, что наши модели будут по-прежнему работать примерно одинаково на разных наборах невидимых данных. Поскольку все обсуждаемые методы и результаты невидимых данных все еще были точными, никаких дальнейших действий предпринято не было.
Результаты, интересные для разработки политики:
Это исследование предоставило информацию, относящуюся к сектору науки о данных, однако результаты этого исследования также предоставляют полезную информацию для разработки политики по улучшению охвата вакцинацией против COVID-19. В приведенной ниже таблице влияние увеличения переменной отражено на охват вакцинацией. Он проектирует модель потенциального риска для субнациональных территорий в случае возможной будущей пандемии.
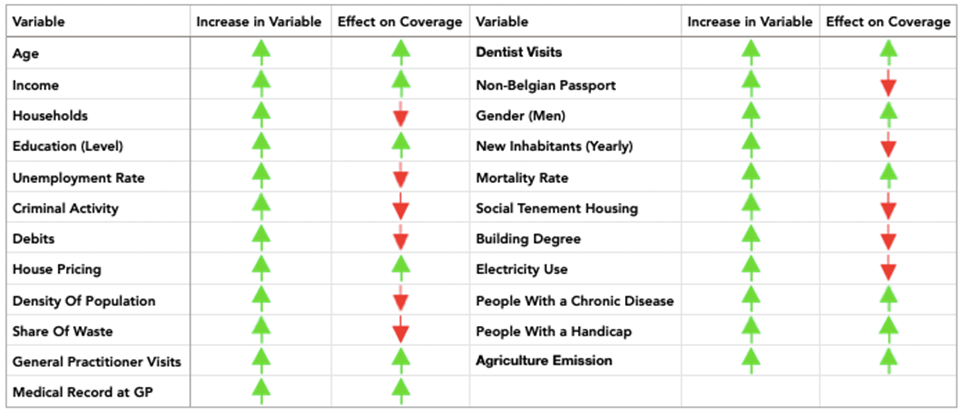
Эта таблица показывает, что в субнациональном районе, вероятно, будет низкий охват вакцинацией, когда: средний возраст низкий, доходы низкие, количество людей в домохозяйстве высокое, уровень образования низкий, уровень безработицы высокий, преступная деятельность высока, долги высоки, цены на жилье низки, плотность населения высока, доля отходов высока, а врач общей практики и стоматолог посещают мало. Кроме того, охват также будет ниже, если имеется большое количество людей без бельгийского паспорта, небольшое количество домов отдыха, больше женщин, чем мужчин, много новых жителей, небольшое количество социальных многоквартирных домов, высокий уровень строительства, высокий уровень потребления электроэнергии, низкий уровень сельскохозяйственных выбросов и небольшая доля людей с инвалидностью или хроническими заболеваниями.
Еще один жизненно важный аспект для политиков заключается в том, что релевантность социально-демографических переменных варьируется. Переменная важность нашей наиболее эффективной модели машинного обучения (случайный лес) показана в таблице ниже. Чем выше важность, тем выше влияние переменной на охват вакцинацией.

Важно помнить, что мы прогнозируем использование вакцин на муниципальном, а не на индивидуальном уровне. Например, возраст, по-видимому, оказывает незначительное влияние в этом анализе, но может быть более важным на индивидуальном уровне.
Заключительные замечания:
При текущем планировании будущих кампаний вакцинации против COVID-19 или других заболеваний прогнозирование использования вакцинации может стать бесценным инструментом для политиков и работников здравоохранения. В этом блоге была предпринята попытка предсказать использование вакцин с помощью общедоступных данных. Лучшая модель смогла предсказать поглощение со средней ошибкой 0,93%.
Для тех, кто заинтересован в работе с этими данными, я включаю набор данных и код для воспроизведения матрицы корреляции, чтобы вы могли начать работу.
library(dplyr)
library(GGally)
library(readr)
set.seed(123)
dataset <- read_csv2("https://storage.googleapis.com/public_dm/data.csv") %>%
  select(-municipalities)
#Correlation matrix
ggcorr(dataset, method = c("everything", "pearson")
              , size = 3
              , layout.exp = 3)





