
В этом посте я хотел бы обсудить задачу по науке о данных, которую я недавно выполнил. Сначала я объясню описание проблемы, цель и набор данных. Далее выполняется визуализация данных и выбираются важные функции для обучения модели машинного обучения.
Описание проблемы:
Рекламная компания продает услугу покупки ключевых слов в поисковых системах от имени своих клиентов. Они пытаются оптимизировать свои ключевые слова и распределение средств. Первый путь к оптимальному решению - прогнозировать производительность по ключевым словам и фондам.
Цель:
Прогнозирование для любого ключевого слова (не обязательно в файле набора данных), цены за клик и рыночного (США / Великобритания) трафика, который получит веб-сайт (т. Е. Кликов).
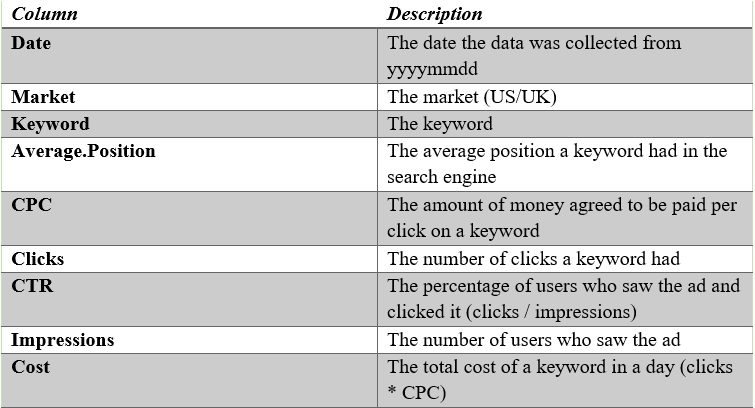
Описание набора данных:
# importing necessary libraries
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
%matplotlib inline
from sklearn.model_selection import train_test_split
from nltk.tokenize import word_tokenize
from nltk.corpus import stopwords
import re
import nltk
nltk.download('stopwords')
Чтение набора данных с сортировкой по атрибуту «Дата».
df = pd.read_csv('Dataset.csv')
df.sort_values(by='Date',inplace=True)
df.head()

Изначально я использовал метод описания, чтобы иметь интуитивное представление о количестве непропущенных значений, среднем, стандартном отклонении, диапазоне, медиане, квартилях 0,25 и 0,75.
data.describe()

Теперь преобразование атрибута Date в формат даты и времени (ГГГГ-ММ-ДД) для извлечения таких функций, как год, месяц, день недели, день года и т. Д.
data[‘Date’] = data[‘Date’].apply(lambda x: pd.to_datetime(str(x), format=’%Y%m%d’, errors=’ignore’))
date_data = data['Date']
date = pd.DataFrame({'year':date_data.dt.year,
                     'month':date_data.dt.month,
                    'week':date_data.dt.week,
                    'dayofweek':date_data.dt.dayofweek,
                    'dayofyear':date_data.dt.dayofyear})
Категориальные переменные преобразуются в фиктивные переменные.
Market = pd.get_dummies(data['Market'],drop_first=True)
train_data = pd.concat([date,Market,data],axis=1)
train_data.drop(['Date','Market'],axis=1,inplace=True)
Затем я построил график гистограммы каждой независимой функции, чтобы получить распределение каждой функции. Было замечено, что количество кликов = «0» было больше по сравнению с другими числами. Кроме того, в 2012 году количество кликов было больше, чем в 2013 году. Кроме того, в месячном исчислении большинство кликов приходилось на август - декабрь. Если мы видим день недели, наибольшее количество кликов было по вторникам. И большинство кликов приходилось на рынок США.
train_data.hist(figsize=(15, 15), bins=50, xlabelsize=8, ylabelsize=8)

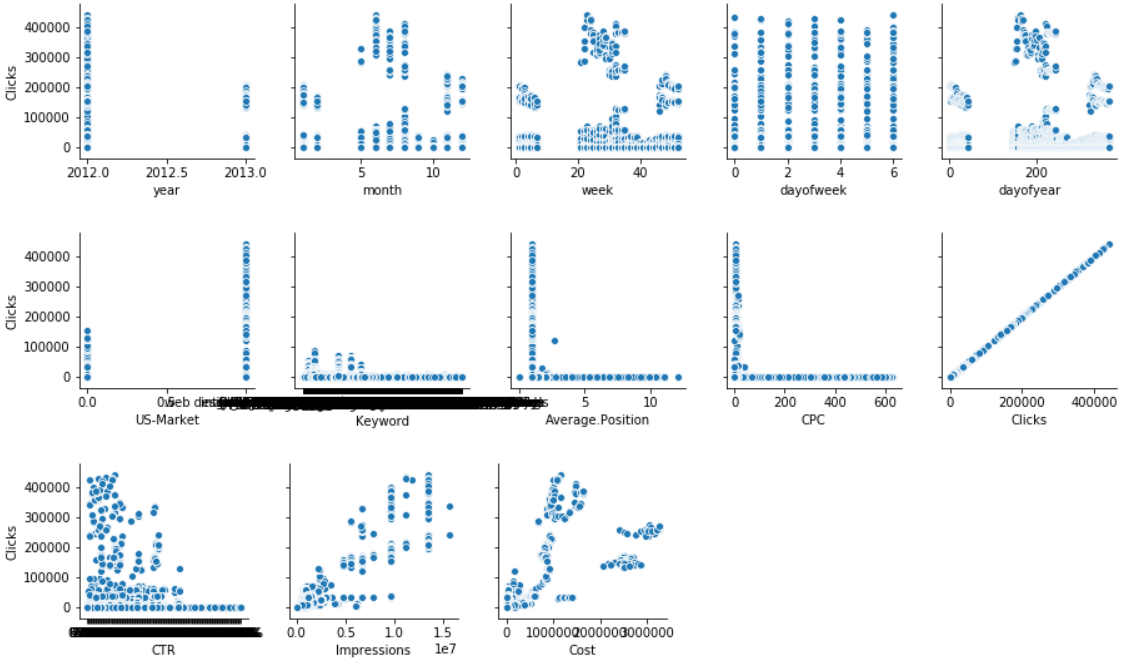
Теперь, чтобы определить важность числовых функций, я построил парный график между целевой переменной = ’clicks’ и всеми другими функциями. Было замечено, что такие функции, как стоимость, показы, CTR, цена за клик, неделя, день года, имеют линейную связь с целевой переменной.
for i in range(0, len(train_data.columns), 5):
    sns.pairplot(data=train_data,
                x_vars=train_data.columns[i:i+5],
                y_vars=['Clicks'])
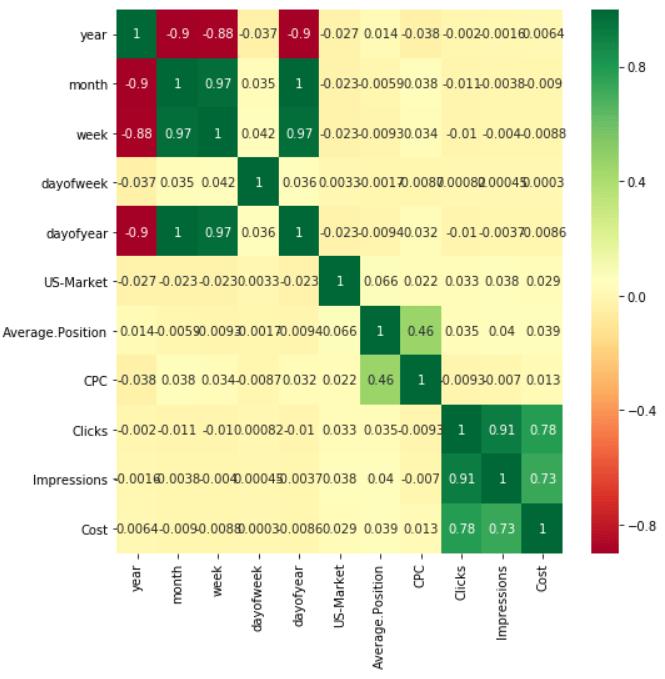
Чтобы дополнительно проверить важные функции, я построил корреляционную матрицу с тепловой картой. Замечено, что только два показа и стоимость функций сильно коррелировали с целевой переменной. Мы также можем видеть сильные отрицательные корреляции на тепловой карте.
corrmat = train_data.corr()
top_corr_features = corrmat.index
plt.figure(figsize=(8,8))
#plot heat map
g=sns.heatmap(train_data[top_corr_features].corr(),annot=True,cmap=”RdYlGn”)
Предварительная обработка / очистка текста была произведена для ключевых слов:
Изначально все числа, знаки препинания, символы удалялись из ключевых слов с помощью регулярных выражений. Затем ключевые слова были переведены в нижний регистр и токенизированы. После токенизации ключевых слов стоп-слова были удалены с помощью стоп-слов NLTK.
Встраивание слов применяется к очищенным ключевым словам:
После очистки данных каждое слово ключевого слова необходимо преобразовать в векторы слов, чтобы можно было обучить модель машинного обучения, поскольку алгоритмы не могут обрабатывать простой текст или строки в необработанном виде. Встраивание слов - это векторы, которые фиксируют семантическую и контекстную информацию слов. Здесь я использовал встраивание слов на основе Fasttext, которое дало вектор размерности 300 для каждого слова в ключевом слове. Таким образом, чтобы сгенерировать единственный вектор для полного ключевого слова, было взято среднее значение векторов каждого слова в ключевом слове.
В данной задаче количество кликов является целевой переменной, которая должна быть предсказана обученной моделью, если для даты, рынка, ключевых слов и цены за клик были заданы характеристики. Поскольку количество кликов имеет положительные непрерывные значения, я смоделировал проблему как проблему регрессии. В данных было много значений «Nan», которые были отброшены вместо того, чтобы выполнять импутации данных и заменять значения Nan. Потому что у нас все функции были Nan для некоторых конкретных ключевых слов, и поэтому мы не уверены, сколько кликов, показов или стоимости может быть для этих ключевых слов. Кроме того, поскольку объем данных огромен, это не повлияет, даже если мы удалим эти меньшее количество данных. Теперь, поскольку дата, в которую был произведен поиск по ключевому слову, могла иметь важные функции, я извлек такие функции, как год, месяц, неделя, день недели и день года, из даты, добавленной к данным. Категориальные значения были преобразованы в фиктивные переменные.
В формулировке задачи было упомянуто, что с учетом ключевых слов и цены за клик для каждого рынка (США / Великобритания) на дату 14.02.2013 модель должна прогнозировать количество кликов. Итак, я смоделировал проблему, взяв два разных набора функций:
а) X = ключевые слова, рынок и цена за клик.
б) X = год, месяц, неделя, день недели, день года, ключевые слова, рынок и цена за клик.
Целевая переменная была установлена как Y = количество кликов.
Я использовал классические модели машинного обучения и глубокого обучения, такие как регрессия случайного леса, регрессия Xgboost, 1D-CNN и GRU для обучения и оценки данных. Указанные данные разделяются на данные для обучения и тестирования путем сортировки по дате. Все данные за 2012 год были взяты за данные поезда, а все данные за 2013 год были взяты как данные испытаний.
Коды доступны в моем профиле GitHub: https://github.com/Vyshnavmt94/Predict-the-Click-Through-Rate-for-Keywords-Using-Machine-Learning-Methodologies
Результаты:
а) X = ключевые слова, рынок и цена за клик.
Регрессия случайного леса:
Coefficient of determination R² of the prediction: 0.914177804049537
Mean squared error: 297606.09
Test Variance score: 0.80
mean_absolute_error: 74.95
Регрессия XGboost:
Coefficient of determination R^2 of the prediction.  0.5800091699348091
Mean squared error: 393330.94
Test Variance score: 0.74
mean_absolute_error: 213.09
1-DCNN: (70 эпох)
Mean squared error: 183220.71
Test Variance score: 0.88
mean_absolute_error: 61.83
ГРУ: (20 эпох)
Mean squared error: 125502.27
R2 score: 0.92
mean_absolute_error: 70.50
б) X = год, месяц, неделя, день недели, день года, ключевые слова, рынок и цена за клик.
Регрессия случайного леса:
коэффициент детерминации R² прогноза .: 0.9976723650491951
Mean squared error: 1008241.56
Test Variance score: 0.33
mean_absolute_error: 175.60
Регрессия XGboost:
коэффициент детерминации R² прогноза .: 0.6653407930753578
Mean squared error: 519430.67
Test Variance score: 0.65
mean_absolute_error: 224.09
1-DCNN: (30 эпох)
Mean squared error: 9360270.80
R2 score: -5.25
mean_absolute_error: 2336.26
ГРУ: (30 эпох)
Mean squared error: 1535167.11
R2 score: -0.02
mean_absolute_error: 193.50
Я надеюсь, что этот пост будет полезен для понимания визуализации данных для извлечения лучших функций и обучения модели машинного обучения.





