
Скрытое распределение Дирихле (LDA) - это «генеративная вероятностная модель» набора композитов, состоящих из частей. С точки зрения тематического моделирования составные части - это документы, а части - слова и / или фразы (н-граммы). Но вы можете применить LDA к ДНК и нуклеотидам, пицце и начинкам, молекулам и атомам, сотрудникам и навыкам или клавиатурам и крошкам.
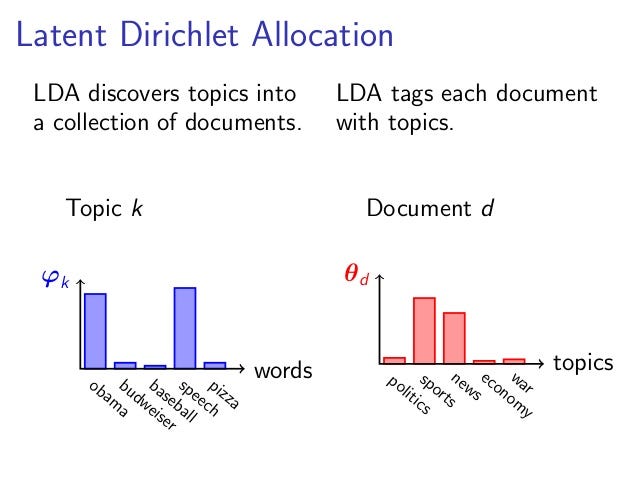
Скрытое распределение Дирихле (LDA) - это метод, который автоматически обнаруживает темы, содержащиеся в этих документах.
Предположим, у вас есть следующий набор предложений:
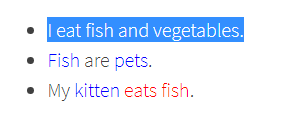
Учитывая приведенные выше предложения, LDA может классифицировать красные слова в теме F, которые мы можем обозначить как «еда». Точно так же синие слова могут быть отнесены к отдельной теме P, которую мы можем обозначить как «домашние животные». LDA определяет каждую тему как набор слов, и вы должны маркировать темы так, как считаете нужным.
Определение тем на уровне слов дает два преимущества:
1) Мы можем сделать вывод о распространении содержания каждого предложения по количеству слов:
Предложение 1: 100% тема F
Предложение 2: 100% тема P
Предложение 3: 33% тема P и 67% Тема F
2) Мы можем вывести пропорции, которые каждое слово составляет в заданных темах. Например, тема F может содержать слова в следующих пропорциях: 40% едят, 40% рыбы, 20% овощей,…
LDA достигает вышеуказанных результатов за 3 шага.
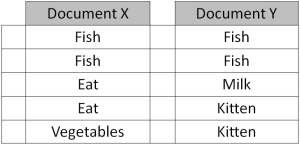
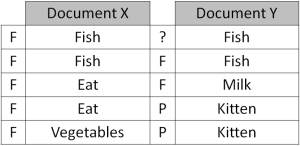
Чтобы проиллюстрировать эти шаги, представьте, что теперь вы открываете темы в документах, а не в предложениях. Представьте, что у вас есть 2 документа со следующими словами:
Шаг 1
Вы сообщаете алгоритму, сколько тем, по вашему мнению, существует. Вы можете использовать обоснованную оценку (например, результаты предыдущего анализа) или просто методом проб и ошибок. Пробуя разные оценки, вы можете выбрать ту, которая создает темы для желаемого уровня интерпретируемости, или ту, которая дает наивысшую статистическую достоверность (т. Е. Логарифмическую вероятность). В нашем примере выше количество тем можно определить, просто взглянув на документы.
Шаг 2
Алгоритм присвоит каждому слову временную тему. Назначения тем являются временными, поскольку они будут обновлены на шаге 3. Временные темы назначаются каждому слову полуслучайным образом (если быть точным, согласно распределению Дирихле). Это также означает, что если слово встречается дважды, каждое слово может быть отнесено к разным темам. Обратите внимание, что при анализе реальных документов функциональные слова (например, «the», «and», «my») удаляются и не назначаются никаким темам.
Шаг 3 (итеративный)
Алгоритм проверяет и обновляет назначения тем, перебирая каждое слово в каждом документе. Для каждого слова его тематическое назначение обновляется на основе двух критериев:
- Насколько распространено это слово в разных темах?
- Насколько распространены темы в документе?
Чтобы понять, как работают эти два критерия, представьте, что мы сейчас проверяем назначение темы на предмет слова «рыба» в документе Y:
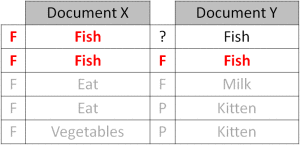
- Насколько распространено это слово в разных темах? Поскольку слова «рыба» в обоих документах составляют почти половину оставшихся слов темы F, но 0% оставшихся слов темы P, случайное слово «рыба», скорее всего, будет относиться к теме F.
- Насколько распространены темы в документе? Поскольку слова в Док. Y отнесены к теме F и теме P в соотношении 50–50, оставшееся слово «рыба», похоже, с одинаковой вероятностью относится к любой теме.
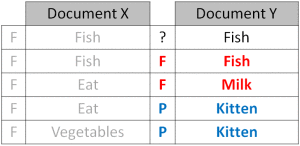
Взвешивая выводы из двух критериев, мы бы присвоили слово «рыба» из документа Y теме F. Тогда документ Y мог бы быть документом о том, чем кормить котят.
Процесс проверки назначения темы повторяется для каждого слова в каждом документе, многократно проходя через всю коллекцию документов. Это итеративное обновление - ключевая особенность LDA, которая генерирует окончательное решение с последовательными темами.





