

Вы разрабатываете приложения LLM с использованием LangChain? Процесс тонкой настройки LLM — ключевой этап при разработке приложения LLM, адаптированного к конкретному варианту использования или отрасли. Эффективность LLM во многом зависит от качества и объема данных. Изобилие данных приводит к более богатому набору вложений, что усиливает способность LLM к обобщению. Однако это преимущество связано с одной оговоркой: Качество! Качество данных имеет приоритет, особенно если ваши данные заполнены нерелевантными данными.
Следующие шаги описывают процесс тонкой настройки при работе с LangChain:
1. Загрузчики документов:
LangChain предоставляет модуль «document_loaders», позволяющий загружать различные типы документов локально или с серверов. Первым шагом является использование соответствующего загрузчика документов с правильными фильтрами.
Например, если вы хотите извлечь содержимое из файла README.md в репозиторий GitHub, вы можете использовать GitLoader:

Дополнительные сведения об интеграции см. в разделе Интеграция с загрузчиком документов
2. Предварительная обработка:
Перед процессом тонкой настройки необходимо предварительно обработать данные и удалить любой контент, не относящийся к вашему LLM. Например, загруженные данные могут содержать HTML-теги или цитаты, которые не имеют отношения к делу — их следует устранить.
Вот пример удаления тегов HTML из документа:
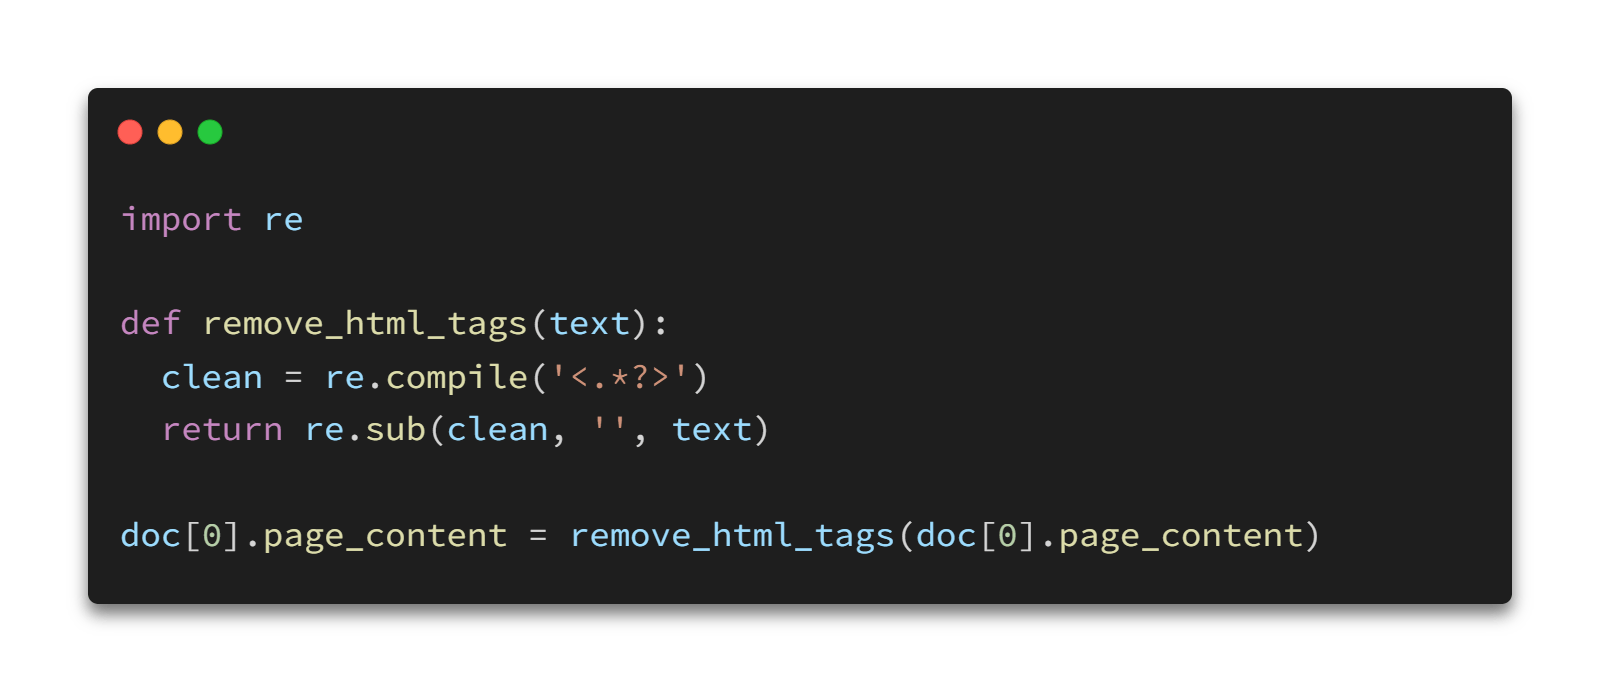
Если ваш документ большой, рекомендуется предварительно обработать содержимое, разбив документ на более мелкие фрагменты.
3. Разбор:
После загрузки и предварительной обработки ваших документов вам может потребоваться преобразовать их, чтобы они лучше соответствовали вашему приложению. Распространенным преобразованием является сегментация длинного документа на более мелкие фрагменты, которые могут поместиться в контекстное окно вашей модели. LangChain предоставляет несколько встроенных преобразователей документов для разделения, объединения, фильтрации и управления документами.
Например, вы можете сегментировать документы на куски размером 4000 с перекрытием по 500 символов, используя MarkdownTextSplitter и RecursiveCharacterTextSplitter:

Подробнее об интеграции см. в разделе Преобразователи документов.
4. Вложения:
Создание векторных представлений текста — важный шаг в тонкой настройке LLM. LangChain предлагает два типа вложений — один для встраивания документов, а другой — для встраивания запросов. Например, вы можете использовать OpenAIEmbeddings:
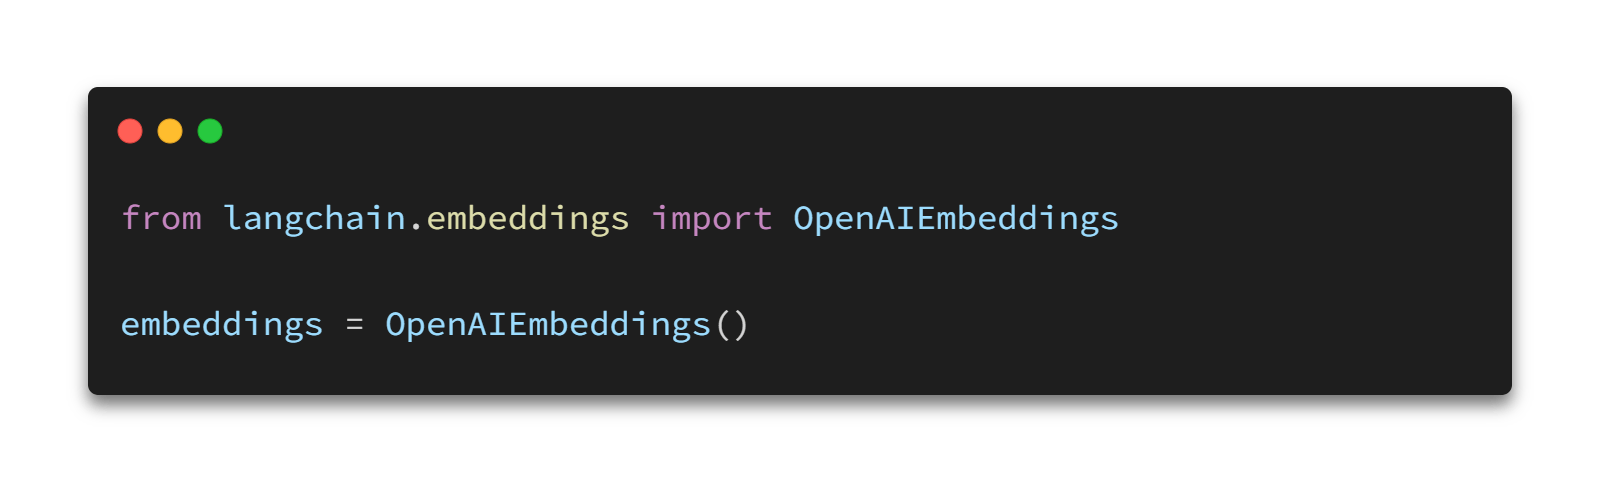
LangChain предоставляет множество интеграций для встраивания документов и запросов. Выберите тот, который лучше всего соответствует вашему приложению. Для перевода текста распространенным подходом является использование OpenAIEmbeddings, в то время как встраивания Cohere хорошо работают в других сценариях, таких как перевод текста. В конечном итоге выбор зависит от типа и цели вашего приложения.
Дополнительные сведения об интеграции см. в разделе Встраивание текста
5. Векторные магазины:
После генерации текстовых вложений вам потребуется хранилище векторов для хранения этих векторов в базе данных. Хранилище векторов обеспечивает хранение встроенных данных и поиск векторов за вас. Например, вы можете использовать Qdrant:
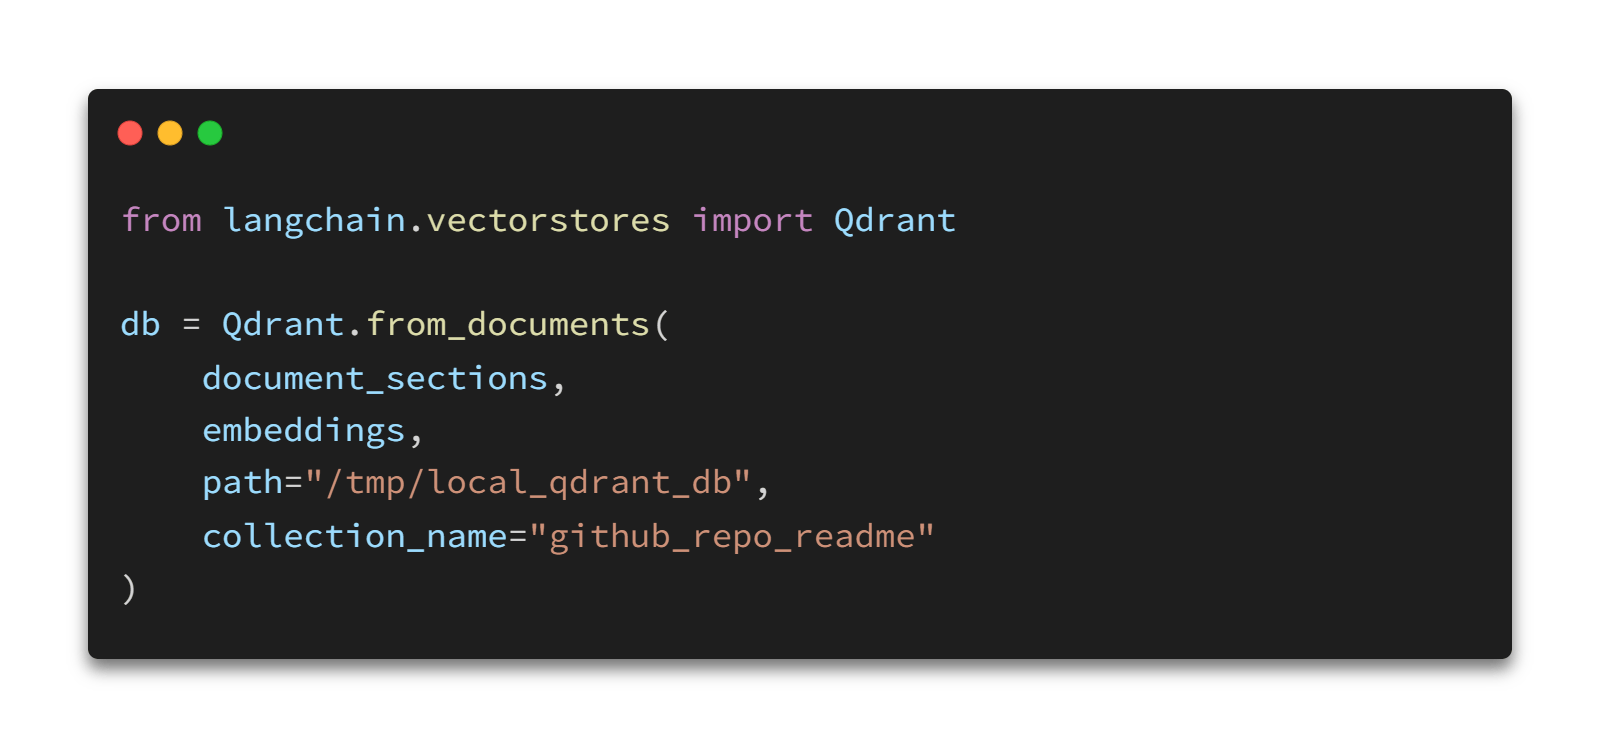
LangChain поддерживает различные интеграции векторных хранилищ:
- DocArrayInMemorySearch: подходит для небольших наборов данных, для которых не требуется сервер базы данных.
- Qdrant: готовая к работе служба с удобным API для хранения, поиска и управления векторами с дополнительными полезными данными.
- PGVector: Предлагает поиск сходства векторов с открытым исходным кодом для Postgres.
- Redis. Хранилище структуры данных в памяти, используемое в качестве распределенной базы данных с ключом и значением в памяти, кеша и брокера сообщений, с дополнительной устойчивостью.
…
См.: Интеграция с векторным магазином
В последующих статьях мы обсудим дальнейшие шаги в процессе тонкой настройки: шаблоны подсказок, LLM, цепочки, агенты и оценки.
Ресурсы:
- LangChain: https://python.langchain.com/docs/get_started/introduction.html
- Загрузчики документов LangChain: https://python.langchain.com/docs/modules/data_connection/document_loaders/
- Преобразователи документов LangChain: https://python.langchain.com/docs/modules/data_connection/document_transformers/
- Встраивание текста LangChain: https://python.langchain.com/docs/modules/data_connection/text_embedding/
- Векторные магазины LangChain: https://python.langchain.com/docs/modules/data_connection/vectorstores/
Соблюдая эти шаги и используя возможности LangChain, вы можете точно настроить свои приложения LLM для достижения оптимальной производительности и настройки. Возможность тонкой настройки этих моделей для инженера или исследователя открывает мир возможностей для создания приложений, которые могут осмысленно понимать, генерировать и взаимодействовать с использованием человеческого языка, а понимание этого процесса может дать представление о том, как ваша команда могут наилучшим образом использовать эти инструменты, а также необходимые данные и инфраструктуру. Будущее NLP уже здесь, и с такими инструментами, как LangChain, оно стало более доступным, чем когда-либо.





