
Добро пожаловать в блог «Введение в нейронные сети и глубокое обучение». Это мой первый блог по глубокому обучению на среднем сайте. Я надеюсь, что вам всем нравится этот блог; хорошо, я не хочу тратить ваше время. Давайте приготовимся прыгнуть в это Глубокое Путешествие.
Что такое глубокое обучение?
Проще говоря, глубокое обучение — это подмножество машинного обучения (МО), в котором алгоритмы искусственных нейронных сетей, смоделированные для работы подобно человеческому мозгу, учатся на больших объемах данных.
Например, Google использует глубокое обучение в своих алгоритмах распознавания голоса и изображений, тогда как Netflix и Amazon используют его для понимания поведения своих клиентов.
Что такое нейронная сеть?
Нейронные сети отражают поведение человеческого мозга, позволяя компьютерным программам распознавать закономерности и решать общие проблемы в области искусственного интеллекта, машинного обучения и глубокого обучения.
Базовая структура нейронной сети

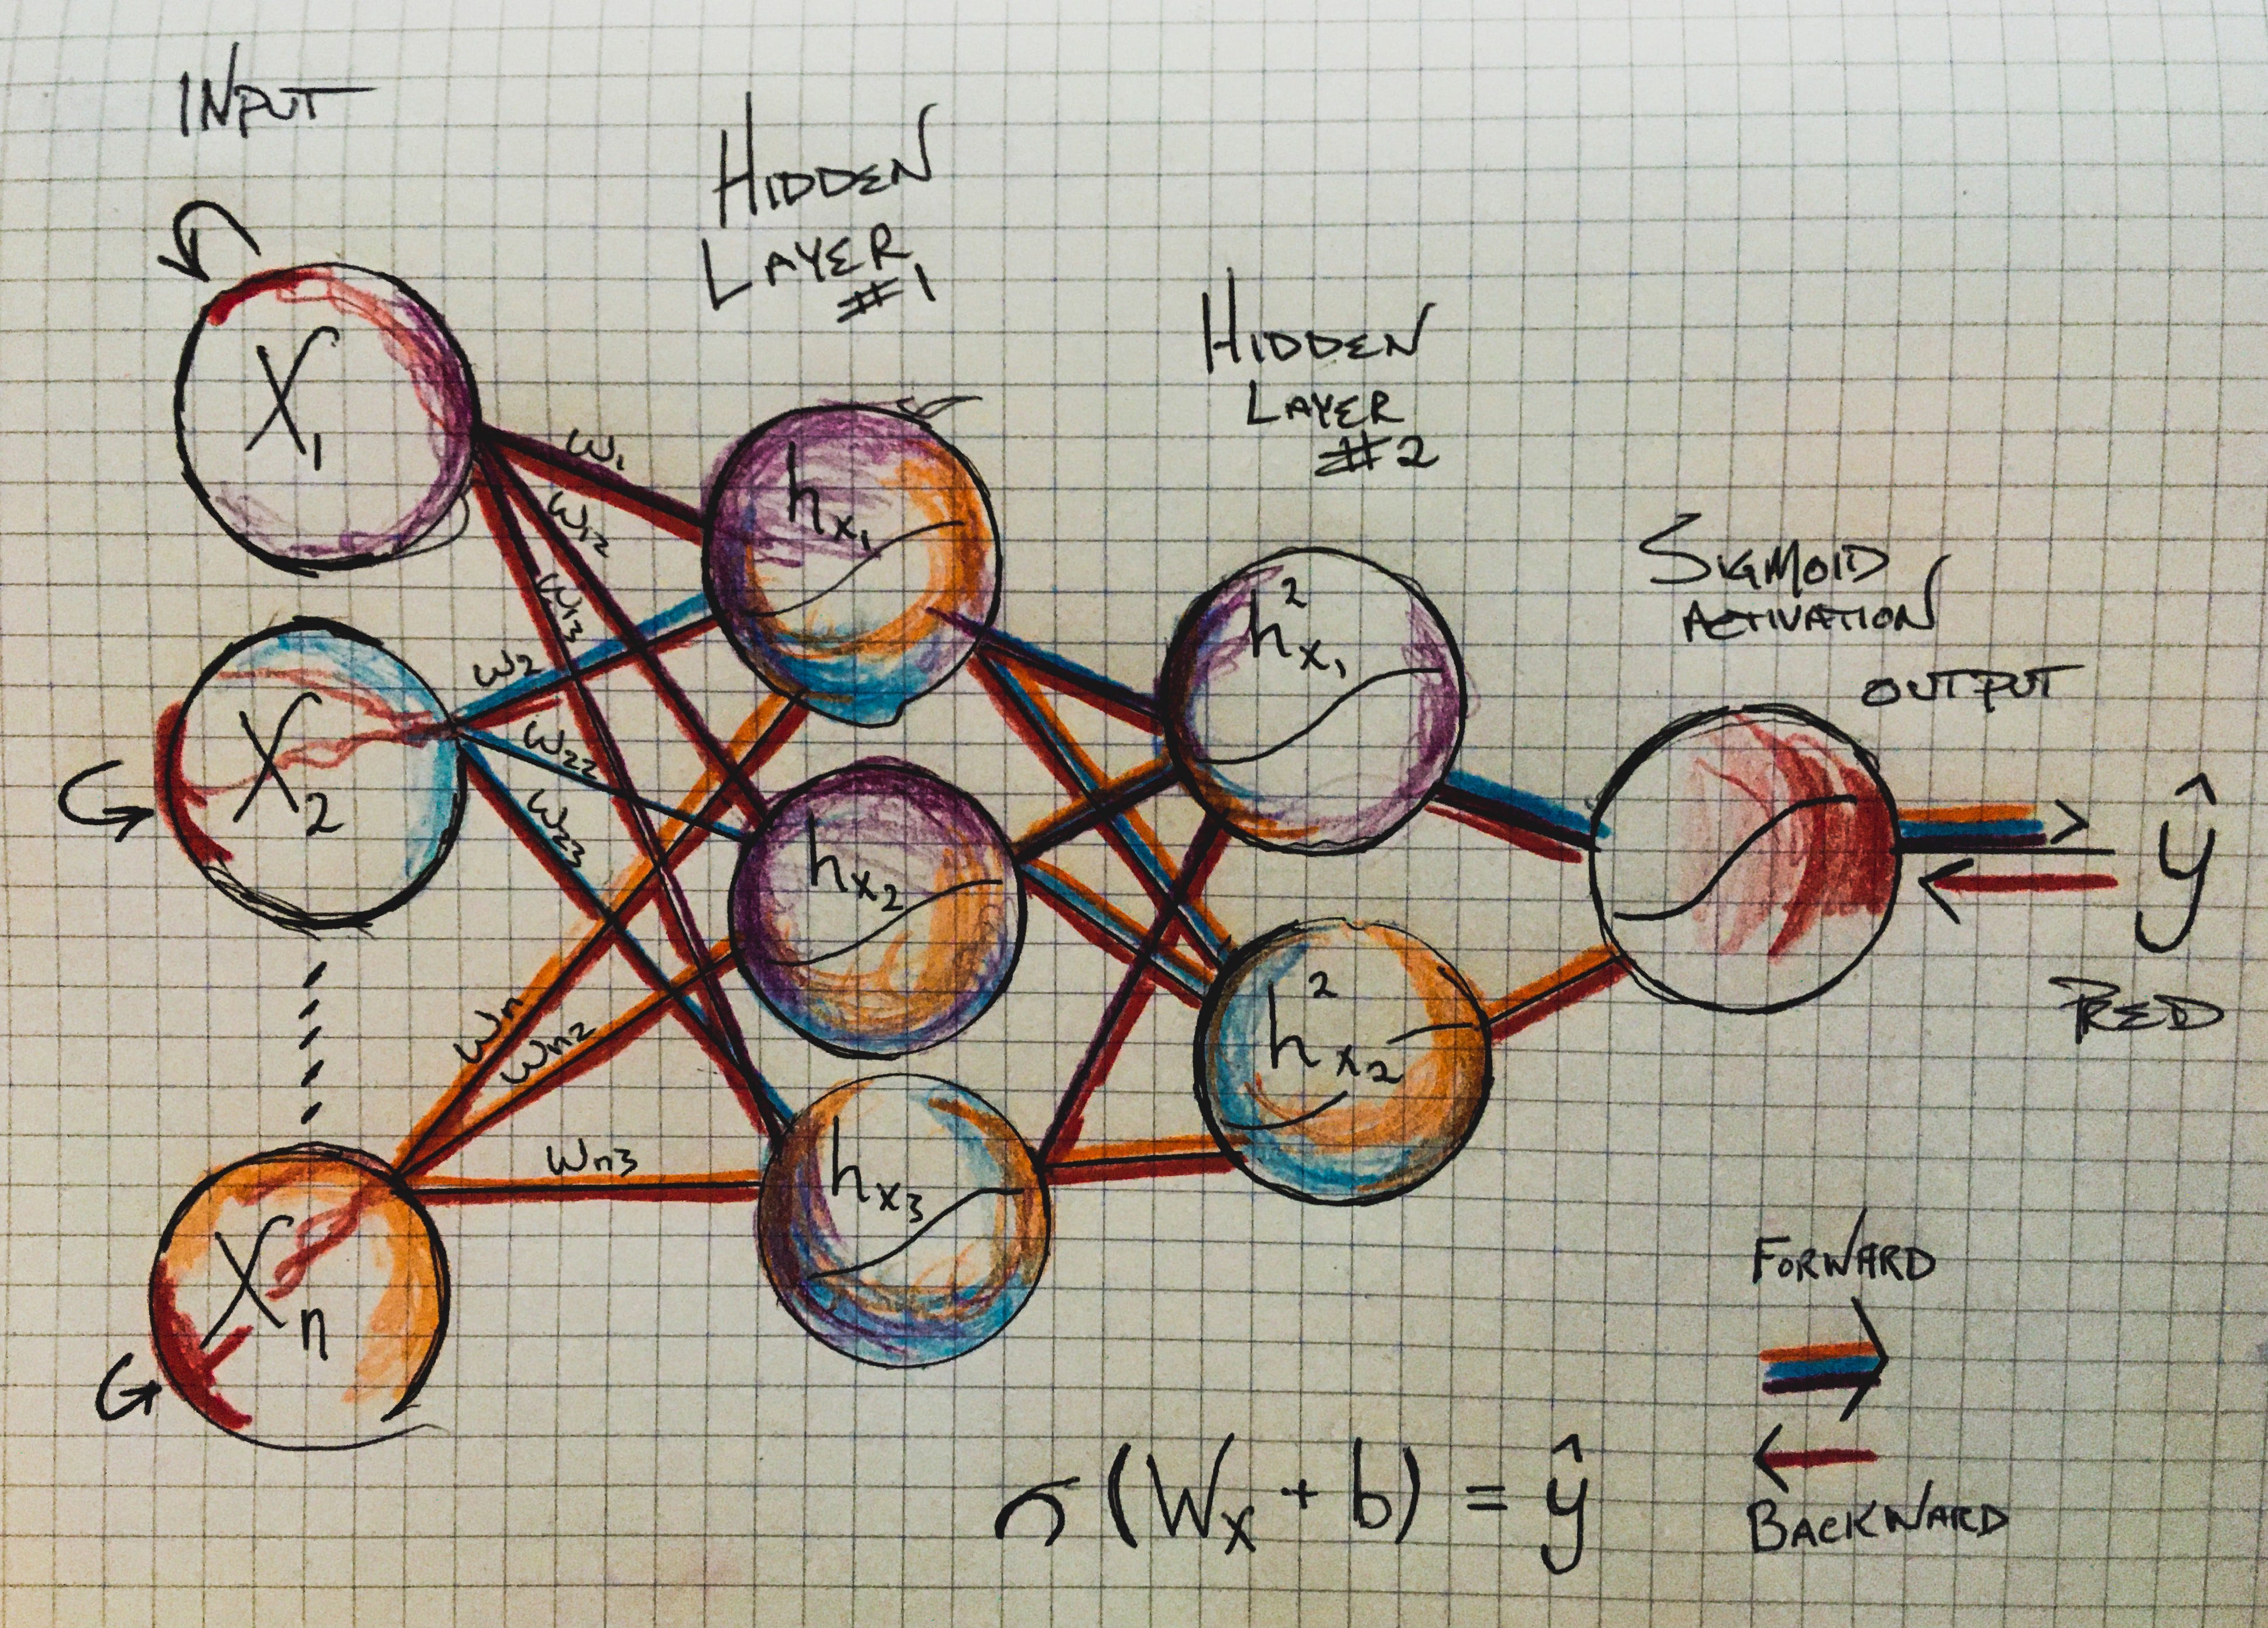
Нейронная сеть состоит из взаимосвязанных нейронов, передающих информацию друг другу, подобно человеческому мозгу. Каждому нейрону присваивается значение. Сеть можно разделить на три основных слоя.
Входной слой
Это начальный слой сети, который принимает входные данные, которые будут использоваться для создания выходных данных.
Скрытые слои
В сети должен быть хотя бы один скрытый слой. Скрытый слой (слои) выполняет вычисления и операции с входными данными для создания чего-то значимого.
Выходной слой
Нейроны в этом слое отображают значимые выходные данные.
Что такое Персептрон?
Персептрон — это алгоритм контролируемого обучения бинарных классификаторов. Этот алгоритм позволяет нейронам изучать и обрабатывать элементы обучающего набора по одному за раз. Персептрон также понимается как искусственный нейрон или блок нейронной сети, который помогает обнаруживать определенные вычисления входных данных в бизнес-аналитике.
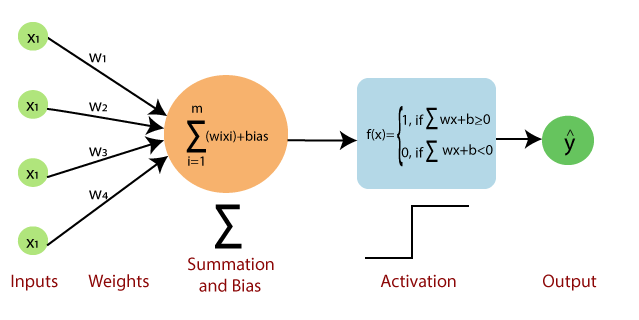
Персептрон состоит из 4 частей
Входное значение или один входной слой: входной слой персептрона состоит из искусственных входных нейронов и передает исходные данные в систему для дальнейшей обработки.
Вес и погрешность:
Вес. Он представляет размер или силу связи между единицами. Если вес от узла 1 к узлу 2 имеет большую величину, то нейрон 1 оказывает более существенное влияние на нейрон.
Смещение: это то же самое, что точка пересечения, добавленная в линейное уравнение. Это дополнительный параметр, в котором задача состоит в том, чтобы изменить выходные данные вместе со взвешенной суммой входных данных для другого нейрона.
Чистая сумма: вычисляет общую сумму.
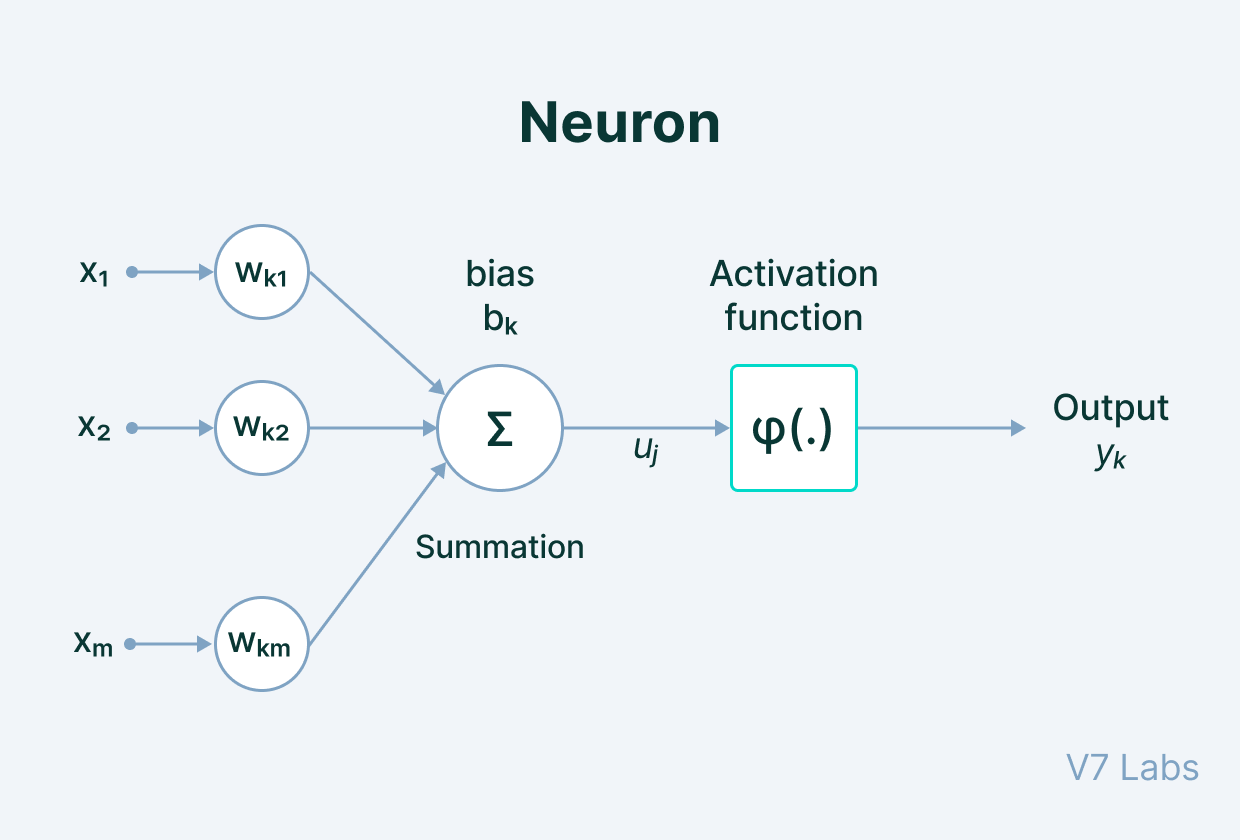
Функция активации: нейрон может быть активирован или нет, определяется функцией активации. Функция активации вычисляет взвешенную сумму и дополнительно добавляет к ней смещение, чтобы получить результат.
Однослойный персептрон
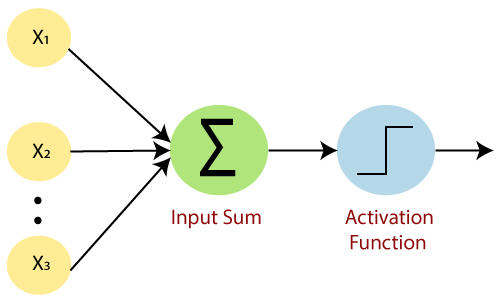
Однослойный персептрон — первая предложенная созданная нейронная модель. Содержимое локальной памяти нейрона состоит из вектора весов. Вычисление однослойного персептрона выполняется по вычислению суммы входного вектора каждого со значением, умноженным на соответствующий элемент вектора весов. Значение, отображаемое на выходе, будет входом функции активации.
Многослойный персептрон
Многослойный персептрон (MLP) — одна из наиболее распространенных моделей нейронных сетей, используемых в области глубокого обучения. Часто называемая «ванильной» нейронной сетью, MLP проще, чем сложные модели сегодняшней эпохи. Однако введенные в нем методы проложили путь к дальнейшему развитию нейронных сетей.
Многослойный персептрон (MLP) используется для различных задач, таких как анализ акций, идентификация изображений, обнаружение спама и прогнозирование результатов голосования на выборах.
Нейронная сеть против глубокого обучения

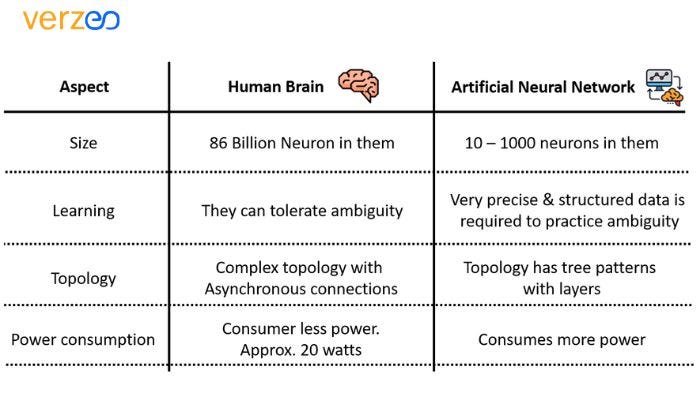
Нейронная сеть против человеческого мозга
Типы нейронных сетей
Этот блог посвящен трем важным типам нейронных сетей, которые составляют основу большинства предварительно обученных моделей глубокого обучения.
- Искусственные нейронные сети (ИНС)
- Сверточные нейронные сети (CNN)
- Рекуррентные нейронные сети (RNN)
Искусственная нейронная сеть
Искусственные нейронные сети (ИНС) — это алгоритмы, основанные на функциях мозга, которые используются для моделирования сложных закономерностей и прогнозирования проблем. Искусственная нейронная сеть (ИНС) — это метод глубокого обучения, возникший на основе концепции биологических нейронных сетей человеческого мозга.
Преимущества искусственных нейронных сетей
ANN предлагает множество ключевых преимуществ, которые делают их особенно подходящими для конкретных задач и ситуаций:
1. ИНС могут изучать и моделировать нелинейные и сложные взаимодействия, что очень важно, поскольку многие отношения между входами и выходами в реальной жизни нелинейны и сложны.
2. ANN могут обобщать. Изучив исходные входные данные и их ассоциации, модель может вывести неизвестные отношения из анонимных данных, что позволит ей обобщать и прогнозировать неизвестные данные.
3. ИНС не накладывает никаких ограничений на входные переменные, в отличие от многих других подходов к прогнозированию (например, как они должны распределяться). Кроме того, многочисленные исследования показали, что ИНС могут лучше имитировать гетероскедастичность или данные с высокой волатильностью и непостоянной дисперсией благодаря их способности обнаруживать скрытые корреляции в данных без наложения каких-либо заранее заданных ассоциаций. Это особенно полезно при прогнозировании финансовых временных рядов (например, цен на акции) при значительной волатильности данных.
Сверточная нейронная сеть
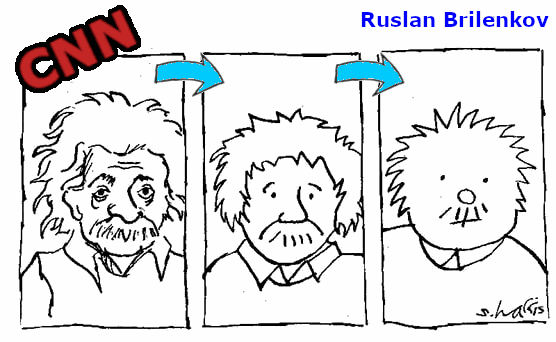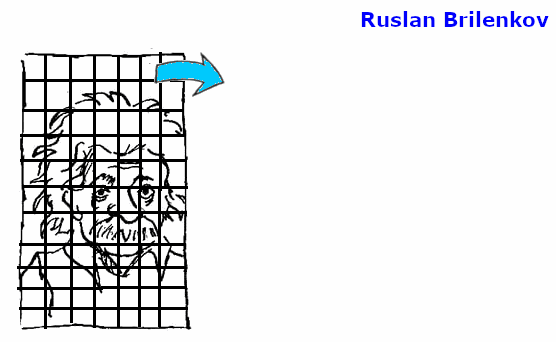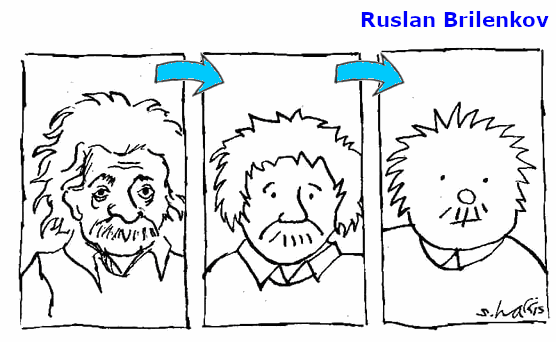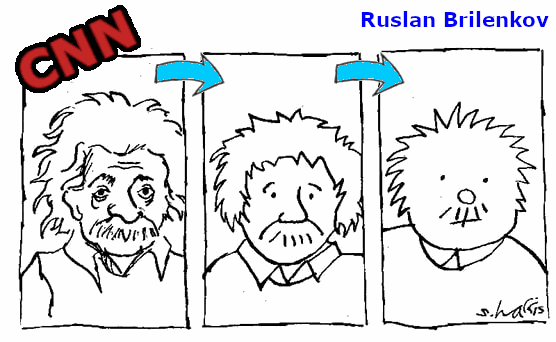
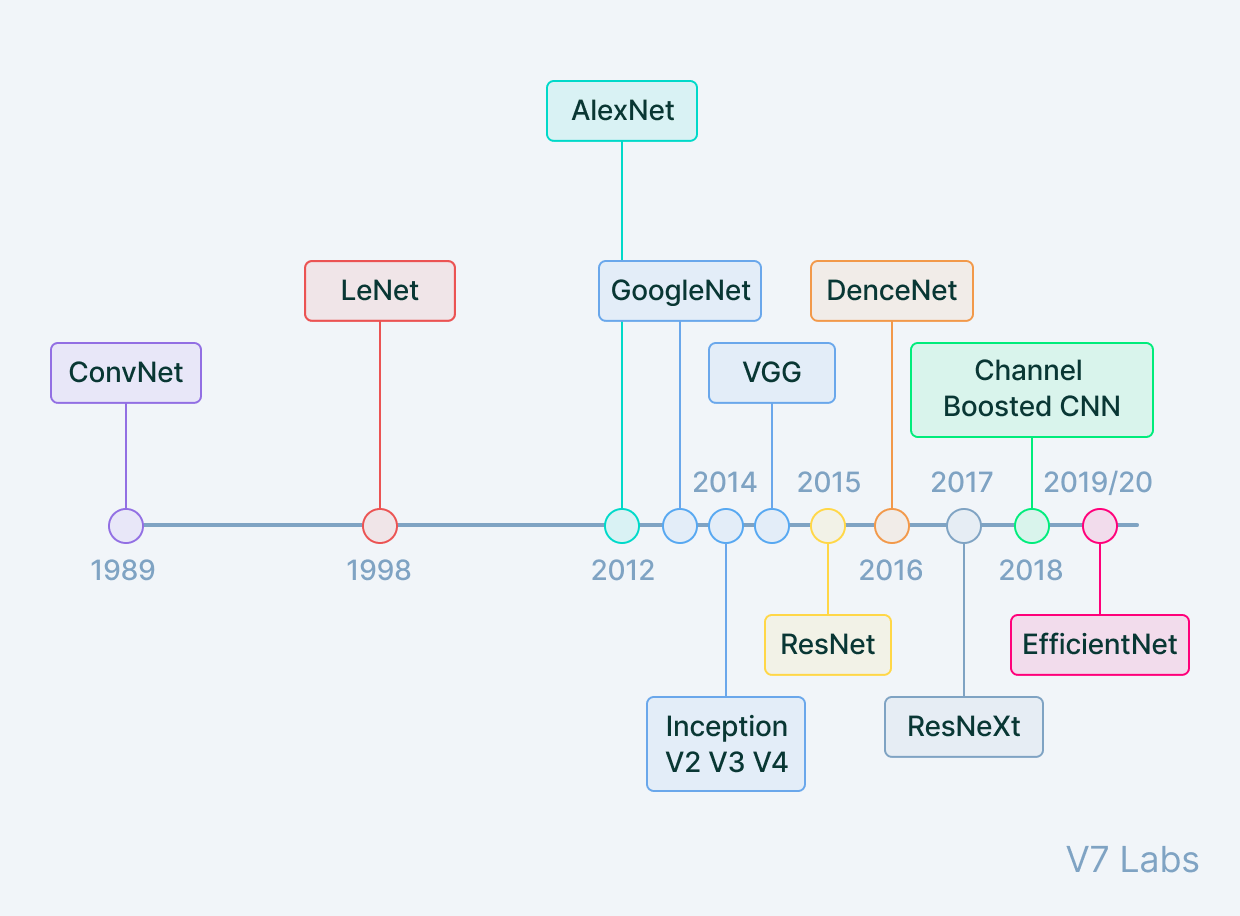
Сверточная нейронная сеть (также известная как ConvNet или CNN) — это тип нейронной сети с прямой связью, используемый в таких задачах, как анализ изображений, обработка естественного языка и другие сложные задачи классификации изображений.
Базовая архитектура
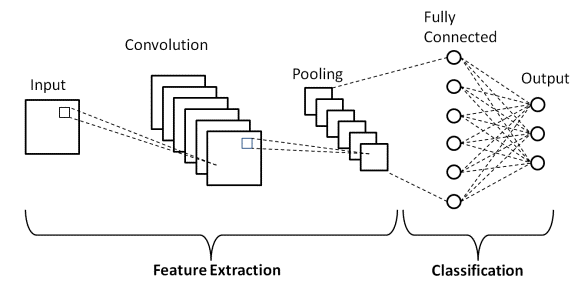
Архитектура CNN состоит из двух основных частей.
Инструмент свертки, который разделяет и идентифицирует различные элементы изображения для анализа в процессе, называемом извлечением признаков.
Полносвязный слой, который использует выходные данные процесса свертки и предсказывает класс изображения на основе признаков, извлеченных на предыдущих этапах.
1. Сверточный слой
Этот слой является первым слоем, который используется для извлечения различных функций из входных изображений. В этом слое выполняется математическая операция свертки между входным изображением и фильтром определенного размера MxM. При перемещении фильтра по входному изображению скалярное произведение берется между фильтром и частями входного изображения относительно размера фильтра (MxM).
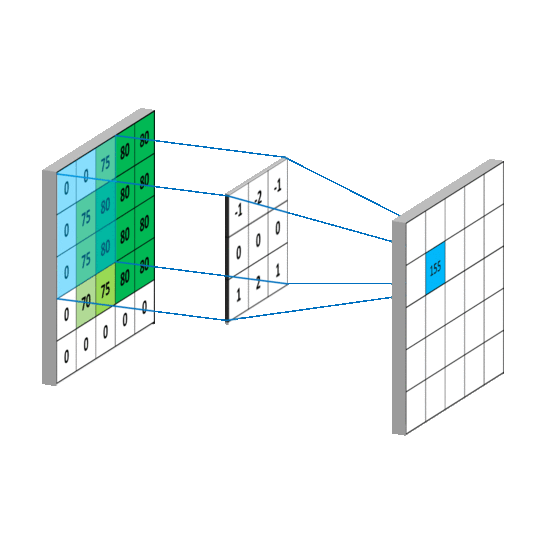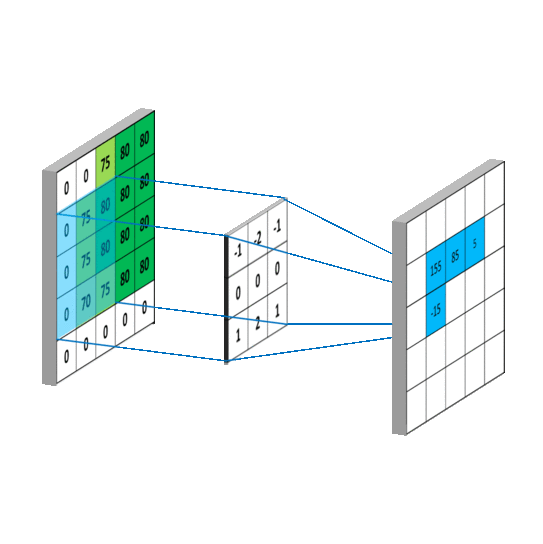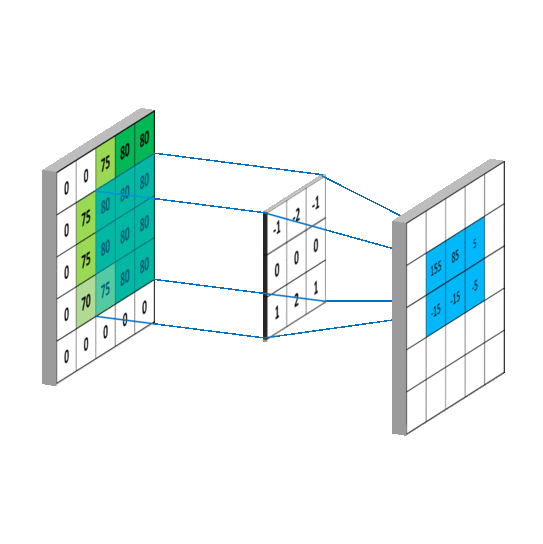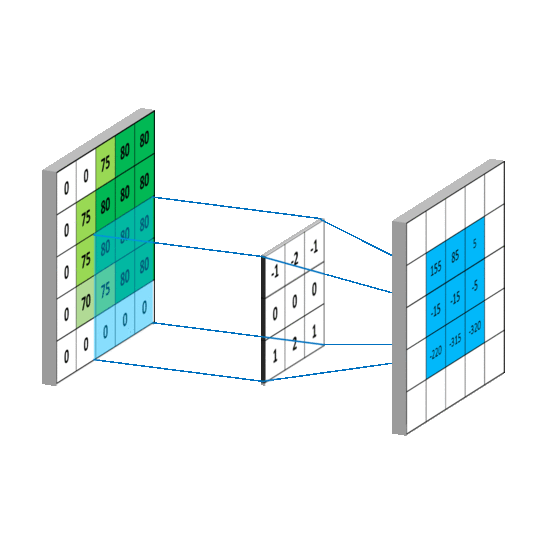
Выходные данные называются картой объектов, которая дает нам информацию об изображении, такую как углы и края. Позже эта карта объектов передается другим слоям для изучения некоторых других особенностей входного изображения.
2. Слой объединения
В большинстве случаев за сверточным слоем следует объединяющий слой. Основная цель этого слоя — уменьшить размер свернутой карты объектов для снижения вычислительных затрат. Это достигается за счет уменьшения связей между слоями и независимой работы с каждой картой объектов. В зависимости от используемого метода существует несколько типов операций объединения.

В Max Pooling самый большой элемент берется из карты объектов. Пул среднего значения вычисляет среднее значение элементов в разделе изображения предопределенного размера. Общая сумма элементов в предопределенном разделе вычисляется в Sum Pooling. Слой пула обычно служит мостом между сверточным слоем и уровнем FC.
3. Полностью связанный слой
Слой Fully Connected (FC) состоит из весов и смещений вместе с нейронами и используется для соединения нейронов между двумя разными слоями. Эти слои обычно размещаются перед выходным слоем и образуют несколько последних слоев архитектуры CNN.
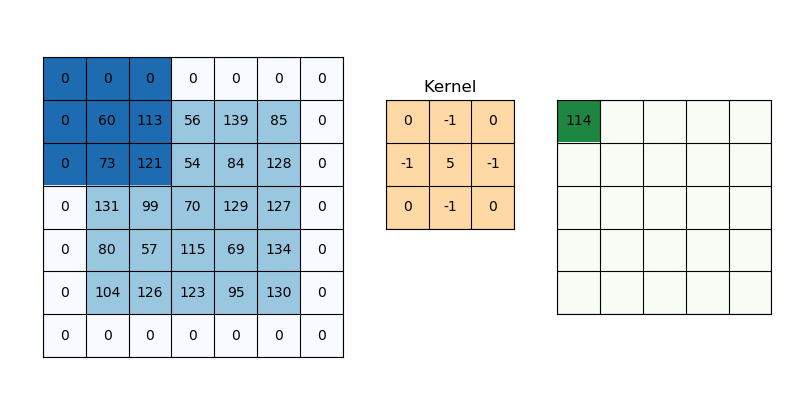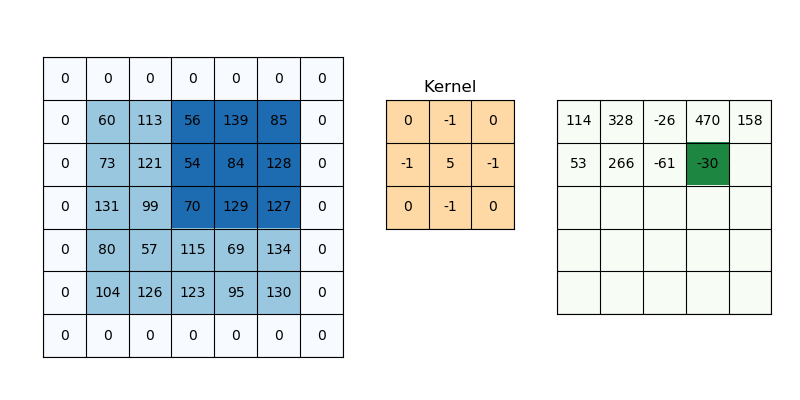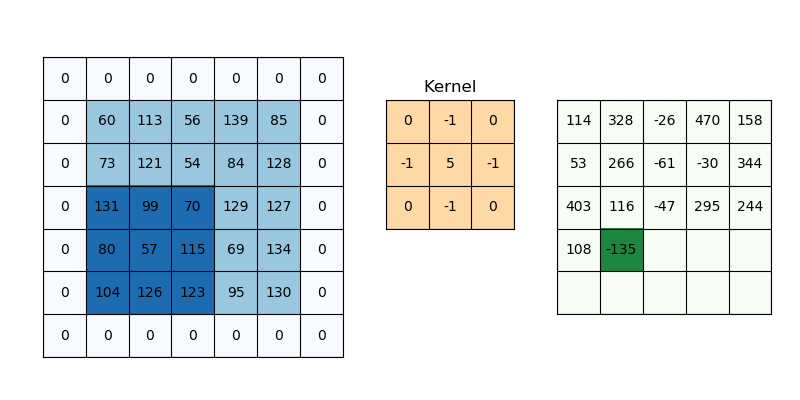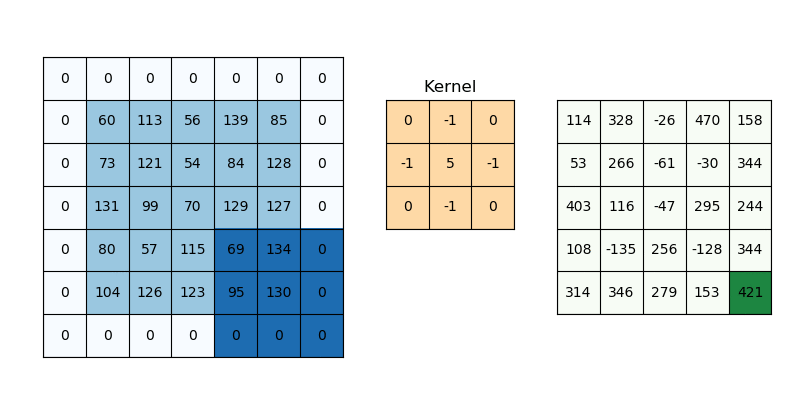
При этом входное изображение из предыдущих слоев сглаживается и подается на слой FC. Затем сглаженный вектор проходит еще несколько слоев FC, где обычно выполняются операции математической функции. На этом этапе начинается процесс классификации.
4. Отсев
Обычно, когда все функции связаны со слоем FC, это может привести к переобучению в наборе обучающих данных. Переобучение происходит, когда конкретная модель так хорошо работает с обучающими данными, что негативно влияет на производительность модели при использовании с новыми данными.
Чтобы преодолеть эту проблему, используется слой отсева, при котором несколько нейронов удаляются из нейронной сети в процессе обучения, что приводит к уменьшению размера модели. При прохождении отсева 0,3 30% узлов случайным образом выпадают из нейронной сети.
5. Функции активации
Наконец, одним из наиболее важных параметров модели CNN является функция активации. Они используются для изучения и аппроксимации любых непрерывных и сложных отношений между переменными сети. Проще говоря, он решает, какая информация модели должна передаваться в прямом направлении, а какая не должна передаваться в конце сети.
Рекуррентная нейронная сеть
Базовая архитектура глубокого обучения имеет фиксированный размер входных данных, и это действует как блокировщик в сценариях, где размер входных данных не является фиксированным. Кроме того, решения, принимаемые моделью, основывались на текущем входе без памяти о прошлом.
Рекуррентные нейронные сети очень хорошо работают с последовательностями данных в качестве входных данных. Его функциональность можно увидеть в решении задач NLP, таких как анализ настроений, спам-фильтры, проблемы временных рядов, такие как прогнозирование продаж, прогнозирование фондового рынка и т. д.

Рекуррентные нейронные сети способны запоминать то, чему они научились в прошлом, и применять это в будущих прогнозах.
Вход находится в форме последовательных данных, которые подаются в RNN, которая имеет скрытое внутреннее состояние, которое обновляется каждый раз, когда она считывает следующую последовательность данных на входе.
Внутреннее скрытое состояние будет возвращено модели. RNN выдает некоторый результат для каждой временной метки.
Преимущества рекуррентной нейронной сети
- RNN может обрабатывать входные данные любой длины.
- Модель RNN смоделирована так, чтобы запоминать каждую информацию в течение всего времени, что очень полезно в любом предсказателе временных рядов.
- Даже если размер ввода больше, размер модели не увеличивается.
- Веса могут быть разделены между временными шагами.
- RNN может использовать свою внутреннюю память для обработки произвольной серии входных данных, чего нельзя сказать о нейронных сетях с прямой связью.
Заключение
Нейронная сеть — обширная тема. Многие специалисты по данным сосредоточены исключительно на методах нейронных сетей.
На этом занятии мы практиковали только вводные концепции. Нейронные сети имеют гораздо более продвинутые методы. Есть намного больше тем, чем эти темы.
- Нейронные сети особенно хорошо работают с некоторыми конкретными классами задач, такими как распознавание изображений.
- Алгоритмы нейронной сети очень интенсивны в вычислениях. Они требуют высокоэффективных вычислительных машин. Большие наборы данных требуют значительного количества времени выполнения на R. Нам нужно попробовать разные типы опций и пакетов.
- В настоящее время ведется много интересных исследований, связанных с нейронными сетями.
Я надеюсь, что всем вам нравится этот блог. Если вы хотите рассказать больше об этом блоге, если вы хотите связаться и, кстати, вы знаете хороший анекдот, вы можете связаться со мной в LinkedIn.
Спасибо за чтение!😄 🙌





