

Область машинного обучения и искусственного интеллекта стремительно развивалась за последние 10 лет. Доступная вычислительная мощность, все большие и большие наборы обучающих данных и работа с открытым исходным кодом — вот несколько причин такого роста. Экспоненциальный рост звучит хорошо, но он также имеет много недостатков. Наша навязчивая идея «чем больше, тем лучше» каким-то образом работала на нас, но мы начали понимать, что нам еще предстоит пройти долгий путь. В этой статье рассматриваются другие аспекты моделей машинного обучения, где мы попытаемся рассмотреть их с точки зрения реальной жизни, а также то, что следует учитывать при создании моделей машинного обучения, а не просто метрик.
1. Предвзятость
Если вы инженер по машинному обучению, есть большая вероятность, что вы даже не рассматриваете это как часть своего конвейера машинного обучения. Учитывали ли вы, что модель, которую вы строите, может быть смещена в сторону какого-то пола или определенных групп?
Что такое предвзятость?
Согласно Википедии, предвзятость «описывает систематические и повторяющиеся ошибки в компьютерной системе, которые приводят к несправедливым результатам, таким как предпочтение одной произвольной группы пользователей над другими».
Одним из центральных компонентов любой модели машинного обучения являются обучающие данные, на которых она обучается. Ну и что, если данные обучения в чем-то ошибочны.
Предлагаете ли вы конечным пользователям предвзятую модель?
Модель машинного обучения, обученная на ошибочных данных, просто усиливает эффект смещения в реальном мире. Просто помните, что люди предвзяты, и это повлияет на обучающие данные. Если вы не проверяете смещение, результатом, вероятно, будет смещенная модель. Помните известную поговорку о машинном обучении:
Счетчик шагов
- Проверьте обучающие данные на предвзятость. Используйте такие инструменты, как фасеты или любой инструмент исследовательского анализа по вашему выбору.
- Сделайте ваши модели более интерпретируемыми. Если у вас есть некоторая прозрачность в отношении того, как принимаются решения, вы можете заранее определить, существует ли какая-либо предвзятость.
- Максимально разнообразить процесс сбора данных. Например: если вы строите модель ASR и тренируетесь только с мужскими голосами, это не очень хорошо для конечного продукта. Попробуйте придумать несколько примеров из области, в которой вы работаете.
- Подготовьте набор вопросов или контрольных списков при работе с данными. Например: отражают ли эти данные разнообразие конечных пользователей.
Это активная область исследований, и исследователи пытаются ответить на этот вопрос. Вы не хотите создавать продукт или стартап, который в конечном итоге предвзято обслуживает конечных пользователей. Подробное обсуждение выходит за рамки этой записи в блоге, но эта статья служит хорошей отправной точкой.
Документ: Опрос предвзятости и справедливости в машинном обученииg
2. Интерпретируемость
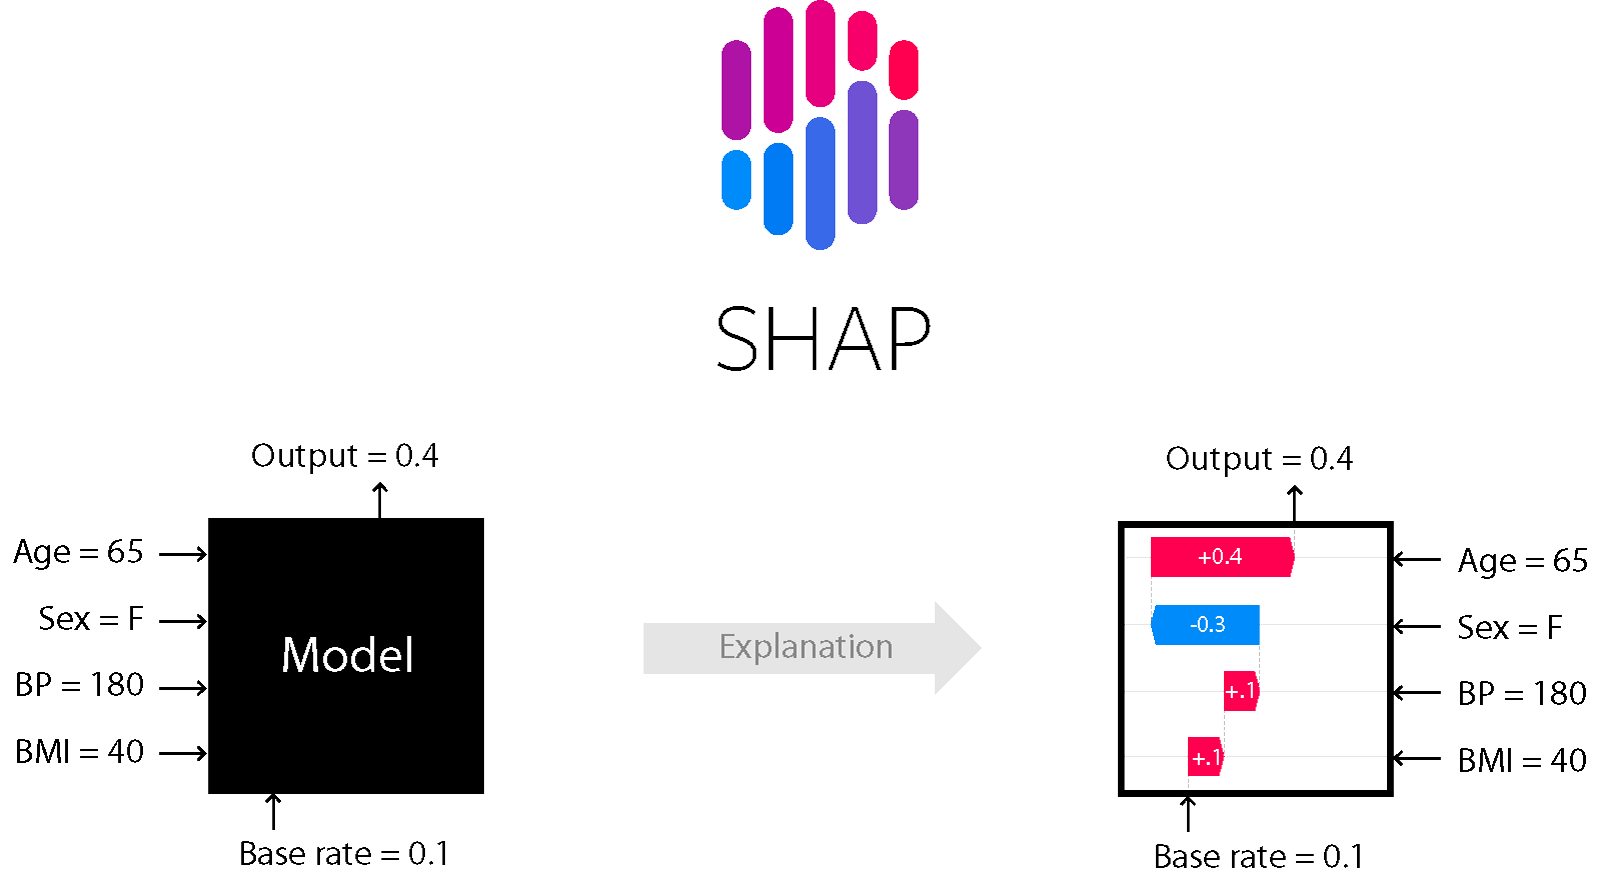
Интерпретируемость означает, что человек может понять, как модель машинного обучения пришла к выводам.
Почему мы должны заботиться?
- Интерпретируемые модели лучше объясняются заинтересованным сторонам, что повышает шансы на одобрение.
- Во многих отраслях существуют строгие правила использования алгоритмов черного ящика, независимо от того, насколько высока точность, вы не сможете получить преимущества из-за ряда ограничений.
- Как мы уже говорили в предыдущем разделе, модели более прозрачны, а выявление предвзятости намного проще.
- Отладочная модель
- Повышение доверия среди конечных пользователей.
Некоторые из самых известных библиотек — это SHAP, LIME и т. д. Это активная область исследований, и по мере повышения адаптивности моделей это будет иметь решающее значение для создания надежных моделей машинного обучения.
3. Углеродный след
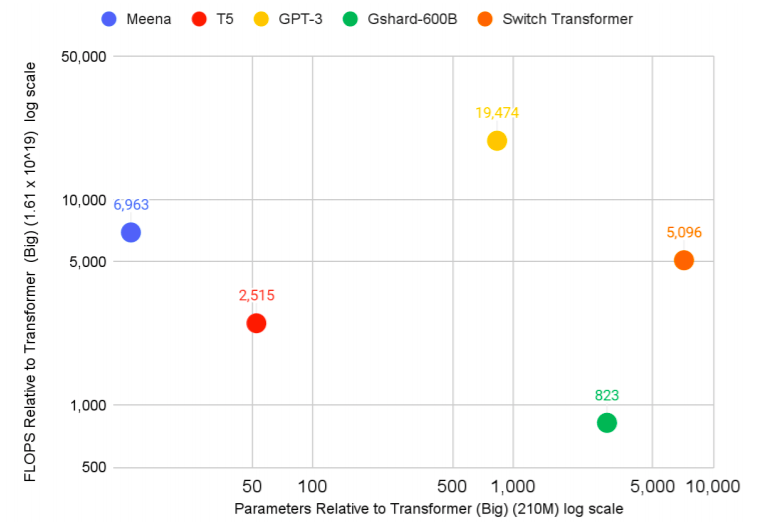
В последнее время мы наблюдаем многократное увеличение потребности в вычислениях для машинного обучения. Большие модели, такие как T5, Meena, GPT-3, обеспечивают более глубокое понимание естественного языка, но за это приходится платить. Эти цифры огромны, и хотя многие из нас не участвуют напрямую в обучении таких огромных моделей, мы должны знать, что это то, что нужно для создания чего-то подобного.
Теперь я вернусь к своей первоначальной точке зрения, что я сказал «чем больше, тем лучше», что дало лучшие результаты, но это не могло быть путем вперед. Если вы хотите исследовать больше.
Статья: Об опасностях стохастических попугаев: могут ли языковые модели быть слишком большими?
Знаете ли вы, согласно MIT Technology Review:
Это то, о чем мы должны подумать как сообщество, например, как воспроизвести и обновить эти модели с минимальным углеродным следом, насколько это возможно.
Что ж, это всего лишь несколько вещей, которые мы должны учитывать при переходе к новому проекту и максимально использовать его. Поскольку подробное обсуждение невозможно в блоге, я хотел бы оставить несколько ссылок ниже, если вам интересно узнать больше об этих темах.
Чтения
Предвзятость и справедливость в ИИ
Закодированное смещение | Netflix: Если вы предпочитаете документальное кино.
Интерпретируемое машинное обучение с помощью Python: если вы найдете бесплатные электронные книги, оставьте комментарий ниже.
Интерпретируемое машинное обучение: руководство по созданию объяснимых моделей черного ящика.





